
XiaoMi-AI文件搜索系统
World File Search System语言

语言对生物多样性很重要 - 肯特学术存储库
Robert D. Fish(R.Fish@imperial.ac.uk)隶属于杜勒尔保护与生态研究所,位于肯特大学,英国坎特伯雷,英国坎特伯雷和英国伦敦帝国学院的环境政策中心,在英国伦敦,英国,英国伦敦。 Gail E. Austen,Jacob W. Bentley,Jessica C. Fisher,Phoebe R. Bentley和Zoe G. Davies(Z.G.Davies@kent.ac.uk)隶属于迪尔雷尔保护与生态研究所,位于肯特大学,位于肯特大学,位于肯特大学的英国坎特伯里大学,在英国,英国,英国国王。 马丁·达利默(Martin Dallimer)隶属于可持续发展研究所,地球与环境学院,利兹大学,英国利兹大学,英国,英国和环境政策中心,伦敦帝国学院,英国伦敦伦敦帝国学院。 Katherine N. Irvine隶属于英国苏格兰阿伯丁市詹姆斯·赫顿学院的社会,经济和地理科学系。 Maximilian Nawrath隶属于肯特大学的杜雷尔保护与生态研究所,英国坎特伯雷,英国坎特伯雷,挪威奥斯陆的挪威水研究所。Robert D. Fish(R.Fish@imperial.ac.uk)隶属于杜勒尔保护与生态研究所,位于肯特大学,英国坎特伯雷,英国坎特伯雷和英国伦敦帝国学院的环境政策中心,在英国伦敦,英国,英国伦敦。Gail E. Austen,Jacob W. Bentley,Jessica C. Fisher,Phoebe R. Bentley和Zoe G. Davies(Z.G.Davies@kent.ac.uk)隶属于迪尔雷尔保护与生态研究所,位于肯特大学,位于肯特大学,位于肯特大学的英国坎特伯里大学,在英国,英国,英国国王。马丁·达利默(Martin Dallimer)隶属于可持续发展研究所,地球与环境学院,利兹大学,英国利兹大学,英国,英国和环境政策中心,伦敦帝国学院,英国伦敦伦敦帝国学院。Katherine N. Irvine隶属于英国苏格兰阿伯丁市詹姆斯·赫顿学院的社会,经济和地理科学系。Maximilian Nawrath隶属于肯特大学的杜雷尔保护与生态研究所,英国坎特伯雷,英国坎特伯雷,挪威奥斯陆的挪威水研究所。
培训大语言模型
培训大语言模型(LLM)已成为人工智能进展的核心,数据集,培训前和训练后方法在其性能和可扩展性方面扮演着互补的角色。此博士学位课程探讨了训练这些模型的关键阶段,并强调了数据对下游任务中模型性能的影响。学生将通过全面研究数据集构建,优化技术,缩放定律,培训前策略,合成数据生成以及培训后的改进(例如,进行微调和对齐方式),通过全面的研究构建LLM的理论和实践。该课程将结合理论指导与动手实验相结合。学生将洞悉:##创建高质量,多样化和有效数据集的原则和方法。##¢优化策略,用于大规模模型培训,包括计算效率。##经验缩放定律及其对模型大小和数据集大小的影响。#¢利用合成数据及其在改善概括和鲁棒性中的作用。##训练技术,例如人类反馈(RLHF)的增强学习以及与期望的结果结合。
调查机器学习和自然语言处理技术用于检测饮食失调:系统文献评论
自然语言处理(NLP)和机器学习(ML)领域的最新发展已显示自动文本处理的显着改进。同时,人类语言的表达在发现心理健康问题中起着核心作用。虽然口语在接受患者的访谈中被隐式评估,但书面语言也可以为临床专业人员提供有趣的见解。现有的工作中经常研究心理健康问题,例如抑郁或焦虑。然而,还在研究饮食失调的诊断如何从这些新技术中受益。在本文中,我们介绍了该领域最新研究的系统概述。Our investigation encompasses four key areas: (a) an analysis of the metadata from published papers, (b) an examination of the sizes and speci fi c topics of the datasets employed, (c) a review of the application of machine learning techniques in detecting eating disorders from text, and fi nally (d) an evaluation of the models used, focusing on their performance, limitations, and the potential risks associated with current methodologies.
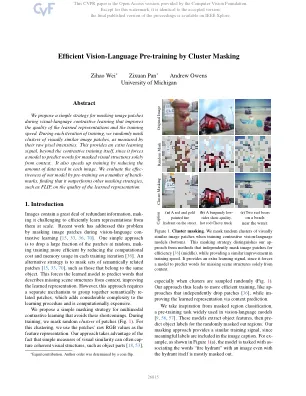
通过群集掩模的有效视力语言预训练
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],

使用TF-IDF技术在阿拉伯社交媒体中进行进攻性语言检测
摘要。我们的生活现在围绕社会交流,并且由于阿拉伯文本非常复杂并且包含了许多方言,因此在阿拉伯社交媒体上很难识别出令人反感的语言。本文研究了机器学习模型的实施。使用了选择的分类器,包括决策树,支持向量机,随机森林和逻辑回归。在实验中使用了包含4505个推文的“ ARCYBC”数据集,以评估机器学习模型的性能。根据实验的结果,使用更多运行可以增强机器学习模型的性能,尤其是在精度和召回率方面。随着更多的运行,决策树(DT)和随机森林(RF)分类器显示出更好的回忆和精度,但是DT分类器显示出更好的精度。
开发基于精细语言模型的瑞典法律判断的语义搜索工具
大型语言模型(LLMS)是非常大的深度学习模型,可根据大量数据进行重新训练。是句子的双向编码器表示,来自变形金刚(SBERT)的句子是基于变压器的DeNoising AutoCoder(TSDAE),生成查询网络(GENQ)和生成假伪标记(GPL)的改编。本论文项目旨在为瑞典法律判断开发语义搜索工具,以克服法律文件检索中传统关键字搜索的局限性。为此,使用高级培训方法(例如TSDAE,GENQ和GPL的改编),通过利用自然语言处理(NLP)(NLP)(NLP)(NLP)和精细的LLM来开发一种善于理解法律语言的语义细微差别的模型。要从未标记的数据中生成标记的数据,对其进行微调后使用了GPT3.5模型。使用生成模型的使用标记数据的生成对于该项目有效训练Sbert至关重要。已经评估了搜索工具。评估表明,搜索工具可以根据语义查询准确检索相关文档,并同样提高法律研究的效率和准确性。genq已被证明是此用例的最有效的训练方法。
Megascale:将大型语言模型培训扩展到10,000多个GPU
Qi Huang 1 Yangrui Chen 1 Zhi Zhang 1 Yanghua Peng 1 Xiang Li 1 Cong Xie 1 Shibiao Nong 1 Yulu Jia 1 Sun He 1 Hongmin Chen 1 Zhihao Bai 1 Qi Hou 1 Shipeng Yan 1 Ding Zhou 1 Yiyao Sheng 1 Zhuo Jiang 1 Haohan Xu 1 Haoran Wei 1 Zhang Zhang 1 Pengfei Nie 1 Leqi Zou 1 Sida Zhao 1 Liang Xiang 1 Zherui Liu 1 Zhe Li 1 Xiaoying Jia 1 Jianxi Ye 1 Xin Jin 2 , Xin Liu 1

可解释的AI(XAI)和大型语言模型(LLM)
➢这是一个欺骗深神经网络(DNN)的实验:在第二和第四张图像中,工程师仅保留了系统用于识别吉他和企鹅的系统的元素,并更改了其余的所有内容,以使系统仍然像吉他和企鹅一样“看到”他们。➢Goodfellow等人的作品。(2014)从普遍的扰动开始打开了进一步发展的大门(Moosavi-Dezfooli等人。2017)最近的一个像素攻击,该攻击显示了如何通过在输入图像中更改一个像素来欺骗神经网络。笔记本在这里一张像素攻击原始纸

关于单词顺序和方面的跨语言,基于语料库的定量建模
人类语言最引人注目的特征之一是它们的极端变化。更加惊人的是,在统治其形式和功能的强烈代表性和认知规律的明显变化背后的存在:语言普遍性。我们在这里讨论我们小组的一些最新工作,其中大规模,数据密集型计算建模技术用于解决有关语言规律性的基本语言问题。在单词顺序区域中,我们在此处报告工作,这些工作利用大量单语和平行语料库数据来开发名词短语(通用20)和一般结构最小化原则的内部结构的计算模型。在事件持续时间的领域,我们报告的工作利用了深厚的相似性和表面差异来开发真正的跨语言自然语言处理工具。

大型语言模型策略适应到处驾驶
将驾驶行为适应新的环境,库斯和法律是自主驾驶中的一个长期问题,排除了澳大利亚车辆(AVS)的广泛部署。在本文中,我们提出了LLADA,这是一种简单而强大的工具,它使人类驾驶员和自动驾驶汽车都可以通过调整其任务和动作计划来在新的地方进行访问规则,从而在任何地方开车。llada通过利用大型语言模型(LLMS)在解释本地驾驶员手册中的流量规则方面的令人印象深刻的零弹性可推广性来实现这一目标。通过广泛的用户研究,我们表明LLADA的说明可用于消除野外野外未受的情况。我们还展示了LLADA在现实世界数据集中适应AV运动计划策略的能力; Llada优于我们所有指标的基线计划。请查看我们的网站以获取更多详细信息:Llada。