
XiaoMi-AI文件搜索系统
World File Search SystemAutoma
自动化Abercrombie:机器学习商标...
商标法保护标记,以使公司能够向消费者发出产品的质量。为了获得保护,商标必须能够识别和区分货物。美国法院通常会在“独特性”(称为Abercrombie Spectrum)上找到标记,该标记将标记归类为幻想,任意或暗示性,因此将标记归类为“固有的独特性”,或者是描述性或通用性的,因此并非固有的。本文探讨了是否可以使用当前的自然语言处理技术在Abercrombie频谱上找到商标。在2012年至2019年之间使用约150万个美国商标注册以及220万相关的USPTO办公室操作,该论文提出了一种机器学习模型,该模型了解商标应用程序的语义特征,并预测商标是否本质上是独特的。我们的模型总体上可以预测具有86%精度的商标行动,并且可以确定商标应用程序的子集,在该子集对其独特性的预测中高度确定。我们进一步分析商标应用程序中的哪些功能推动了模型的预测。然后,我们探索方法的实际和规范性含义。在实际层面上,我们概述了一个决策支持系统,该系统可以作为“机器人商标书记员”,协助商标专家确定商标的独特性。这样的系统还可以帮助商标专家了解商标申请的哪些功能对商标的独特性有最大的作用。在理论上,我们讨论了Abercrombie频谱的规范限制,并建议超越Abercrombie,以换取其独特性不确定的商标。我们讨论了法律中的机器学习项目,不仅如何告知我们将来可能自动化的法律制度的各个方面,而且迫使我们解决可能是看不见的规范权衡。


多模态人工智能中的偏见:公平自动招聘的试验台
决策算法在社会中的存在感如今正在迅速增加,同时人们也开始担心其透明度以及这些算法可能成为新的歧视来源。事实上,许多相关的自动化系统已被证明会根据敏感信息做出决策或歧视某些社会群体(例如,某些用于人员识别的生物特征识别系统)。为了研究当前基于异构信息源的多模态算法如何受到数据中的敏感元素和内部偏见的影响,我们提出了一个虚构的自动招聘测试平台:FairCVtest。我们使用一组有意识地以性别和种族偏见进行评分的多模态合成档案来训练自动招聘算法。FairCVtest 展示了此类招聘工具背后的人工智能(AI)从非结构化数据中提取敏感信息并以不良(不公平)的方式将其与数据偏见结合起来的能力。最后,我们列出了最近开发能够从深度学习架构的决策过程中删除敏感信息的技术的列表。我们使用其中一种算法(SensitiveNets)来实验歧视感知学习,以消除我们多模态 AI 框架中的敏感信息。我们的方法和结果展示了如何生成更公平的基于 AI 的工具,特别是更公平的自动招聘系统。


自动威胁检测,反应和道德挑战
1。Introduction................................................................................................. 1

电子商务中的人工智能和自动化
这些相互关联的合同链会给用户带来法律问题和业务挑战。较长的合同链可能会产生尚未解决的法律问题(例如,如果合同链中的上游协议是自主执行的,那么违反该协议会对下游协议产生什么影响?)。无论各方对这种情况的协议是什么,都必须反映在建立区块链及其操作软件的协议中。对客户业务施加的监管要求可能会产生其他法律问题。例如,医疗记录和保险环境中的区块链合同系统必须符合患者隐私保护要求;金融交易及其隐私要求也是如此。
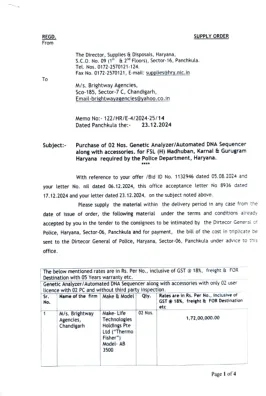
购买02号遗传分析仪/自动化DNA Sequencer以及配件。对于FSL(H)Madhuban,Karnal&Gurugram Haryana,需要P केंदीयलयलय 从教科书中学习任何三首诗。 •做5 ... 一个基于证据的排名,2024 全印度高等教育调查2021-22 KVDRDO生物学节日家庭作业2024年12月 3.0 Ojee的教学大纲 - 2025 b''
1。电气要求:220 V,AC 50Hz。2。基于聚合物的8个具有升级性的毛细血管,具有自动采样板系统的自动DNA分析仪/测序仪,具有6个基于染料或更好的化学。3。CCD或带有固态长寿命激光探测器的最新高级技术摄像头。4。应具有最新版本的设备操作和数据收集软件。供应商/供应商应免费提供所有随后的设备操作和数据收集软件升级,从供应之日起五年。制造商证书/承诺应附有技术规范提供文件。5。应具有最新版本的经过验证的软件,用于碎片尺寸(法医str,简短的串联重复,基于人类的标识),并提供其他两个用户许可证,以及每个LICERNSE的必要硬件,包括网络和连接性。该软件应具有具有广泛安全性的功能,并审核功能支持最新发表的研究论文。6。遗传分析仪应在国际准则(例如DNA分析方法(SWGDAM))等国际准则上进行法医DNA分析验证。7。仪器应为支持所有市售的STR套件的开放平台。供应商/供应商应在这方面提交合格证书。8。y-STR(100个反应)。9。10。对最终用户实验室科学家的现场培训。11。0q&PQ文档。应提供基质标准,聚合物容器,毛细管阵列(36厘米),阳极和阴极缓冲液,去离子甲酰胺,试剂和消耗品和塑料软件等以及Str套件,即常染色体 - STR(200反应)。供应商还应提供交钥匙解决方案,以功能化仪器,但不限于:合适的反振动工作台,微型固定,微型,涡流,合适的可变容量移液,96个井板板板微型中心,合适的容量存储设备,适用于具有4'C温度和-20*C温度范围的PCR套件的合适能力,可用于保持4'C和-20*C温度范围的适用量设备及其最佳性能。完整的智商完成现场验证研究。12。兼容Ontine UPS与一个小时的备份(7 kVa)。13。应提供合适的高质量彩色打印机。
XAI 的符号 AI:评估 LFIT 归纳编程以实现公平且可解释的自动招聘
机器学习方法在生物识别和个人信息处理(例如法医、电子医疗、招聘和电子学习)领域的重要性日益增加。在这些领域,基于机器学习方法构建的系统的白盒(人类可读)解释可能变得至关重要。归纳逻辑编程 (ILP) 是符号 AI 的一个子领域,旨在自动学习有关数据处理的声明性理论。从解释转换中学习 (LFIT) 是一种 ILP 技术,可以学习与给定黑盒系统等同的命题逻辑理论(在特定条件下)。本研究通过检查 LFIT 在特定 AI 应用场景中的可行性,迈出了将准确的声明性解释纳入经典机器学习的通用方法的第一步:基于使用机器学习方法生成的自动工具进行公平招聘,用于对包含软生物特征信息(性别和种族)的简历进行排名。我们展示了 LFIT 对这个特定问题的表达能力,并提出了一个可应用于其他领域的方案。

机器学习Clifford不变的Ade Coxeter元素
摘要。胸肌分割是乳腺磁共振成像(MRI)的各种计算机辅助应用中的关键步骤。由于胸部和乳房区域之间的伪影和同质性,胸肌边界估计并不是一项琐碎的任务。在本文中,提出了一种基于深度学习的全自动分割方法,以准确描述轴向乳房MR图像中的胸肌边界。提出的方法涉及两个主要步骤:胸肌分割和边界估计。对于胸肌分割,基于U-NET结构的模型用于从输入图像中分离胸肌。接下来,通过候选点检测和轮廓分割来估计胸肌边界。使用两个Real-World数据集,我们自己的私人数据集和一个公开可用的数据集对所提出的方法进行了定量评估。第一个数据集包括12名患者乳房MR图像,第二个数据集由80名患者乳房MR图像组成。所提出的方法在第一个数据集中达到了95%的骰子得分,第二个数据集的骰子得分为89%。在大规模定量乳房MR图像上评估该方法的高分割性能表达了其在将来的乳腺癌临床应用中的潜在适用性。