
XiaoMi-AI文件搜索系统
World File Search SystemComple

与OWASP SAMM
https://www.linkedin.com/in/haramhovsep https://www.linkedin/codi fi <https://www.linkedin.com/in/haramhovsep https://www.linkedin/codi fi <

229中心伍兹建筑群 - 资本预算和融资
在过去的五年中,鱼类和野生动物保护系获得了3,430万美元的新研究资金,在弗吉尼亚理工大学的所有部门中,每年的资金持续排名前五。通过合作研究和预防联邦资金的合作研究和预防,该系教师和系学生进行的应用研究直接受益于联邦中游戏和非游戏物种的保护。例如,在过去五年中,授予该部门的研究资金中有82%来自八个联邦机构。最终,该部门的工作使弗吉尼亚州的户外休闲和旅游业受益。2011年美国鱼类和野生动物服务局和美国人口普查局估计,从事野生动植物相关的娱乐活动(包括狩猎,钓鱼和野生动植物观看)的人们每年在弗吉尼亚州的35亿美元上花费35亿美元,而州长办公室估计旅游业收入为2018年的260亿美元。

减少碳的完成技术标准...
2当测量温室气体排放的报告时,通常在二氧化碳等效单位(CO2E)中进行。使用CO2E的使用允许随着时间的推移进行更容易访问的报告和直接跟踪和排放报告。二氧化碳包括京都协议中定义的所有温室气体:二氧化碳,甲烷,一氧化二氮,氢氟化合物,全氟化合物,硫二氟化硫和氮三氟化物。这些温室气体中的每一个都有一个转换因子,如Defra:www.gov.uk/government/publications/greenhouse-gas-reporting-conversion-factors-2020,当使用“ Net net Zero Carbon”时,使用的是CO2和CO2E和CO2E Ensions and NET Zero co2,而不是co2。
提前计划:段落完成任务的自我监督文本计划
尽管上下文化的语言模型最近在各种NLP任务上取得了成功,但语言模型本身仍无法捕获长长的多句文档的文本共同(例如,段落)。人类经常就发言之前就何种方式以及如何发言做出结构性决定。通过这种高级决策和以连贯的方式构建文本的指导性实现被称为计划过程。模型可以在哪里学习这样的高级相干?段落本身包含在这项工作中称为自upervision的各种形式的归纳相干信号,例如句子顺序,局部关键字,修辞结构等。以此为动机,这项工作为新的段落完成任务p ar -c om;在图形中预测蒙版的句子。但是,该任务遭受了预测和选择相对于给定上下文的适当局部内容。为了解决这个问题,我们提出了一个自我监督的文本计划,该计划可以预测首先说出的内容(内容预测),然后使用预测的内容指导验证的语言模型(表面实现)。SSPlanner在自动和人类评估中的段落完成任务上的基线生成模型优于基线生成模型。我们还发现,名词和动词类型的关键字的组合是最有效的内容选择。提供了更多内容关键字,总体发电质量也会提高。
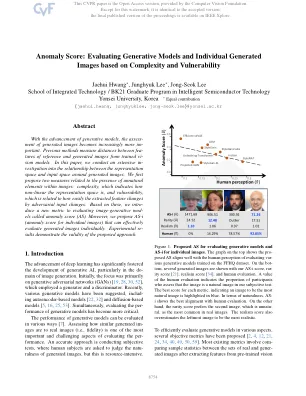
异常得分:根据复杂性和脆弱性评估生成模型和个体生成的图像
随着生成模型的发展,生成图像的评估变得越来越重要。先前的方法测量参考文献和从训练有素的VI-SION模型产生的图像之间的距离。在本文中,我们对表示图像周围的表示空间与输入空间之间的关系进行了广泛的影响。我们首先提出了与图像中不自然元素存在有关的两项措施:复杂性,这表明表示空间的非线性和脆弱性是与对抗性输入变化的轻易变化相关的脆弱性。基于这些,我们为评估称为异常评分的图像生成模式(AS)进行了新的指标。此外,我们提出了可以有效地评估生成的图像的AS-I(单个图像的异常得分)。实验性依据证明了所提出的方法的有效性。


内部研发项目PCSIR实验室综合大楼(KLC)
项目结果W.R.T.国家的社会经济发展:·研究建议在运营过程中没有发出有害的气体,并且使用绿色技术方法,从而消除了臭氧消耗的制冷剂的使用。·,由于设备的成本比传统的制冷和空调设备要小得多,因此当地市场上可用的消费者可以轻松购买。·,由于不需要电力来操作冰箱和空调,因此将免费进行冷却。·,由于在冷却过程中仅消耗LPG,只有高压液化石油气的扩展就会产生冷却效果,因此在吸收周围LPG的热量后,可以将其转化为气态状态,从而可以进一步用于烹饪,汽车燃料或任何其他工业目的。

在复杂的样本设计,复杂的评估结构和复杂的不确定性下的机器学习
摘要。使用统计建模可以从数据得出结论时有两种文化。一个人假设数据是由给定随机数据模型生成的。另一个使用算法模型,并将数据机理视为未知的。统计社区已致力于几乎独家使用数据模型。这一承诺导致了无关紧要的理论,可疑的结论,并阻止了统计学家从事各种有趣的当前问题。在理论和实践中,算法建模在统计数据外迅速发展。 它既可以在大型复杂的数据集上使用,也可以用作更准确,更有信息的替代方法,可在较小的数据集上进行数据建模。 如果我们作为领域的目标是使用数据来解决问题,那么我们需要摆脱对数据模型的独家依赖并采用更多样化的工具。算法建模在统计数据外迅速发展。它既可以在大型复杂的数据集上使用,也可以用作更准确,更有信息的替代方法,可在较小的数据集上进行数据建模。如果我们作为领域的目标是使用数据来解决问题,那么我们需要摆脱对数据模型的独家依赖并采用更多样化的工具。
算法出版物完整书目
-中心 [1662]。-圆形 [1290]。-彩色 [1367]。-组件 [1368]。-连接 [1267]。-共识 [4]。-收缩类型 [1766]。-覆盖范围 [66]。-切割 [541]。-D [91]。-可诊断性 [2057]。-距离遗传 [1350]。-电解质 [1368]。-epf [1290]。-进化 [1389]。-克 [46]。-图表 [897]。-即时 [2117]。-学习 [690]。-有限 [594]。 -均值 [1034, 1741, 1376, 1271, 687, 1301, 1105, 1508, 1715, 890, 2038]。-中位数 [1389]。-Medoids [921]。-mer [1405]。-模型 [1620]。-多重背包 [1944]。-NN [1127, 727]。-非扩张 [1493]。-范数 [1558, 1930]。-操作 [1422]。-OPT [1210]。-顺序 [1162]。-帕累托 [2029]。-分部 [767]。-路径 [1652]。-排列 [1422]。-玩家 [1263]。-适当的 [1576]。 -拼图 [277]。-精炼 [1052]。-细化 [73]。-圆形 [98]。-SAT [1250]。-分离 [1707]。-稳定 [1909]。-子图 [541]。-树 [1848]。-元组 [536]。-宽度 [974]。