
XiaoMi-AI文件搜索系统
World File Search SystemFine
使用交叉注意信号对大型语言模型进行微调模型的一种自我监督的强化学习方法
我们为不依赖于人类反馈的大型语言模型(LLMS)提出了一种新颖的增强学习(RL)框架。相反,我们的方法使用模型本身中的交叉注意信号来获得自我监督的奖励,从而指导对模型策略的迭代微调。通过分析模型在生成过程中如何“参加”输入提示,我们构建了及时的覆盖,重点和连贯性的度量。然后,我们使用这些措施来对候选响应进行排名或评分,提供了奖励信号,鼓励模型产生良好的一致,主题文本。在与标准策略梯度方法的经验比较和合成偏好模型的RL微调中,我们的方法在非RL基线的迅速相关性和一致性方面显示出显着的提高。虽然它尚未与完全监督的RLHF系统的性能相匹配,但它突出了使用最小的人类标记来扩展对齐的重要方向。我们提供了详细的分析,讨论潜在的局限性,并概述了将基于跨注意的信号与较少人类反馈相结合的未来工作。

Berezinskii-Kosterlitz的渐近自由 - 无需使用Qubit正则化的微调
我们提出了一个二维硬核环路模型,是一种在Berezinskii-kosterlitz-无用的过渡时期出现的渐近自由质量连续性量子场理论的一种方式。无需微调,我们的模型可以在接近相变时在大规模阶段重现经典晶格XY模型的通用级尺度函数。这是通过在热力学极限下降低回路配置空间中的fock-vacuum位点的散发性来实现的。与传统的XY模型相比,在Berezinskii-Kosterlitz上的某些通用量在我们的模型中显示出较小的有限尺寸效应。我们的模型是欧几里得时空中渐近自由质量量子场理论的Qubit正则化的一个典型例子,并有助于了解如何在不进行微调的情况下作为分离的固定点上的相关扰动而出现渐近自由。

通过粗到精特征自适应实现跨域目标检测
近年来,基于深度学习的目标检测取得了长足的进步。然而,由于域转移问题,将现成的检测器应用于看不见的域会导致性能大幅下降。为了解决这个问题,本文提出了一种新的由粗到细的特征自适应方法用于跨域目标检测。在粗粒度阶段,与文献中使用的粗糙的图像级或实例级特征对齐不同,采用注意机制提取前景区域,并通过在公共特征空间中多层对抗学习根据其边缘分布进行对齐。在细粒度阶段,我们通过最小化来自不同域但属于同一类别的全局原型的距离来进行前景的条件分布对齐。由于这种由粗到细的特征自适应,前景区域中的领域知识可以得到有效的迁移。在各种跨域检测场景中进行了大量的实验。结果是最先进的,证明了所提出方法的广泛适用性和有效性。
开发基于精细语言模型的瑞典法律判断的语义搜索工具
大型语言模型(LLMS)是非常大的深度学习模型,可根据大量数据进行重新训练。是句子的双向编码器表示,来自变形金刚(SBERT)的句子是基于变压器的DeNoising AutoCoder(TSDAE),生成查询网络(GENQ)和生成假伪标记(GPL)的改编。本论文项目旨在为瑞典法律判断开发语义搜索工具,以克服法律文件检索中传统关键字搜索的局限性。为此,使用高级培训方法(例如TSDAE,GENQ和GPL的改编),通过利用自然语言处理(NLP)(NLP)(NLP)(NLP)和精细的LLM来开发一种善于理解法律语言的语义细微差别的模型。要从未标记的数据中生成标记的数据,对其进行微调后使用了GPT3.5模型。使用生成模型的使用标记数据的生成对于该项目有效训练Sbert至关重要。已经评估了搜索工具。评估表明,搜索工具可以根据语义查询准确检索相关文档,并同样提高法律研究的效率和准确性。genq已被证明是此用例的最有效的训练方法。
黑洞信息之谜与量子德菲内蒂定理
摘要:黑洞信息之谜源于广义相对论与量子理论对黑洞辐射性质的结论存在差异。根据霍金最初的论证,辐射是热的,因此其熵会随着黑洞的蒸发而单调增加。相反,由于量子理论中时间演化的可逆性,辐射熵应该在一定时间后开始减小,正如佩奇曲线所预测的那样。基于复制技巧的新计算证实了这种减小,并揭示了其几何起源:复制品之间形成的时空虫洞。在这里,我们从量子信息论的角度分析了这些结论与霍金最初结论之间的差异,特别是使用了量子德菲内蒂定理。该定理意味着存在额外的信息 W,它既不是黑洞的一部分,也不是辐射的一部分,而是起着参考的作用。通过复制技巧获得的熵可以被识别为以参考 W 为条件的辐射的熵 S ( R | W ),而霍金的原始结果对应于非条件熵 S ( R )。熵 S ( R | W ) 在数学上是集合平均值,在对 N 个独立准备的黑洞进行实验时,它获得了操作意义:对于较大的 N ,它等于它们联合辐射的归一化熵 S ( R 1 · · · RN ) / N 。这个熵和 S ( R ) 之间的差异意味着黑洞是相关的。因此,复制虫洞可以被解释为这种相关性的几何表示。我们的结果还表明广泛使用的随机幺正模型可以扩展到多黑洞,我们通过非平凡检验支持了这一点。

fineronone用于治疗2型糖尿病的慢性肾脏疾病
3.1慢性肾脏疾病(CKD)是涉及异常肾功能或结构的长期疾病。它受合并症的影响,尤其是2型糖尿病。2型糖尿病中的多余葡萄糖会进一步影响肾脏功能并加速CKD进展。在严重的情况下,有时需要透析或移植。据估计,大约300万人在英国患有2型糖尿病,其中约有20%需要肾脏疾病治疗。临床专家评论说,与仅CKD的人相比,患有CKD和2型糖尿病患者具有发病率的额外风险(包括末期肾脏疾病)和早死亡。这特别是因为它们患心血管疾病的风险更高。临床专家补充说,治疗的目的是减慢疾病进展。They described current treatments, which focus on lifestyle changes, using angiotensin-converting enzyme (ACE) inhibitors and angiotensin-receptor blockers (ARBs), as well as increasing use of sodium–glucose cotransporter-2 (SGLT2) inhibitors because of the recent recommendations in the NICE guideline on the management of type 2 diabetes in adults (NG28) and Dapagliflozin治疗慢性肾脏疾病(TA775)的良好技术评估指南。临床专家强调,尽管目前的疗法,但由于肾功能逐渐恶化的残留风险,需要对CKD和2型糖尿病患者进行其他疗法。他们还强调了需要管理并发症,例如脚溃疡和由周围血管疾病引起的截肢。除

卫星和地面视图之间的跨注意,以增强细粒度的机器人地理位置
跨视图图像地理位置定位旨在通过用GPS标记的卫星图像补丁绘制当前的街道视图图像来确定户外机器人的位置。最近的作品在识别卫星贴片中达到了显着的准确性,该卫星贴片在机器人所在,其中将中央像素在匹配的卫星贴片中用作机器人粗糙位置估计。这项工作着重于机器人在已知的卫星贴片中的细粒度定位。现有的细颗粒定位工作利用相关操作来获得卫星图像本地描述符和街道视图全局描述符之间的相似性。基于衬里匹配的相关操作简化了两个视图之间的相互作用过程,从而导致距离误差很大并影响模型的概括。为了解决这个问题,我们设计了一个具有自我注意力和跨注意层的跨视图功能fu-sion网络,以取代相关操作。此外,我们将分类和回归预测结合在一起,以进一步降低位置距离误差。实验表明,我们的新型网络体系结构的表现优于最先进的,可以在看不见的地区更好的概括能力。具体而言,我们的方法在同一区域和在活力基准的同一区域和看不见的区域中分别将中位定位距离误差降低了43%和50%。
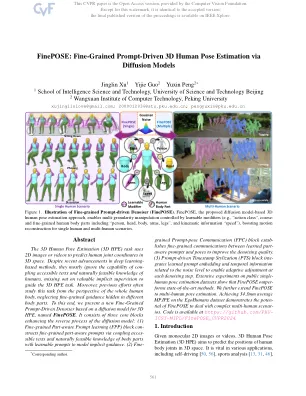
细浓度:通过扩散模型进行细粒度及时驱动的3D人姿势估计
3D人姿势估计(3D HPE)任务使用2D图像或视频来预测3D空间中的人类关节坐标。尽管最新的基于深度学习的方法取得了进步,但它们主要忽略了可访问的文本和自然可行的人类知识的能力,而错过了有价值的隐性监督,以指导3D HPE任务。此外,以前的努力经常从整个人体的角度研究这项任务,从而忽略了隐藏在不同身体部位的细粒度指导。为此,我们基于3D HPE的扩散模型(名为FinePose)提出了一个新的细粒及时驱动的DeNoiser。它由三个核心块组成,增强了扩散模型的反向过程:(1)通过耦合辅助辅助文本和可学习的提示以模拟隐式指南的耦合知识,并通过耦合的辅助辅助文本和自然可行的零件知识,可以通过耦合的辅助辅助文本和自然可行的零件知识来构建精细的部分零件感知的提示。(2)Fine-
FG 按时代和主题分类目录 - 精美游戏
最后一份。■ 杂志与游戏。插入内容包括 140 个计数器,用于耶拿 20 游戏 (40)、旃陀罗笈多 (18)、巴巴罗萨从基辅到罗斯托夫 (2)、1914 东方的黄昏 (3)、战列舰 (10)、难以捉摸的胜利 (10)、SPQR (4)、寒冬 (18)、PQ-17 (2)、为人民 II (18)、追求荣耀 (2) 和其他 9 个。;完整的耶拿 20 游戏;旃陀罗笈多变体;PQ-9/10 场景;SPQR 大象胜利场景;为人民海军卡变体效果;FAB 凸起设置援助与资产能力组合;战斗指挥官场景 103 和 110 场景;命令与颜色史诗古代场景卡。文章关于:为人民 10 周年变体规则; Hellenes 开发者笔记和策略;追求荣耀分析;SPQR 大象胜利场景,公元前 277 年;PQ-17 战略与战术;战斗指挥官斯大林格勒场景 35 分析;库图佐夫生存策略;荣耀之路和低地国家;飞行上校的科罗曼德尔战役 1758-9
使用粗到精视觉变换器进行仿射医学图像配准
仿射配准在全面的医学图像配准流程中不可或缺。然而,只有少数研究关注快速而鲁棒的仿射配准算法。这些研究中大多数利用卷积神经网络(CNN)来学习联合仿射和非参数配准,而对仿射子网络的独立性能探索较少。此外,现有的基于 CNN 的仿射配准方法要么关注局部错位,要么关注输入的全局方向和位置来预测仿射变换矩阵,这些方法对空间初始化很敏感,并且除了训练数据集之外表现出有限的通用性。在本文中,我们提出了一种快速而鲁棒的基于学习的算法,即粗到精视觉变换器(C2FViT),用于 3D 仿射医学图像配准。我们的方法自然地利用了卷积视觉变换器的全局连通性和局部性以及多分辨率策略来学习全局仿射配准。我们对 3D 脑图谱配准和模板匹配归一化方法进行了评估。综合结果表明,我们的方法在配准精度、稳健性和通用性方面优于现有的基于 CNN 的仿射配准方法,同时保留了基于学习的方法的运行时优势。源代码可在 https://github.com/cwmok/C2FViT 上找到。