
XiaoMi-AI文件搜索系统
World File Search SystemImage

机器学习Clifford不变的Ade Coxeter元素
摘要。胸肌分割是乳腺磁共振成像(MRI)的各种计算机辅助应用中的关键步骤。由于胸部和乳房区域之间的伪影和同质性,胸肌边界估计并不是一项琐碎的任务。在本文中,提出了一种基于深度学习的全自动分割方法,以准确描述轴向乳房MR图像中的胸肌边界。提出的方法涉及两个主要步骤:胸肌分割和边界估计。对于胸肌分割,基于U-NET结构的模型用于从输入图像中分离胸肌。接下来,通过候选点检测和轮廓分割来估计胸肌边界。使用两个Real-World数据集,我们自己的私人数据集和一个公开可用的数据集对所提出的方法进行了定量评估。第一个数据集包括12名患者乳房MR图像,第二个数据集由80名患者乳房MR图像组成。所提出的方法在第一个数据集中达到了95%的骰子得分,第二个数据集的骰子得分为89%。在大规模定量乳房MR图像上评估该方法的高分割性能表达了其在将来的乳腺癌临床应用中的潜在适用性。

新闻覆盖的图像型实验室插入功能材料.docx
该出版物报告了使用氧化化学蒸气沉积(OCVD)方法制造的聚(3,4-乙二醇)(PEDOT)薄膜中载体迁移率的主要增强。通过采用纳米结构工程,研究团队成功地优化了π-π堆积距离,从而实现了准二维(1D)电荷传输途径。这些进步导致了载流子的迁移率和热电性能,证明了OCVD制作的PEDOT薄膜用于下一代能量和电子应用的多功能潜力。这一显着的成就是M.S.出色的研究贡献的结果。学生Brian Dautel和Ph.D.学生Kafil Chowdhury,在Meysam博士在AMED实验室的监督下。
移动 NPU 上的实时量化图像超分辨率,移动 AI 2021 挑战赛:报告
图像超分辨率是最流行的计算机视觉问题之一,在移动设备上有许多重要的应用。虽然已经为这项任务提出了许多解决方案,但它们通常甚至没有针对常见的智能手机 AI 硬件进行优化,更不用说通常仅支持 INT8 推理的更受限的智能电视平台了。为了解决这个问题,我们推出了第一个移动 AI 挑战赛,其目标是开发一种基于端到端深度学习的图像超分辨率解决方案,该解决方案可以在移动或边缘 NPU 上展示实时性能。为此,为参与者提供了 DIV2K 数据集和训练过的量化模型,以进行高效的 3 倍图像升级。所有模型的运行时间都在 Synaptics VS680 智能家居板上进行评估,该板具有能够加速量化神经网络的专用 NPU。所提出的解决方案与所有主流移动 AI 加速器完全兼容,能够在 40-60 毫秒内重建全高清图像,同时实现高保真度结果。本文提供了挑战赛中开发的所有模型的详细描述。

推进和评估文本指导的图像inpainting
文本引导的图像编辑可以在支持创意应用程序方面具有变革性的影响。关键挑战是生成忠于输入文本提示的编辑,同时与输入图像一致。我们提出了Imagen Edor,这是一种构建的级联扩散模型,通过对文本引导的图像插入的微调[36]构建。Imagen ed- Itor的编辑忠实于文本提示,这是通过使用对象探测器在培训期间提出涂料面罩来提出的。此外,成像编辑器在输入图像中通过对原始高分辨率图像进行调节管道来详细信息。为了证明定性和定量评估,我们介绍了EditBench,这是用于文本指导图像插入的系统基准。EditBench评估在Natu-ral和生成的图像上探索对象,属性和场景的图像。Through extensive human evaluation on EditBench, we find that object-masking during training leads to across- the-board improvements in text-image alignment – such that Imagen Editor is preferred over DALL-E 2 [ 31 ] and Stable Diffusion [ 33 ] – and, as a cohort, these models are better at object-rendering than text-rendering, and handle mate- rial/color/size attributes better than count/shape attributes.
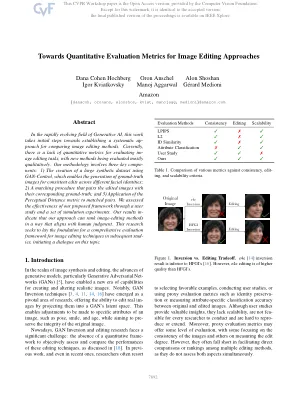
迈向图像编辑方法的定量评估指标
在生成AI的快速发展的领域中,这项工作采取了初步步骤,以建立用于比较图像编辑方法的系统范围。当前,缺乏用于评估IMED编辑任务的定量指标,而新方法主要是定性评估的。我们的方法涉及三个关键组成部分:1)使用gan-Control创建大型合成数据集,该数据集可以生成地面图像,以跨不同面部身份进行一致的编辑; 2)匹配过程,将编辑的图像与相应的地面真相配对; 3)将感知距离指标应用于匹配对。我们通过用户研究和一组仿真实验评估了我们提出的框架的有效性。我们的结果表明,我们的方法可以以与人类判断相符的方式对图像编辑方法进行排名。这项研究旨在为随后的研究中的图像编辑技术建立全面的评估框架奠定基础,并就此主题进行对话。
任何时间图像生成的嵌套扩散过程
扩散模型是生成时期的当前最新模型,它通过将生成过程分解为许多细粒度的排除步骤,从而综合了高质量的图像。尽管其性能良好,但扩散模型在计算上还是需要许多Neu-ral功能评估(NFES)。在这项工作中,我们提出了一种基于扩散的方法,该方法在完成前在任意时间停止时可以生成可行的图像。使用现有的预处理扩散模型,我们表明可以将生成方案重新组成为两个嵌套扩散过程,从而可以快速迭代的迭代细化。在实验和基于稳定的基于扩散的文本对图像生成的实验中,我们在定性和定量上都表明,我们的方法的相互作用质量大大超过了原始扩散模型的质量,而最后一代结果仍然可比。我们说明了嵌套扩散在多种设置中的适用性,包括用于求解逆概率,以及在整个采样过程中允许用户干预,用于快速基于文本的内容创建。1
反事实说明的文本到图像模型
本文解决了生成法定说明(CES)的挑战,涉及识别和修改最少的必要特征,以使分类器对给定图像的预测进行预测。我们提出的方法是反事实e xplanations(Time)的tept to-i mage m odels,是一种基于蒸馏的黑盒反事实技术。与以前的方法不同,此方法仅需要图像及其预测,从而忽略了分类器的结构,参数或梯度的需求。在生成反事实之前,时间将两个不同的偏见引入了文本嵌入的形式稳定扩散:与图像的结构相关联的上下文偏差和类别偏见,与目标分类器学到的类特异性特征相关。学习了这些偏见后,我们发现了使用类预测的类令牌的最佳潜在代码,并使用目标嵌入作为条件,从而产生了符合性的解释。广泛的经验研究证明,即使在黑色盒子设置中运行时,时间也可以产生可比性的解释。

小波损耗的训练变压器模型可改善单图像超分辨率
基于变压器的模型已在包括图像超级分辨率(SR)在内的低级视觉任务中取得了显着的结果。但是,在获得全球信息时,基于不重叠的窗口中依赖自我注意的早期aperach遇到了挑战。为了激活全球更多输入像素,已经提出了混合注意模型。此外,通过仅将像素的RGB损失(例如L 1)降至最低而无法捕获基本的高频降低,训练不足。本文提出了两种贡献:i)我们引入了卷积非本地稀疏注意(NLSA)块,以扩展混合变压器体系结构,以增强其接受场。ii)我们采用小波损失来训练变压器模型,以提高定量和主观性能。虽然先前已经探索过小波损耗,但在基于训练变压器的SR模型中显示了它们的力量是新颖的。我们的实验结果表明,所提出的模型在各种基准数据集中提供了状态的PSNR结果以及出色的视觉性能。
3D感知图像合成上自定义属性的定量操纵
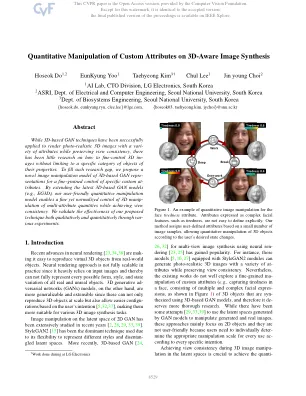
尽管基于3D的GAN技术已成功地应用于具有各种属性的照片真实的3D图像,同时保持视图一致性,但很少有关于如何罚款3D impersimens的研究,而不会限制其属性特定对象的特定对象类别。为了填补此类研究空白,我们提出了一个基于3D的GAN代表的新型图像操纵模型,以对特定的自定义贡献进行细粒度控制。通过扩展最新的基于3D的GAN模型(例如,EG3D),我们的用户友好定量操作模型可以实现对3D操作多属性数量的精细而归一化的控制,同时实现了视图一致性。我们通过各种实验验证了我们提出的技术的有效性。
medblip:3D医学图像和文本
摘要。视觉语言预处理(VLP)模型已在众多计算机视觉应用中被证明。在本文中,我们基于图像扫描和电子健康记录中的文本介绍,为医疗领域开发VLP模型,以促进计算机辅助诊断(CAD)。为了实现这一目标,我们介绍了MedBlip,这是一种轻巧的CAD系统,该系统启动了从架子冻结的预训练的图像编码器和大型语言模型中启动VLP。我们合并了一个MEDQFormer模块,以弥合3D医学图像和2D预训练的图像编码器和语言模型之间的差距。为了评估MEDBLIP的有效性,我们从五个公共阿尔茨海默氏病(AD)数据集中收集了30,000多个图像量:ADNI,NACC,OASIS,OASIS,AIBL和MIRIAD。在这个大规模的广告集中,我们的模型在健康,轻度认知障碍(MCI)和AD主题的零摄像分类中表现出了令人印象深刻的表现,并且还显示了其在M3D-VQA-AD数据集中的医学视觉问题An-Swering(VQA)中的能力。代码和预训练模型可在https://github.com/qybc/medblip上找到。