
XiaoMi-AI文件搜索系统
World File Search SystemModels

为流体力学学生项目制作风洞模型的替代方法
为流体力学学生项目制作风洞模型的替代方法摘要基于项目的工程教育方法使得学生希望在流体力学课程中创建功能性风洞模型来测试原始设计。本文根据成本、生产时间、易用性以及设备和材料的可及性,比较了几种快速原型 (RP) 方法与用于制造流体动力学模型的传统模具/铸造技术。考虑的 RP 技术包括立体光刻 (SLA)、选择性激光烧结 (SLS)、熔融沉积成型 (FDM)、3D 打印和 CNC 加工。这些方法从数字格式的原始设计开始,而传统方法(例如使用硅橡胶或藻酸盐模具铸造)至少需要粗略的物理原型。还讨论了 RP 模型的涂层和精加工工艺。背景和介绍 德克萨斯大学奥斯汀分校机械工程系已开展了 6 年的综合计划,旨在在整个本科课程中实施基于项目的方法 [1]。该计划的一个要素包括与流体力学入门课程同时进行的风洞测试。本科流体力学实验室有两个风洞,分别有 12"x12" 和 24"x24" 的测试部分。目前,学生仅使用风洞进行经典实验,使用现成的模型(例如横流中的圆柱体和翼型)以及进行流动可视化演示。被测试的对象形状简单,提供有限的创造性实验机会。我们希望通过为学生提供设计和测试原始空气动力学模型(例如汽车车身形状)的机会来增强这种体验。这促使人们研究快速生产原始设计风洞模型的替代方法。考虑了两种根本不同的方法:(1)从粗糙的物理原型开始成型/铸造模型和(2)从数字图像创建功能性物理模型。成型/铸造技术能够生产所有尺寸和几何公差的模型。这些方法可以利用各种不同的材料进行模具制作和铸造,包括热熔胶、乳胶、硅橡胶、聚硫橡胶、聚氨酯、藻酸盐、塑料树脂、环氧树脂、蜡、泡沫、粘土和水基石膏或混凝土。设备和该多步骤过程可能很长,并且需要一定的技能来形成可重复使用的模具和铸造模型。快速原型 (RP) 是指直接从 CAD 文件制造物理对象的过程。此类原型技术包括立体光刻 (SLA)、选择性激光烧结 (SLS)、熔融沉积成型 (FDM)、3D 打印和 CNC 加工等工艺。这些工艺中的每一个都会产生耐用、持久的模型,并且可以通过各种二次表面处理来增强其性能。
具有高级功能的革新商业模型
总而言之,LMCHING对其具有高级功能的业务模型的转变将品牌定位为不断发展的数字市场的领导者。通过利用AI,自动化,机器学习和增强现实,LMCHING不仅优化了其运营,而且还为客户创造了更具个性化,引人入胜且高效的购物体验。随着像Penhaligon和Shiseido这样的品牌继续在各自的行业中进行创新,LMCHING的整体技术整合方法为企业如何保持竞争力并在快速变化的零售环境中蓬勃发展提供了模型。通过不断改善其内部流程和面向客户的功能,LMCHING为现代零售的未来铺平了道路。

种族偏见如何融入临床模型
不仅包括隐性偏见或个人歧视,还包括鼓励和助长这种歧视的规则和实践结构。1 结构性种族主义的一个定义是“社会通过相互加强的住房、教育、就业、收入、福利、信贷、媒体、医疗保健和刑事司法系统助长种族歧视的全部方式”。3 衡量种族主义具有挑战性。它不仅可能是主观的,而且还可能带有政治色彩,并且基于难以收集的数据。尽管如此,为了监测变化和设定目标,有一个可衡量的结果至关重要。出于这个原因,出现了许多衡量种族主义的方法,包括感知歧视量表。3

根据 2023 年 3 月 10 日 MNRE 的命令,太阳能光伏组件的核准型号和制造商(强制性要求
b) ALMM 将根据法律仅适用于由政府赞助/补贴的项目。ALMM 将适用于政府或其机构采购电力供自己消费或通过配电公司分配给人民。ALMM 将适用于受补贴的太阳能光伏屋顶和 PM KUSUM。ALMM 不适用于在开放获取下设立或由私人团体控制的项目。换句话说,ALMM 不适用于自行设立发电设施的人。

基于能量的模型的流对比估计
本文研究了一种联合估计基于能量的模型和基于流的模型的训练方法,其中两个模型基于共享的对抗值函数进行迭代更新。该联合训练方法具有以下特点:(1)基于能量的模型的更新基于噪声对比估计,流模型作为强噪声分布。(2)流模型的更新近似地最小化了流模型与数据分布之间的 Jensen-Shannon 散度。(3)与生成对抗网络(GAN)估计由生成器模型定义的隐式概率分布不同,我们的方法估计数据上的两个显式概率分布。使用所提出的方法,我们证明了流模型的综合质量的显著改进,并展示了通过学习到的基于能量的模型进行无监督特征学习的有效性。此外,所提出的训练方法可以轻松适应半监督学习。我们取得了与最先进的半监督学习方法相媲美的成果。

可解释的AI(XAI)和大型语言模型(LLM)
➢这是一个欺骗深神经网络(DNN)的实验:在第二和第四张图像中,工程师仅保留了系统用于识别吉他和企鹅的系统的元素,并更改了其余的所有内容,以使系统仍然像吉他和企鹅一样“看到”他们。➢Goodfellow等人的作品。(2014)从普遍的扰动开始打开了进一步发展的大门(Moosavi-Dezfooli等人。2017)最近的一个像素攻击,该攻击显示了如何通过在输入图像中更改一个像素来欺骗神经网络。笔记本在这里一张像素攻击原始纸


太阳-地球模型和应用软件
简要说明:国际参考电离层 (IRI) 是由空间研究委员会 (COSPAR) 和国际无线电科学联合会 (URSI) 赞助的一个国际项目。这些组织在 20 世纪 60 年代末成立了一个工作组,根据所有可用的数据源,制定电离层的经验标准模型。该模型的几个稳步改进版本已经发布。IRI 描述了从约 50 公里到约 2000 公里的高度范围内的电子密度、电子温度、离子温度和离子成分。它提供了磁平静条件下非极光电离层的月平均值。主要数据来源是全球电离层网络、强大的非相干散射雷达(Jicamarca、Arecibo、Millstone Hill、Malvern、St. Santin)、ISIS 和 Alouette顶部探测器,以及几颗卫星和火箭上的现场仪器。IRI 每年在特别 IRI 研讨会期间更新(例如,在 COSPAR 大会期间)。计划进行几项扩展,包括离子漂移模型、极光和极地电离层的描述以及对磁暴效应的考虑。
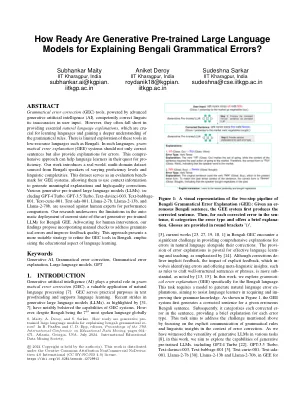
如何准备好生成的预训练的大语言模型来解释孟加拉语语法错误?
抽象的语法校正校正(GEC)工具,由先进的生成人工智能(AI)提供动力,在用户输入中有效地纠正了语言的不准确性。但是,它们通常在提供基本的自然语言解释方面缺乏,这些解释是学习语言并获得对语法规则的更深入的理解。在低资源语言(例如孟加拉语)中对这些工具的探索有限。在这样的语言中,革命错误说明(GEE)系统不仅应正确句子,而且还应提供错误的解释。这种综合方法可以帮助语言学习者寻求提高能力。我们的工作介绍了一个现实世界中的多域数据集,该数据集来自孟加拉语扬声器,具有不同的义务水平和语言复杂性。此数据集可作为GEE系统的评估基准标记,允许他们使用上下文信息来生成有意义的解释和高质量的更正。Various generative pre-trained large language models (LLMs), in- cluding GPT-4 Turbo, GPT-3.5 Turbo, Text-davinci-003, Text-babbage- 001, Text-curie-001, Text-ada-001, Llama-2-7b, Llama-2-13b, and Llama-2-70b, are assessed against human experts for performance comparison.我们的研究强调了自动部署孟加拉人GEE的当前最新生成预培训的LLM的局限性。主张进行人干预,我们的发现提议合并手动检查以解决语法错误并提高反馈质量。这种方法提出了一种更合适的策略,以重新确定孟加拉语的GEC工具,并阐明了语言学习的教育方面。

医疗保健专业人员在实施基于机器学习的糖尿病预测模型
摘要:基于机器学习的糖尿病预测模型已在医疗保健中引起了人们的重大关注,作为糖尿病早期检测和管理的潜在工具。但是,这些模型的成功实施在很大程度上取决于医疗保健专业人员的参与。本摘要探讨了医疗保健专业人员在实施基于机器学习的糖尿病预测模型中的作用。医疗保健专业人员通过与数据科学家和机器学习专家合作,在这些模型的开发和实施中起着至关重要的作用。他们的临床专业知识和领域知识有助于确定相关的数据源和模型开发变量。他们还确保数据质量和完整性,在整个过程中解决道德方面的考虑。在实施阶段,医疗保健专业人员负责数据收集和预处理,包括从电子健康记录和可穿戴设备中收集患者数据。他们在清洁和组织模型输入数据时确保数据隐私和安全性。医疗保健专业人员评估和验证模型的性能和准确性,评估局限性和潜在偏见。集成到临床工作流程中是医疗保健专业人员的另一个关键责任。他们与IT部门合作,无缝整合