
XiaoMi-AI文件搜索系统
World File Search SystemMulti


intemplea〜ao entre sistemas multiagente e plataforma ...
在遥感出现之前,土壤场映射是可用的未知数,这是一种昂贵,耗时的方法,结果不准确。另一方面,遥感提供了一种空间和时间方法,允许跟踪历史记录,这是信息信息中没有土地监控的信息。在文献中,我们可以观察到,通过遥控感(例如:i)[Mcullough等人,都有巨大的努力来监测鹰表面的动力学。2013]分析了Sat'Elisis modi的图像,分辨率为250米,用于在2000年至2011年期间远程监测美国缅因州湖泊的图像; ii)[Feyisa等。2014]在存在各种类型的环境标题的情况下,提高了敬畏(自动化水的伸出指数),以提高预防性精度;和,iii)[Fisher等。2016]根据标准化数据提出的过程方法,使用优化的阈值在大记录中对水进行自动分类。
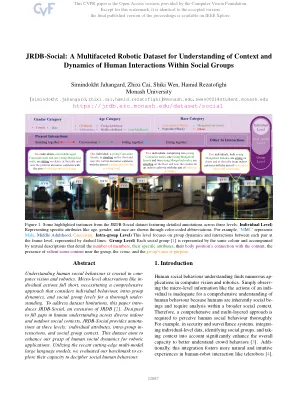
JRDB-Social:一个多方面的机器人数据集,用于理解社会群体内人类互动的上下文和动态
了解人类的社会行为对于综合愿景和机器人技术至关重要。微观的观察(例如,分裂行动)不足,需要采取一种全面的方法来考虑个人行为,组内动态和社会群体层次,以彻底理解。要解决数据集限制,本文引入了JRDB-Social,JRDB的扩展[2]。旨在填补跨室内和室外社会环境的人类理解的空白,JRDB-Social提供了三个层次的注释:个体属性,组内侵入和社会群体环境。该数据集旨在增强我们对机器人应用的人类社会动态的理解。利用最近的尖端多模式大型语言模型,我们评估了我们的基准,以表达其破译社会人类行为的能力。

进化:增强无监督的持续学习与多位专家
近年来在未加强的持续学习方法中取得了重大进展。尽管它们在受控设置中取得了成功,但它们在现实世界中的实用性仍然不确定。在本文中,我们首先从经验上介绍了现有的自我保护的持续学习方法。我们表明,即使有了重播缓冲液,现有的methods也无法保留与时间相关输入的视频的关键知识。我们的见解是,无监督的持续学习的主要挑战源于无法预测的意见,缺乏监督和先验知识。从Hybrid AI中汲取灵感,我们介绍了E Volve,这是一个创新的框架,它是云中的多个预审预周化模型,作为专家,以加强对Lo-cal Clister的现有自我监督的学习方法。e Volve通过新颖的专家聚合损失来利用专家指导,并从云中返回并返回。它还根据专家的信心和量身定制的先验知识将权重动态分配给专家,从而为新流数据提供自适应监督。我们在几个具有时间相关的实地世界数据流中广泛验证了E volve。结果令人信服地表明,E Volve超过了最佳的无监督持续学习方法,在跨Var-IOS数据流的Top-1线性评估准确性中,volve持续了6.1-53.7%,从而确认了多样化的专家指南的功效。代码库位于https://github.com/ orienfish/evolve。
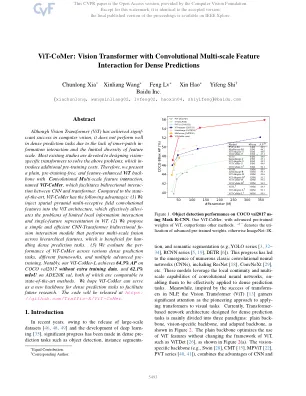
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。
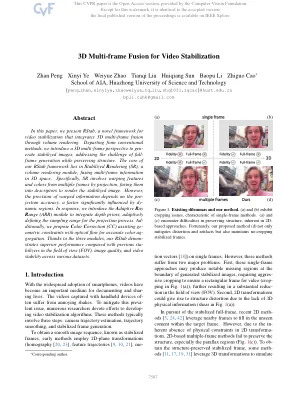
3D多帧融合视频稳定
在本文中,我们提出了RSTAB,这是视频稳定框架的新型框架,该框架通过音量渲染整合了3D多帧融合。与传统方法背道而驰,我们引入了一个3D多框架透视图,以进行稳定的图像,从而解决了全框架生成的挑战,同时保存结构。我们的RSTAB框架的核心在于S Tabilized R Endering(SR),该卷渲染模块,在3D空间中融合了多帧信息。具体来说,SR涉及通过投影从多个帧中旋转的特征和颜色,将它们融合到描述符中以呈现稳定的图像。然而,扭曲的信息的精度取决于降低的准确性,这是受染色体区域显着影响的因素。为了响应,我们介绍了a daptive r ay r ange(arr)模块以整合深度先验,并自适应地定义了投影过程的采样范围。在方面上,我们提出了以光流的光流限制的限制,以进行精确的颜色,以实现精确的颜色。多亏了这三个模块,我们的rstab示例表现出了卓越的性能,与以前的视野(FOV),图像质量和视频稳定性相比,各种数据集的稳定器相比。

多靶点药物是治疗阿尔茨海默病的潜在药物。一种新的 5-取代基家族
摘要 多靶点药物是治疗阿尔茨海默病的一种有前途的方法。本文描述了一类新的 5-取代吲唑衍生物,它们具有多靶点特性,包括胆碱酯酶和 BACE1 抑制。因此,对一类新的 5-取代吲唑进行了合成和评估。药理学评价包括对 AChE/BuChE 和 BACE1 酶的体外抑制试验。此外,还对 BuChE 进行了相应的竞争研究。此外,还根据 ORAC 测定计算了抗氧化特性。此外,还研究了它们对 Raw 264.7 细胞的抗炎特性和对人神经母细胞瘤 SH-SY5Y 细胞的神经保护作用。药理学测试结果表明,这些 5-取代吲唑衍生物 1 – 4 和 6 中的一些可以同时作为 AChE/BuChE 和 BACE1 抑制剂。此外,一些吲唑衍生物表现出抗炎(3、6)和神经保护(1-4和6)作用,具有抗氧化作用,可对抗A b 诱导的人类神经母细胞瘤SH-SY5Y细胞死亡。
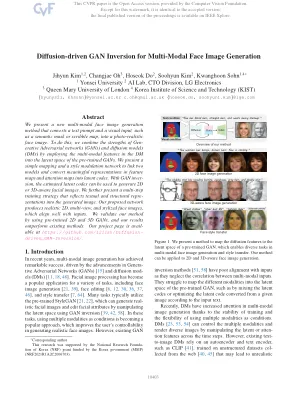
多模式面部图像生成的扩散驱动的GAN倒置
摘要我们提出了一种新的多模式面部图像生成方法,该方法将文本提示和视觉输入(例如语义掩码或涂鸦图)转换为照片真实的面部图像。为此,我们通过使用DM中的多模式特征在预训练的GAN的潜在空间中使用多模式特征来结合一般的对抗网络(GAN)和扩散模型(DMS)的优势。我们提供了一个简单的映射和一个样式调制网络,可将两个模型链接起来,并在特征地图和注意力图中将有意义的表示形式转换为潜在代码。使用gan inversion,估计的潜在代码可用于生成2D或3D感知的面部图像。我们进一步提出了一种多步训练策略,该策略将文本和结构代表反映到生成的图像中。我们提出的网络生成了现实的2D,多视图和风格化的面部图像,这些图像与输入很好。我们通过使用预训练的2D和3D GAN来验证我们的方法,我们的结果表现优于现有方法。我们的项目页面可在https://github.com/1211SH/diffusion-driven_gan-inversion/。
ma-lmm:长期视频理解的内存大型多模型
随着大型语言模型(LLM)的成功,将视觉模型融入了LLM,以建立视觉语言基础模型最近引起了人们的兴趣。但是,现有的基于LLM的大型多模式模型(例如,视频播放,视频聊天)只能摄入有限数量的框架以进行简短的视频理解。在这项研究中,我们主要专注于设计一个有效有效的模型,以进行长期视频理解。我们建议以在线方式处理视频并将过去的视频信息存储在存储库中,而不是像大多数现有作品一样尝试同时进行更多框架。这使我们的模型可以参考历史视频内容以进行长期分析,而不会超过LLM的上下文长度约束或GPU内存限制。我们的内存库可以以现成的方式被缝制到当前的多模式LLMS中。我们在各种视频理解任务上进行了广泛的实验,例如长期介绍,视频问题答案和视频字幕,我们的模型可以在多个数据集中实现最新的性能。

非黑色素瘤皮肤癌(NMSC)多学科护理团队(MDT)
对于诊断为NMSC的患者,例如BCC和CSCC,他们的病例可能需要特定的医疗专业知识,具体取决于癌症的位置,大小和阶段。如果案例已提高,则可能需要各种专业的不同医疗保健专业人员来管理患者疾病。