
XiaoMi-AI文件搜索系统
World File Search SystemMulti

一种多视图聚类的锚点增强策略
近年来,基于锚点的方法在多视图聚类中取得了可喜的进展。这些方法的性能受到锚点质量的显著影响。然而,以前的研究生成的锚点仅仅依赖于单视图信息,忽略了不同视图之间的相关性。特别地,我们观察到相似的模式更有可能存在于相似的视图之间,因此可以利用这种相关性信息来提高锚点的质量,而这同样被忽略了。为此,我们提出了一种新颖的即插即用的通过视图相关性进行多视图聚类的锚点增强策略。具体而言,我们基于对齐的初始锚点图构建视图图来探索视图间相关性。通过从视图相关性中学习,我们使用相邻视图上锚点和样本之间的关系来增强当前视图的锚点,从而缩小相似视图上锚点的空间分布。在七个数据集上的实验结果证明了我们的方法优于其他现有方法。此外,大量的对比实验验证了所提出的锚增强模块应用于各种基于锚的方法时的有效性。

一种简单而有效的可扩展多视图张量聚类
基于锚点的大规模多视图聚类因其在处理海量数据集方面的有效性而引起了广泛关注。然而,当前的方法主要通过探索锚点图或投影矩阵之间的全局相关性来寻找用于聚类的共识嵌入特征。在本文中,我们提出了一种简单而有效的可扩展多视图张量聚类(S 2 MVTC)方法,我们的重点是学习视图内和跨视图的嵌入特征的相关性。具体而言,我们首先通过将不同视图的嵌入特征堆叠到张量中并旋转它来构造嵌入特征张量。此外,我们构建了一种新颖的张量低频近似(TLFA)算子,它将图相似性结合到嵌入特征学习中,有效地实现不同视图内嵌入特征的平滑表示。此外,对嵌入特征应用共识约束以确保视图间语义一致性。在六个大规模多视图数据集上的实验结果表明,S 2 MVTC 在聚类性能和 CPU 执行时间方面明显优于最先进的算法,尤其是在处理海量数据时。S 2 MVTC 的代码已公开发布在 https://github.com/longzhen520/S2MVTC。

歌剧:通过过度信托的惩罚和转录分配
幻觉是对多模态大语言模型(MLLM)的普遍挑战的幻觉,极大地阻碍了他们需要精确判断的真实用法。现有方法可以通过特定设计的数据进行培训,或通过其他来源的特定知识来缓解此问题,从而产生了不可避免的额外费用。在本文中,我们提出了一种新型的MLLM解码方法,该方法基于o-vertust pe nalty和r eTroptoction-llocation策略,它是一种几乎免费的午餐,可以减轻幻觉问题,并没有其他数据,知识,知识或培训。我们的方法始于一个有趣的观察结果,即,大多数幻觉与自我注意力矩阵所表现出的知识聚集作用紧密相关,即MLLM倾向于通过关注一些摘要的代价来产生新的代币,但并非所有以前的代币。这种部分过度信任的倾向会导致忽略图像令牌,并用幻觉描述图像内容。基于观察结果,Opera在梁搜索解码过程中引入了对模型逻辑的惩罚术语,以使Miti-Gate the Trust问题以及回滚策略回顾了在预先生成的令牌中存在摘要令牌的存在,并在必要必要时重新分配给标记。通过广泛的实验,Opera在不同的MLLM和指标上表现出明显的幻觉降低性能,证明其有效性和性质。我们的代码为:https://github.com/shikiw/opera。

成人多发性硬化症:治疗
本指南中的建议代表了 NICE 的观点,是在仔细考虑了现有证据后得出的。在做出判断时,专业人士和从业者应充分考虑本指南,以及患者或使用其服务的人的个人需求、偏好和价值观。应用这些建议并非强制性的,指南并不凌驾于根据个人情况做出适当决定的责任,这些决定应与个人及其家人、护理人员或监护人协商。

多相机3D帕金森氏病的精度评估
帕金森氏病(PD)是一种毁灭性的运动,在全球流行率上加速了,但是缺乏精确的症状测量使得有效疗法的发展具有挑战性。统一的帕金森统一级评级量表(UPDRS)是评估运动症状严重程度的黄金标准,但其手动评分标准含糊不清,既模糊又主观,导致了粗糙和嘈杂的临床评估。机器学习方法有可能通过使PD症状评估现代化,以使其更具定量,客观和可扩展性。但是,缺乏用于PD运动考试的基准视频数据集阻碍了模型开发。在这里,我们介绍了郁金香数据集以弥合此差距。Tulip强调预先挑剔和全面性,包括25种UPDRS运动考试活动的多视频记录(6张摄像机),以及3位临床专家的评级,在帕金森氏症患者和健康对照组中。多视图记录实现了身体运动的3D重建,该重建更好地捕获疾病特征,而不是更多的调用2D方法。使用数据集,我们建立了一个基本线模型,用于预测3D姿势的UPDRS分数,以说明如何自动化现有诊断。展望未来,郁金香可以帮助开发超过UPDRS分数的新的精确诊断,从而深入了解PD及其潜在治疗方法。

Agilent 8904A 多功能合成器 直流至 600 kHz
Agilent Technologies 8904A 多功能合成器采用最新的 VLSIC 技术,从六种基本波形创建复杂信号。标准 8904A 以数字方式合成精确的正弦波、方波、三角波、斜波、白噪声和直流波形,并将这些信号路由到单个输出。选件 001 增加了三个相同的内部合成器(通道),它们可以调制第一个合成器或与输出相加。可以为每个合成器独立设置频率、幅度、波形、相位和目标。通道 A 可用的调制类型包括 AM、FM、FM、DSBSC 和脉冲调制。选件 002 增加了第二个 50 Ω 输出,为双通道应用提供了第二个独立信号。选件 003 为 8904A 添加了快速跳频和数字调制功能。选件 005 允许多个 8904A 进行相位同步,以满足需要使用多个 8904A 的应用。选件 006 将 8904A 的输出 1 从 50 Ω 浮动输出更改为 600 Ω 高功率平衡输出。使用此选项,8904A 可以将 10 伏特有效值电压输出到 600 Ω 负载,频率范围从 30 Hz 到 100 kHz 以上。所有这些独特功能使 8904A 成为 VOR、ILS、FM 立体声和通信信号等要求苛刻的应用的强大工具。

tcl-net:具有频率域融合和多角度注意的轻巧有效的飞行网络
摘要。朦胧的图像带来了一个具有挑战性的问题,由于信息丢失和颜色失真而遭受。当前的基于深度学习的去悬式方法通过增加网络深度来增强性能,但会导致大量参数开销。同时,标准卷积层集中在低频细节上,通常会说出高频信息,这阻碍了模糊图像中提出的先前信息的有效利用。在本文中,我们提出了TCL-NET,这是一个轻巧的飞行网络,该网络强调了频域特征。我们的网络首先包含一个用于提取高频和低频内形式的所谓层,该层是针对原始模糊图像的快速变压器专门设计的。同时,我们设计了一个频率域信息融合模块,该模块将高频和低频信息与后续卷积层的卷积网络作品集成在一起。此外,为了更好地利用原始图像的空间信息,我们引入了一个多角度注意模块。使用上述设计,我们的网络以仅0.48MB的总参数大小实现了出色的性能,与其他最先进的轻量级网络相比,参数的数量级降低了。

EmbodiedScan:面向具身 AI 的整体多模式 3D 感知套件
摘要 在计算机视觉和机器人领域,具身代理有望探索其环境并执行人类的指令。 这就需要能够根据第一人称观察充分理解 3D 场景,并将其语境化为语言进行交互。 然而,传统研究更多地侧重于从全局视角进行场景级输入和输出设置。 为了解决这一差距,我们引入了 EmbodiedScan,这是一个多模态、以自我为中心的 3D 感知数据集和整体 3D 场景理解的基准。 它包含超过 5k 个扫描,封装了 1M 个以自我为中心的 RGB-D 视图、1M 个语言提示、160k 个 3D 导向框,涵盖 760 多个类别,其中一些与 LVIS 部分一致,以及具有 80 个常见类别的密集语义占用率。 基于这个数据库,我们引入了一个名为 Embodied Perceptron 的基线框架。它能够处理任意数量的多模态输入,并表现出卓越的 3D 感知能力,无论是在我们建立的两个系列基准测试(即基本 3D 感知任务和基于语言的任务)中,还是在野外。
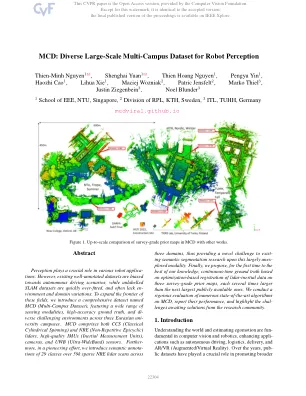
MCD:机器人感知的多种大型多校区数据集
感知在各种机器人应用中起着至关重要的作用。但是,现有的良好的数据集偏向自动驾驶场景,而未标记的SLAM数据集则很快过于拟合,并且通常缺乏环境和域变化。为了扩大这些领域的边界,我们介绍了一个名为MCD(Multi-campus数据集)的全面数据集,其中包含各种感应方式,高准确的地面真相以及在三个欧亚大学的欧亚大学校园内的挑战性环境。MCD包括CCS(经典的圆柱旋转)和NRE(非重复性环球)LIDAR,高质量的IMU(惯性测量单元),相机和UWB(URWB(Ultra-Wideband))传感器。更重要的是,在开创性的努力中,我们引入了29堂课的语义注释,超过59k稀疏的nre lidar扫描
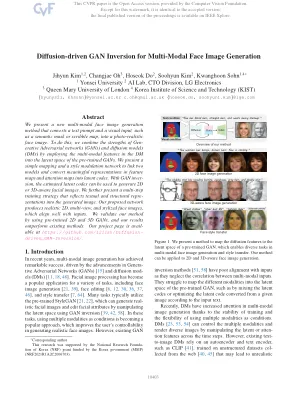
多模式面部图像生成的扩散驱动的GAN倒置
摘要我们提出了一种新的多模式面部图像生成方法,该方法将文本提示和视觉输入(例如语义掩码或涂鸦图)转换为照片真实的面部图像。为此,我们通过使用DM中的多模式特征在预训练的GAN的潜在空间中使用多模式特征来结合一般的对抗网络(GAN)和扩散模型(DMS)的优势。我们提供了一个简单的映射和一个样式调制网络,可将两个模型链接起来,并在特征地图和注意力图中将有意义的表示形式转换为潜在代码。使用gan inversion,估计的潜在代码可用于生成2D或3D感知的面部图像。我们进一步提出了一种多步训练策略,该策略将文本和结构代表反映到生成的图像中。我们提出的网络生成了现实的2D,多视图和风格化的面部图像,这些图像与输入很好。我们通过使用预训练的2D和3D GAN来验证我们的方法,我们的结果表现优于现有方法。我们的项目页面可在https://github.com/1211SH/diffusion-driven_gan-inversion/。