
XiaoMi-AI文件搜索系统
World File Search SystemRei

Cryorl:加固学习启用有效的冷冻EM数据收集
单粒子冷冻电子显微镜(Cryo-EM)已成为主流结构生物学技术之一,因为它具有确定动态生物分子的高分辨率结构的能力。但是,冷冻EM数据获取仍然是昂贵且劳动力密集的,需要大量的专业知识。结构生物学家需要一种更高效,更客观的方法来在有限的时间范围内收集最佳数据。我们将Cryo-EM数据收集任务制定为这项工作中的优化问题。目标是最大化指定期间拍摄的好图像的总数。我们表明,强化学习是一种有效的方法来计划低温EM数据收集,并成功导航异质的低温EM网格。我们开发的AP-PRACH,CRYORL,在类似设置下的数据收集的平均用户表现出了更好的表现。
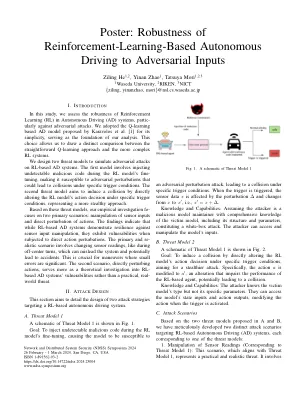
海报:基于加强学习的自主行动的鲁棒性驱动到对抗性输入
在这项研究中,我们评估了自主驾驶(AD)系统中增强学习的鲁棒性(RL),特别是反对对抗攻击的稳健性。我们采用了Karavolos等人提出的基于Q学习的AD模型。[1]的简单性,是我们分析的基础。此选择使我们能够在简单的Q学习方法和更复杂的RL系统之间进行明显的比较。我们设计了两个威胁模型,以模拟对基于RL的广告系统的对抗性攻击。第一个模型涉及在RL模型的细调中注入未发现的恶意代码,使其容易受到对抗性扰动的影响,这可能会导致在特定的触发条件下碰撞。第二个威胁模型旨在通过直接改变RL模型在特定触发条件下的行动决策来引起碰撞,这代表了一种更隐秘的方法。基于这些威胁模型,我们对两种主要情况的实证研究提出:操纵传感器输入和直接对动作的扰动。研究结果表明,尽管基于RL的AD系统表现出针对传感器输入操纵的弹性,但在受到直接动作扰动时它们会表现出脆弱性。主要的和宽容的场景涉及更改传感器读数,例如在偏心转弯期间,这可能会误导系统并可能导致事故。这对于小误差很大的操作至关重要。第二种情况直接扰动动作,更多地是对基于RL的AD系统脆弱性的理论研究,而不是实用的现实世界威胁。

通过增强学习
学习表征捕获对世界的非常基本的理解是机器学习的关键挑战。隐藏在数据中的解释因素的层次结构是如此一般的表示,并且可以通过分层VAE实现。然而,培训层次的VAE总是遭受“后塌陷”的苦难,其中数据信息很难传播到更高级别的潜在变量,因此导致层次结构不良。为了解决这个问题,我们首先是从信息理论的角度来减轻后层崩溃的现有方法的缺点,然后突出了正规化的必要性,即在维持不同级别之间的依赖性的同时,将数据信息明确传播到高级潜在变量。这自然会导致提出高级潜在表示作为顺序决策过程的推断,这可能受益于应用强化学习(RL)。将RL的目标与正规化的目标保持一致,我们首先引入了一条跳过的途径,以获取奖励,以评估潜在的潜在表示的信息内容,然后基于它的Q-VALUE函数可能具有正规化的一致优化方向。最后,策略梯度是典型的RL方法之一,用于训练层次VAE,而无需引入梯度估计器。1。简介实验结果坚定地支持我们的分析,并证明我们提出的方法有效地减轻了后塌陷问题,学习了信息的层次结构,获得了可解释的潜在表示,并且在下游任务中明显优于其他基于层次的VAE方法。
正规化参数不确定性,用于改善加强学习的概括
为了在现实世界中部署强化学习(RL)代理,它们必须能够推广到看不见的环境。但是,RL在分布外的概括方面挣扎,通常是由于过度拟合培训环境的细节。尽管可以应用监督学习的正则化技术来避免过度插入,但超级学习和RL之间的差异限制了其应用。为了解决这个问题,我们提出了RL的信噪比调节的参数不确定性网络(SNR PUN)。我们将SNR作为正规化网络的参数定向的新量度,并提供了正式分析,解释了SNR正则为什么对RL效果很好。我们证明了我们提出的方法在几个模拟环境中概括的有效性;在一个物理系统中,显示了使用SNR PUN将RL应用于现实世界应用程序的可能性。
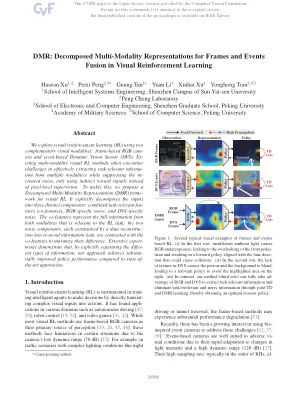
dmr:视觉增强学习中的框架和事件融合的分解多模式表示
我们使用两种互补视觉方式探索视觉增强学习(RL):基于框架的RGB凸轮和基于事件的动态视觉传感器(DVS)。iSTING多模式视觉RL方法在有效提取与任务相关的信息时经常遇到挑战。为了解决这个问题,我们提出了用于视觉RL的分解多模式表示(DMR)框架。它将输入分为三个不同的组成部分:与任务相关的效果(共同功能),RGB特异性噪声和DVS特异性噪声。共同创作表示与RL任务相关的两种模式中的完整信息;这两个噪声组件都受到数据重构损失以避免信息泄漏的约束,与共同创作形成对比,以最大程度地差异。广泛的经验表明,通过明确分开不同信息的类型,我们的方法可实现与最先进的方法相比,实质性改善的政策绩效。

具有自增强自适应性能的分级多孔钢整体结构
铁是一种丰富的化学元素,自古以来就以钢和铸铁的形式用于制造工具、器皿和武器。[1,2] 钢铁目前每年的产量为 1.4 亿吨,是人类文明中最广泛利用的材料之一。[1] 如此高的产量和当前加工技术的高碳足迹,使钢铁成为现代社会减少材料对环境影响的首选材料。[3] 虽然全世界的大部分钢铁生产都用于制造致密的建筑结构元件,但人们也在探索将多孔铁块用于催化、[4] 储能、[5] 组织再生 [6] 和结构应用。[7] 对环境影响较小的轻质结构的需求日益增长,人们对此类多孔金属以及它们对旨在更有效地利用自然资源的非物质化战略的潜在贡献的兴趣日益浓厚。海绵铁是通过将矿石在熔点以下直接还原而获得的,是多孔金属最早的例子之一。[8] 由于其强度相对较低,这种多孔铁在过去被用作制造致密结构的前体。多孔金属的低强度源于众所周知的材料强度和相对密度之间的权衡。[9] 根据 Gibson-Ashby 分析模型的预测,[10] 多孔和胞状结构的强度和刚度与固相相对密度 (φ) 呈幂律关系:P∼φm,其中 P 是关注的属性,m 是缩放指数。重要的是,高度多孔的大型结构(φ<0.20)通常表现出的刚度和承载能力远低于这种简单分析模型的预期水平。 [11] 事实上,实验和计算研究表明,当材料的相对密度接近其渗透阈值时,只有一小部分固相能有效地增加多孔结构的刚度。[12,13] 这是因为在多孔网络结构整体变形过程中存在未受载荷的悬挂元素。[14]
通过反强化学习的学徒学习
我们考虑在马尔可夫决策过程中学习,在马尔可夫决策过程中,我们没有明确地赋予重新功能,但是我们可以在这里遵守专家,以展示我们想学习的任务。此设置在应用程序(例如驾驶任务)中很有用,很难写下明确的奖励功能,以准确地指定应如何交易不同的desiderata。我们认为专家试图最大程度地发挥奖励功能,该奖励功能可作为已知功能的线性组合,并给出了一种学习专家所展示的任务的算法。我们的al-gorithm基于使用“逆增强学习”来试图恢复未知的奖励功能。我们表明,我们的算法终止了少数迭代,即使我们可能永远无法恢复专家的奖励功能,算法的策略也将达到与专家接近的绩效,在此,在此,相对于Expt exptt的未知奖励函数,在这里可以衡量。
具有人工智能规划模型的分层强化学习
两种常见的顺序决策方法是人工智能规划 (AIP) 和强化学习 (RL)。每种方法都有优点和缺点。AIP 具有可解释性,易于与符号知识集成,并且通常很高效,但需要预先指定逻辑域,并且对噪声敏感;RL 只需要指定奖励,并且对噪声具有鲁棒性,但样本效率低下,不易获得外部知识。我们提出了一种将高级规划与 RL 相结合的综合方法,保留了可解释性、迁移和效率,同时允许对低级规划操作进行鲁棒学习。我们的方法通过在 AI 规划问题的状态转换模型和马尔可夫决策过程 (MDP) 的抽象状态转换系统之间建立对应关系,从 AIP 运算符定义分层强化学习 (HRL) 中的选项。通过添加内在奖励来学习选项,以鼓励 MDP 和 AIP 转换模型之间的一致性。我们通过比较 MiniGrid 和 N 室环境中 RL 和 HRL 算法的性能来展示我们的集成方法的优势,展示了我们的方法相对于现有方法的优势。
基于深度强化学习的调度...
电气和电子工程师协会 › iel7 作者 VHL Lopes · 2022 · 被引用 1 — 作者 VHL Lopes · 2022 被引用 1 与信道建模和仿真相关,特别关注... 采用的块结构可以表示标准的多帧组织。 17 页

重新想象糖尿病护理报告2024
FitterFly是一家ISO-13485认证的数字健康公司,专门用于2型糖尿病的数字疗法。我们提供营养,健身,压力和睡眠管理的生活方式干预措施,旨在减少和维持健康的血糖水平和体重。我们结合了尖端技术和个性化的教练来做到这一点。我们的结果已在全球顶级糖尿病以及代谢健康会议和出版物上呈现和/或出版。