
XiaoMi-AI文件搜索系统
World File Search SystemSequence

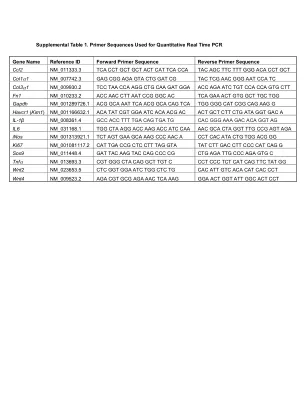
补充表1。用于定量实时PCR的引物序列
havcr1(kim1)NM_001166632.1 ACA TAT CGT GGA ATC ACA ACG ACG AC AC AC AC ACT GCT CTT CTG CTG ATA GGT GAC A


Illumina DNA准备(M)标记库准备在Illumina Miseq Sequencer
5。在E列中输入GDNA的量子浓度。6。确定将使用哪个索引套件。在J列中选择索引井位置。7。输入用于在F列中用于文库制备的提取的DNA的体积。基因组量已标准化DNA的起始体积至5μL(GDNA浓度为20-50 ng/μL),但是,建议的输入DNA的建议量为100-500 ng。我们的建议是使用至少100 ng的输入DNA。个别实验室可以调整输入DNA体积,以确保数量属于此范围内。建议的最小输入DNA为2μL,如果DNA过于浓缩,则执行稀释度以使输入DNA体积高于2μL并进行。

ali-u-net:用于DNA序列多个序列比对的卷积变压器神经网。概念证明
我们报告了能够对齐多个核苷酸序列的卷积变压器神经网络。神经网络基于图像分割中常用的U-NET,我们采用了该神经网络将其用于将未对准序列转换为对齐序列的U-NET。对于对齐场景,我们的ALI-U-NET神经网络已经接受过培训,在大多数情况下,它比MAFFT,T-Coffee,Muscle和Clustal Omega等程序更准确,同时比单个CPU核心上的类似准确的程序快得多。的限制是,神经网络仍针对某些对齐问题进行了专门训练,并且对于以前从未见过的差距分布而表现不佳。此外,该算法当前与48×48或96×96核苷酸的固定尺寸比对窗口一起工作。在此阶段,我们将研究视为概念证明,确信目前的发现可以扩展到更大的一致性,并在不久的将来将其扩展到更复杂的一致性方案。

数据主权和开放共享:重新考虑数字序列信息的利益分享和治理
围绕数据存在道德,法律和治理挑战,特别是在数字序列信息(DSI)的背景下。我关注的是国际框架的转变,这是CBD-COP15关于DSI收益分享的决定的例证,并讨论了人工智能和合成生物学时代的数据主权的越来越重要。以COVID-19的大流行的例子,开发了开放科学原则与数据控制权之间的张力。该意见还强调了尊重隐私和主权数据权的包容性和公平数据共享框架的重要性,强调需要国际合作和公平访问数据,以减少科学和技术进步方面的全球不平等现象。

基因组序列和评估乳酸杆菌CNCM I-4884
摘要:Johnsonii CNCM I-4884的益生菌菌株在体外和体内表现出抗牙齿活性。这项研究的目的是鉴定和表征Johnsonii CNCM I-4884的益生菌潜力及其安全评估。该菌株最初是基于16S基因序列分析将其分类为Gasseri的乳杆菌。整个基因组测序导致了L. johnsonii的重分类。对生物合成途径的全基因组搜索揭示了高度的合理营养,并通过大型运输和分解代谢系统平衡。该菌株还表现出对低pH和胆汁盐的耐受性,并显示出较强的胆汁盐水解酶(BSH)活性。测序结果表明缺乏抗菌抗性基因和其他毒力因子。表型测试证实,该菌株易于人类和动物相关性的8种抗生素。总的来说,在硅和体外结果中证实了约翰逊氏菌I-4884的cncm I-4884非常适合胃肠道环境,并且可以安全地用于益生菌配方中。
混合轻型态在拓扑超导体中与空腔光子搭配的
细菌“ candidatus nardonella dyophthoridicola”是一种革兰氏阴性的gam- maproteotototototabterial tocyobterial tocytobiont(图。1)。特别是,它是与象鼻虫相关的细胞内义务共同主义者(1)。通过向其宿主供应酪氨酸,细菌在表皮中起着至关重要的作用(2)。与第二个象鼻虫相关的符号不同,“ candidatus sodalis pierantonius”,它在宿主的整个生命周期中保持在功能性细菌中(3-5)。我们使用长阅读测序来研究“ Ca.nardonella dryophthoridicola”菌株nardrf,与意大利人种群相关的Rhynchophorus ferrugineus。2017年,昆虫宿主是从卡塔尼亚地区的一棵棕榈树中取样的。p在25°C,黑暗的24小时内,直到分成人。剖析了十个新出现的成年人以提取其细菌。然后按照制造商的动物组织提取说明,使用Dneasy血液和组织试剂盒(意大利Qiagen,意大利)合并细菌以进行DNA提取。在90V时通过0.8%琼脂糖凝胶电泳对DNA完整性进行了1H的验证。用纳米体100分光光度计(意大利的Thermo Fisher Scienti)和Qubit双链DNA(DSDNA)高敏化测定试剂盒测量了DNA纯度和浓度。使用R9.5流单元在奴才MK1B设备上进行了长阅读测序。使用Minknow V18.03.1进行测序48小时。读取量超过500 bp进行后续分析。重点识别为“ Ca.用于图书馆制备,使用1D连接测序试剂盒(SQK-LSK 108)原始Col使用了2.5 m g的非大量和非大小选择的总基因组DNA。然后,将最终DNA的0.5 m g加载到流动细胞上。基本调用,具有高准确性算法,质量截止值为7。所有工具均使用默认参数运行,除非另有说明。使用min-iasm(7)组装了元基因组fastq读取(主机和共生体)。nardonella dyophthoridicola”,以ncbi非冗余(NR)数据库进行鉴定。提取这些概念并用于重新填充组件。重叠群用于映射和提取“ Ca.nardonella dryophthoridicola”使用minimap2 v2.17(8)。然后使用Flye v2.8.1(9)重新组装836,116读。使用Circlator v1.5.5(10)与选项进行了循环 - Merge_Min_ID 85和 - Merge_breaklen 1000,如牛津Nanopore读取。使用公开的Illumina简短读数(SRA登录

MotifDb:蛋白质-DNA 结合序列基序的注释集合
tbl.tfClassExample <- data.frame(motifName=c("MA0006.1", "MA0042.2", "MA0043.2"), chrom=c("chr1", "chr1", "chr1"), start=c(1000005, 1000085, 1000105), start=c(1000013, 1000092, 1000123), score=c(0.85, 0.92, 0.98), stringsAsFactors=FALSE) # 这里我们说明如何添加具有所需名称的列:tbl.tfClassExample$shortMotif <- tbl.tfClassExample$motifName tbl.out <- associateTranscriptionFactors(MotifDb, tbl.tfClassExample, source="TFClass", expand.rows=TRUE) dim(tbl.out) # 许多 tfs 已映射,主要是 FOX 家族基因 tbl.motifDbExample <- data.frame(motifName=c("Mmusculus-jaspar2016-Ahr::Arnt-MA0006.1", "Hsapiens-jaspar2016-FOXI1-MA0042.2", "Hsapiens-jaspar2016-HLF-MA0043.2"), chrom=c("chr1", "chr1", "chr1"), start=c(1000005, 1000085, 1000105), start=c(1000013, 1000092, 1000123), score=c(0.85, 0.92, 0.98),字符串因子=FALSE)

氟康唑抗性的解脂耶氏酵母临床分离株 CBS 18115 的基因组序列草图
arrowia lipolytica 属于子囊菌门、酿酒菌亚门和双足菌科 (1)。除了工业用途 (2) 之外,Y. lipolytica 还广泛存在于食品、环境和动物中 (1)。由于其能够在 32°C 以上不稳定地生长,因此通常认为该菌种可安全用于工业用途 (1)。Yarrowia lipolytica 是一种机会性病原体,可引起侵袭性念珠菌病 (3)。在体外,该菌种被认为对氟康唑敏感 (4)。第一个 Y. lipolytica 基因组 (CLIB122) 于 2004 年发布 (5)。我们报告了对氟康唑有抗性的 Y. lipolytica 临床分离株的基因组草图,该分离株是从溃疡性结肠炎手术后的血培养中采集的。有趣的是,尽管之前曾接触过唑类药物,但使用梯度浓度试纸法(Etest;bioMérieux),该菌株的氟康唑 MIC 为 0.256 mg/mL。患者成功地用卡泊芬净治疗。该菌株在 35°C 的显色琼脂平板(CAN2;bioMérieux)上生长,并使用 Vitek 基质辅助激光解吸电离 - 飞行时间质谱 (MALDI-TOF MS) 仪器(bioMérieux)进行鉴定。在溶菌酶细胞壁消化后,使用 QIAmp DNA minikit(Qiagen)提取基因组 DNA。使用 Illumina DNA 制备标记试剂盒(Illumina)构建文库。简而言之,使用珠状转座子技术和集成 DNA 技术 (IDT) 的 Illumina DNA/RNA 独特双重 (UD) 索引集将 30 ng 总 DNA 片段化并进行索引。使用 Qubit 高灵敏度试剂盒 (Thermo Fisher Scienti ) 对文库进行扩增、纯化和定量。最后,将 9 pM 汇集和变性文库放入 2 250-bp v2 试剂盒 (Illumina) 中,并使用 MiSeq 仪器 (Illumina) 进行测序。使用 CLC Genomics Workbench v22.0 (Qiagen) 中的 Trim Reads v2.5 和 De Novo Assembly v1.5 工具对原始读取进行修剪、组装成重叠群并进行搭建。使用覆盖率与长度图丢弃覆盖率为 , 10 且长度为 , 500 bp 的重叠群 (6)。使用 QUAST v5.0.2 对最终的 scaffold 集进行质量分析 (7)。总基因组大小为 20,255,408 bp,分布在 521 个 scaffold 上(覆盖率为 100 ),N 50 值为 105 kbp(最长 scaffold,397 kbp),GC 含量为 49.03%。AUGUSTUS v3.4.0 (8) 使用白色念珠菌训练数据集预测了 6,151 个蛋白质编码基因,使用 tRNAscan-SE 2.0 检测到了 484 个 tRNA 基因 (9)。使用 BUSCO v5.3.2 和 saccharomycetes_odb10 谱系数据集 (10) 估计基因组完整性为 95.3%。平均核苷酸同一性 (ANI) 计算