XiaoMi-AI文件搜索系统
World File Search SystemView

沙漠勇士:海湾战争的个人观点
这本书由帕特里克·西尔(英国著名的中东问题专家,著有多本关于中东的优秀书籍)合著,读起来直截了当。将军的写作风格是严肃的,他的方法注重时间而非主题。这本书的前四分之一左右是广泛的背景介绍,涵盖了相当传统的传记细节,但确实让读者熟悉了作者和他的思维方式。随着将军晋升(速度很快——但他确实拥有沙特社会所必需的家庭关系)到更高指挥官,这本书变得越来越有趣。这本书的大部分内容涵盖了他对海湾战争展开的经历和想法、沙特统治精英的目标以及与盟军指挥官(尤其是施瓦茨科普夫将军)的迷人关系。对于
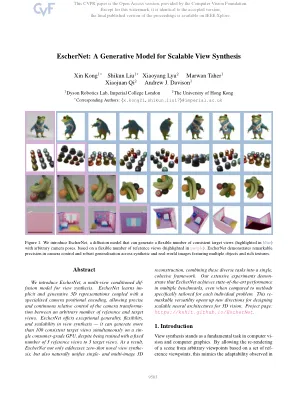
Eschernet:可扩展视图合成的生成模型
人类的视野。这种能力不仅对于诸如对象操纵和导航之类的实践日常任务至关重要,而且在培养人类创造力方面起着关键作用,使我们能够以深度,幽默感和沉浸感进行设想和制作对象。在本文中,我们重新审视了视图综合问题并提出:我们如何学习一般的3D表示以促进可扩展的视图综合?我们试图从以下两个观察结果中调查这个问题:i)到目前为止,目前的最新进展主要集中在训练速度和/或提高效率上[12,18,18,31,48]。值得注意的是,这些进步都共同依赖于体积渲染以进行场景优化。因此,所有这些视图合成方法固有地是场景特定的,再加上全局3D空间坐标。相比之下,我们主张一个范式移动,其中3D表示仅依赖场景颜色和几何形状,学习隐式表示无需地面真相3D几何形状,同时也从任何特定坐标系统中具有重要的独立性。这种区别对于实现可扩展性至关重要,以超越场景指编码所施加的约束。ii)本质上,视图合成更适合作为有条件的生成建模问题,类似于生成图像中的图像[25,60]。随着可用信息的增加,生成的场景变得更加限制,逐渐收敛于地面真相表示。仅给出一组稀疏的参考视图时,所需的模型应提供多个合理的预测,并利用生成表述中的固有随机性,并从自然图像统计信息和从其他图像和对象中学到的语义先验中获取见解。值得注意的是,现有的3D生成模型通常仅支持单个参考视图[20 - 23,44]。我们认为,更理想的生成配方应具有不同级别的输入信息。在这些见解的基础上,我们引入了Eschernet,这是一种图像到图像的条件扩散模型,用于视图合成。Eschernet利用了使用Dot-Product自我注意力的变压器体系结构[51],以捕获参考对目标和目标对目标视图一致性之间的复杂关系。Eschernet中的一个关键创新是相机位置编码(CAPE)的设计,专门代表4个DOF(以对象)和6个DOF相机姿势。这种编码的速率空间结构进入令牌,使模型能够仅基于其相对摄像机的转换来计算查询和密钥之间的自我注意事项。总而言之,Eschernet表现出以下非凡的特征:•一致性:埃舍内特固有地整合了视图的固定性,这要归功于相机位置编码的设计,从而鼓励了对目标对目标和目标视图视图的一致性。

卫星和地面视图之间的跨注意,以增强细粒度的机器人地理位置
跨视图图像地理位置定位旨在通过用GPS标记的卫星图像补丁绘制当前的街道视图图像来确定户外机器人的位置。最近的作品在识别卫星贴片中达到了显着的准确性,该卫星贴片在机器人所在,其中将中央像素在匹配的卫星贴片中用作机器人粗糙位置估计。这项工作着重于机器人在已知的卫星贴片中的细粒度定位。现有的细颗粒定位工作利用相关操作来获得卫星图像本地描述符和街道视图全局描述符之间的相似性。基于衬里匹配的相关操作简化了两个视图之间的相互作用过程,从而导致距离误差很大并影响模型的概括。为了解决这个问题,我们设计了一个具有自我注意力和跨注意层的跨视图功能fu-sion网络,以取代相关操作。此外,我们将分类和回归预测结合在一起,以进一步降低位置距离误差。实验表明,我们的新型网络体系结构的表现优于最先进的,可以在看不见的地区更好的概括能力。具体而言,我们的方法在同一区域和在活力基准的同一区域和看不见的区域中分别将中位定位距离误差降低了43%和50%。