
XiaoMi-AI文件搜索系统
World File Search Systemdata

数据结构 - (r18a0503) 讲义 b.tech ii 年
图。 了解有关搜索和排序技术的概念 UNIT-I 简介:抽象数据类型,单链表:定义、操作:遍历、搜索、插入和删除,双向链表:定义、操作:遍历、搜索、插入和删除,循环链表:定义、操作:遍历、搜索、插入和删除。 UNIT-II 堆栈:堆栈 ADT、数组和链表实现,应用程序-表达式转换和评估。队列:队列的类型:简单队列、循环队列、队列 ADT-数组和链表实现。优先队列、堆。 UNIT-III 搜索:线性和二进制搜索方法。排序:选择排序、冒泡排序、插入排序、快速排序、合并排序、堆排序。时间复杂度。图:基本术语、图的表示、图遍历方法 DFS、BFS。 UNIT IV 字典:线性列表表示、跳跃列表表示、操作 - 插入、删除和搜索。哈希表表示:哈希函数、冲突解决 - 单独链接、开放寻址 - 线性探测、二次探测、双重哈希、重新哈希、可扩展哈希。 UNIT-V 二叉搜索树:各种二叉树表示、定义、BST ADT、实现、操作 - 搜索、插入和删除、二叉树遍历、线程二叉树、AVL 树:定义、AVL 树的高度、操作 - 插入、删除和搜索 B 树:m 阶 B 树、B 树的高度、插入、删除和搜索、B+ 树。教科书:1. 使用 C++ 的数据结构,特别版-MRCET,Tata McGraw-Hill Publishers 2017。2. C++ 中的数据结构、算法和应用,S.Sahni,University Press (India) Pvt.Ltd,第 2 版,Universities Press Orient Longman Pvt. Ltd. 教育。
215310Orig1s000 - accessdata.fda.gov
NDA 多学科审查与评估 NDA 215,310 Mobocertinib(原名 TAK-788,AP32788) 第 7 页,共 286 页 表 22:合并既往铂类分析集和有或无既往抗 PD-(L)1 抗体的亚组的研究者评估的 cORR 和 DOR .............................................................................................................................137 表 23:重大方案偏差,主要疗效人群(FDA 表) .............................................................................................................................139 表 24:按亚组划分的客观缓解率(FDA 表) .............................................................................................144 表 25:多西他赛和 Mobocertinib 治疗结果总结 .............................................................................................147 表 26:携带 EGFR 外显子 20 插入突变的 NSCLC 患者使用 PD-(L)1 抑制剂和 Mobocertinib 治疗结果总结 ................................................................................................................................................................147 表 27:患者处置(所有分析人群;数据截止日期 2020 年 5 月 29 日)......................................................................................................152 表 28:患者研究药物暴露(所有分析人群;表 29:研究治疗时间和累积剂量(FDA 表) ......................................................................................................155 表 30:人口统计学特征(所有分析人群;数据截止日期 2020 年 5 月 29 日) .............................................................................................................156 表 31:基线特征(所有分析人群;数据截止日期 2020 年 5 月 29 日) .............................................................................................................157 表 32:研究中死亡情况总结(所有分析人群;数据截止日期 2020 年 5 月 29 日) .............................................................................................162 表 33:FDA 对合并安全性人群中与疾病进展不明确相关的治疗中出现的致命不良事件的因果关系评估(N=256)(FDA 表) ................................................................................................................................165 表 34:最常见(任何组中≥2% 的患者报告)按 SOC 和 PT 划分的治疗新出现的 SAE(所有分析人群;数据截止日期 2020 年 5 月 29 日).........................................................................................169 表 35:按 SOC 和 PT 划分的最常见(任何组内≥2% 的患者报告)治疗相关 SAE(所有分析人群;数据截止日期 2020 年 5 月 29 日).........................................................................................171 表 36:FDA 对导致主要安全人群 (n=114) 中停药的 TEAE 的分析(FDA 表).........................................................................173 表 37:FDA 对导致主要安全人群 (n=114) 中≥2% 的患者剂量中断和剂量减少的 TEAE 的分析(FDA 表)........................................................................................................................174 表 38:临床关注的 TEAE:搜索策略 ..............................................................175 表 39:临床关注的 TEAE – 总体、相关性、等级、严重性、停药(按安全性人群;数据截止日期 2020 年 5 月 29 日) .176 表 40:3 个安全性人群中 QTc 延长或室性心律失常 TEAE 患者的 FDA 分析(FDA 表) ................................................................................183
大脑和大型fMRI数据中功能性脑网络的层次结构建模
大规模脑成像数据集的一个主要目标是提供用于研究异质弹出的资源。从这些数据集中为各个受试者提供功能性脑网络的表征将具有预测认知或临床特征的巨大潜力。我们第一次提出了一种技术,即概率的功能模式(sprofumo),该技术可扩展到英国生物库(UKB),有预期的100,000名参与者,并且在个人和人群中层次估算了层次的功能性脑网络,同时对两种信息之间的双向流量进行了影响。使用仿真,我们显示了模型的效用,尤其是在涉及显着的跨主题可变性的情况下,或者需要在网络之间划定细粒度的差异。随后,通过将模型应用于4999名UKB受试者的静止状态fMRI,我们将静止状态网络(RSN)绘制为单个受试者,其详细范围比以前在UKB(> 100 rsns)中可能绘制了,并证明这些RSN可以预测somecorimotor andsocorimotor and somecorimotor and Emperife and Elighe colesions and Level Consoge。此外,我们证明了该模型的几个优点,而不是独立的组件分析与双重回归(ICA-DR)相结合,尤其是在估计RSN的空间配置和认知性状的预测能力方面。所提出的模型和结果可以为将来从大数据中对个性化的脑功能纤维进行调查打开新的门。

K200760.pdf - accessdata.fda.gov
贸易/设备名称:Rapid ASPECTS 法规编号:21 CFR 892.2060 法规名称:用于疑似癌症病变的放射学计算机辅助诊断软件 监管类别:II 类 产品代码:POK 日期:2020年5月23日 收到日期:2020年5月27日 亲爱的 Rosa 先生: 我们已审查了您根据第 510(k) 条提交的上市前通知,该通知表明您有意销售上述设备,并已确定该设备与在 1976 年 5 月 28 日(医疗器械修正案颁布日期)之前在州际贸易中合法销售的同类设备基本等同(就附件中规定的用途而言),或与根据《联邦食品药品和化妆品法案》(法案)的规定重新分类的设备基本等同,这些设备不需要获得上市前批准申请(PMA)的批准。因此,您可以根据该法案的一般控制规定销售该设备。虽然本函将您的产品称为设备,但请注意,一些已获准的产品可能是组合产品。位于 https://www.accessdata.fda.gov/scripts/cdrh/cfdocs/cfpmn/pmn.cfm 的 510(k) 上市前通知数据库可识别组合产品提交。该法案的一般控制条款包括年度注册、设备列表、良好生产规范、标签以及禁止贴错标签和掺假的要求。请注意:CDRH 不会评估与合同责任担保相关的信息。但我们提醒您,设备标签必须真实且不得误导。如果您的设备被归类(见上文)为 II 类(特殊控制)或 III 类(PMA),则可能会受到其他控制。影响您设备的现有主要法规可在《联邦法规》第 21 篇第 800 至 898 部分中找到。此外,FDA 可能会在《联邦公报》上发布有关您设备的进一步公告。请注意,FDA 发布实质等效性判定并不意味着 FDA 已判定您的设备符合该法案的其他要求或其他联邦机构管理的任何联邦法规和规章。您必须遵守该法案的所有要求,包括但不限于:注册和登记(21 CFR 第 807 部分);标签(21 CFR 第 801 部分);医疗器械报告(医疗器械相关不良事件报告)(21 CFR 803)

4 美国食品和药品 - accessdata.fda.gov
请注意,FDA 发布的实质等同性认定并不意味着 FDA 已认定您的器械符合该法案的其他要求或其他联邦机构管理的任何联邦法规。您必须遵守该法案的所有要求,包括但不限于:注册和列名(21 CFR 第 807 部分);标签(21 CFR 第 801 部分);器械的医疗器械报告(医疗器械相关不良事件报告)(21 CFR 803)或组合产品的上市后安全报告(21 CFR 4,子部分 B)(请参阅https://www.fda.gov/combination-products/guidance-regulatory-information/postmarketing-safety-reporting-combination-products);器械质量体系 (QS) 法规(21 CFR 第 820 部分)中规定的良好生产规范要求或组合产品的现行良好生产规范(21 CFR 4,子部分 A);以及如果适用的话,电子产品辐射控制规定(该法第531-542节);21 CFR 1000-1050。

研究论文 使用反向传播神经网络对高光谱遥感数据中的岩性信息进行提取和分类
为了解决高光谱遥感数据处理中遇到的同构问题,提高高光谱遥感数据在岩性信息提取与分类的精度,以岩石为研究对象,引入反向传播神经网络(BPNN),对高光谱图像数据进行归一化处理后,以岩性光谱与空间信息为特征提取目标,构建基于深度学习的岩性信息提取模型,并使用具体实例数据分析模型的性能。结果表明:基于深度学习的岩性信息提取与分类模型总体精度为90.58%,Kappa系数为0.8676,能够准确区分岩体性质,与其他分析模型相比具有较好的性能。引入深度学习后,提出的BPNN模型与传统BPNN相比,识别精度提高了8.5%,Kappa系数提高了0.12。所提出的提取及分类模型可为高光谱岩矿分类提供一定的研究价值和实际意义。
在环境DNA方法中的最新数据分析用于其适用于可持续的薄壁炉管理
使用海洋环境DNA(EDNA)方法进行的越来越多的研究通过帮助和简化评估被剥削的人群和生态系统状况所需的一些劳动密集型传统调查,显示了其在海洋渔业管理中的潜在应用。Edna接近(即 metabarcoding and Targeed)可以通过提供有关物种组成的信息来支持基于生态系统的薄片管理;侵入性,稀有和/或濒危物种的监视;并提供物种丰度的估计。 由于这些潜在用途和保护科学的潜在用途,在过去几年中,在海洋栖息地中应用EDNA方法的研究数量有所扩大。 但是,在应用管道进行数据分析时,整个研究缺乏一致性,这使得结果很难比较它们。 这种缺乏一致性的部分原因是在原始序列数据的管理中知识不足以及允许比较结果的分析方法引起的。 因此,我们在这里审查EDNA数据处理和分析的基本步骤,以获得声音,可重现和可比的结果,从而提供了一组对每个步骤有用的生物信息学工具。 总的来说,本评论介绍了EDNA数据分析的艺术状态,以促进可持续性的盗版管理中的全面应用。Edna接近(即metabarcoding and Targeed)可以通过提供有关物种组成的信息来支持基于生态系统的薄片管理;侵入性,稀有和/或濒危物种的监视;并提供物种丰度的估计。由于这些潜在用途和保护科学的潜在用途,在过去几年中,在海洋栖息地中应用EDNA方法的研究数量有所扩大。但是,在应用管道进行数据分析时,整个研究缺乏一致性,这使得结果很难比较它们。这种缺乏一致性的部分原因是在原始序列数据的管理中知识不足以及允许比较结果的分析方法引起的。因此,我们在这里审查EDNA数据处理和分析的基本步骤,以获得声音,可重现和可比的结果,从而提供了一组对每个步骤有用的生物信息学工具。总的来说,本评论介绍了EDNA数据分析的艺术状态,以促进可持续性的盗版管理中的全面应用。
与EEG和眼睛跟踪数据的跨主题阅读任务分类的Zuco基准
我们提出了一个新的机器学习基准,用于阅读任务分类,目的是在计算语言处理与认知神经科学之间的相交中推进脑电图和眼睛追踪研究。基准任务由一个跨主体分类组成,以区分两个阅读范式:正常阅读和特定于任务的读数。基准的数据基于苏黎世的认知语言处理语料库(ZUCO 2.0),该语料库提供了同时引人注目的视线和来自英语句子的自然阅读的EEG信号。培训数据集已公开可用,我们提出了新记录的隐藏测试集。我们为此任务提供多种可靠的基线方法,并讨论未来的改进。我们发布代码,并提供易于使用的界面,以使用随附的公共排行榜:www.zuco-benchmark.com评估新方法。

多级数据驱动的电池管理
个性化和精确药物的长期目标是为具有疾病的患者准确预测给定治疗方案的结果。目前,由于患者群体中的潜在因素导致对感兴趣的药物的反应或对治疗相关的不良事件的反应不佳,因此许多临床试验无法满足其终点。事先确定这些因素并纠正它们可能会导致临床试验的成功增加。通过对健康和患病个体的OMICS进行综合和大规模的数据收集工作,导致了宿主,疾病和环境因素的宝藏,这有助于旨在治疗疾病的药物的有效性。随着OMICS数据的增加,人工智能允许对大数据进行深入分析,并为现实世界中的临床使用提供了广泛的应用,包括改善患者的选择和鉴定可行的伴侣疗法靶标,以改善更多患者的可转换性。作为用于复杂药物疾病 - 宿主相互作用的蓝图,我们在这里讨论了使用OMICS数据预测使用免疫检查点抑制剂(ICIS)预测癌症免疫疗法的反应和不良事件的挑战。基于OMICS的方法是改善患者结局的方法,因为在ICI病例中也已应用于广泛的复杂疾病环境中,体现了OMIC在深度疾病分析和临床使用中的使用。
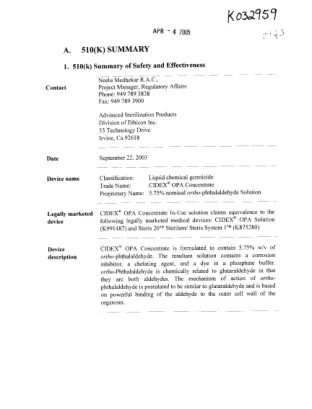
A. 510(K) 摘要 - accessdata.fda.gov
CIDEX® OPA 浓缩液是一种高水平消毒剂 (HLD),按照使用说明使用时,最低使用浓度为 0.055%,在 50 0 C 下接触时间为 5 分钟,可用于再处理热敏感 (<600C) 半临界内窥镜。