
XiaoMi-AI文件搜索系统
World File Search System3D
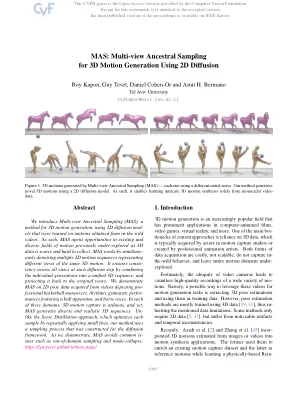
MAS:使用2D扩散
我们使用2D扩散模型引入了多视图祖传采样(MAS),这是一种3D运动生成的方法,这些方法是根据从野外视频中获得的动作进行训练的。因此,MAS为以前探索了3D数据而稀缺且难以收集的机会为令人兴奋和多样化的运动领域打开了机会。MAS通过同时降低多个2D运动序列来起作用,代表了同一3D运动的不同视图。它通过将单个世代组合到统一的3D序列中,并将其投影回原始视图,从而确保每个扩散步骤中所有视图的共识。我们在2D姿势数据上展示了MAS,从描述了演习篮球运动的视频中获取的数据,节奏的体操在带有球设备的节奏和赛马。在这些域中的每个域中,3D运动捕获都很艰难,但是,MAS生成了多样化和现实的3D序列。不喜欢分数蒸馏方法,该方法通过反复应用小固定来优化每个样品,我们的方法使用了为扩散框架构建的采样过程。正如我们所证明的那样,MAS避免了常见的措施,例如室外采样和模式折叠。https://guytevet.github.io/mas-page/
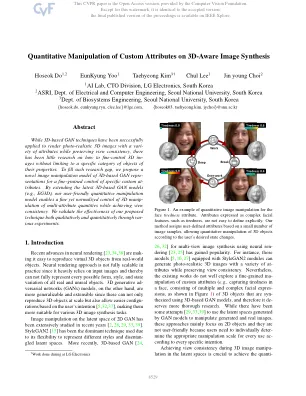
3D感知图像合成上自定义属性的定量操纵
尽管基于3D的GAN技术已成功地应用于具有各种属性的照片真实的3D图像,同时保持视图一致性,但很少有关于如何罚款3D impersimens的研究,而不会限制其属性特定对象的特定对象类别。为了填补此类研究空白,我们提出了一个基于3D的GAN代表的新型图像操纵模型,以对特定的自定义贡献进行细粒度控制。通过扩展最新的基于3D的GAN模型(例如,EG3D),我们的用户友好定量操作模型可以实现对3D操作多属性数量的精细而归一化的控制,同时实现了视图一致性。我们通过各种实验验证了我们提出的技术的有效性。
3D图像分割的拓扑感知焦点损失
分割算法的疗效经常因拓扑错误,连接中断和空隙等拓扑错误而受到损害。为了解决这一问题,我们引入了一种新颖的损失函数,即拓扑 - 意识局灶性损失(TAFL),该功能将基于基于地面真实和预测段蒙版的持久性图表之间的拓扑结构术语与拓扑结构术语结合在一起。通过实施与地面真理相同的拓扑结构,拓扑的约束可以有效地解决拓扑结构,而焦点损失可以解决阶级失衡。我们首先是从地面真理和预测的分割掩模的过滤的立方复合物中构造持久图。随后,我们利用sindhorn-knopp算法来确定两个持久图之间的最佳运输计划。最终的运输计划最小化了将质量从一个分布到另一个分布的运输成本,并在两个持久图中的点之间提供了映射。然后,我们根据该旅行计划计算沃斯堡的距离,以测量地面真相和预测的面具之间的拓扑差异。我们通过训练3D U-NET与MICCAI脑肿瘤分割(BRATS)CHALLENE验证数据集来评估我们的方法,该数据需要准确地分割3D MRI扫描,从而整合各种方式,以精确鉴定和跟踪恶性脑肿瘤。然后,我们证明,通过添加拓扑约束作为惩罚项,通过将焦点损失正规化来提高分段性能的质量。
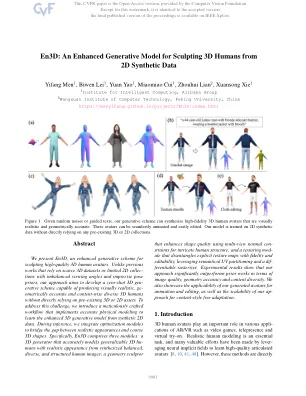
en3d:从2D合成数据雕刻3D人类的增强生成模型
我们提出了EN3D,这是一种增强的生成方案,用于雕刻高质量的3D人体化身。Unlike previous works that rely on scarce 3D datasets or limited 2D collec- tions with imbalanced viewing angles and imprecise pose priors, our approach aims to develop a zero-shot 3D gen- erative scheme capable of producing visually realistic, ge- ometrically accurate and content-wise diverse 3D humans without directly relying on pre-existing 3D or 2D assets.为了应对这一挑战,我们引入了精心制作的工作流量,该工程实现了准确的物理建模,以从合成2D数据中学习增强的3D生成模型。在推断期间,我们集成了优化模块,以弥合现实的外观和粗3D形状之间的差距。特定于EN3D包含三个模块:一个3D发电机,可以准确地对可概括的3D Humans建模具有合成,多样和结构化的人类图像的逼真外观的可概括的3D Humans;几何雕塑家

通过聚合物3D打印来调整建筑物外墙的太阳能:朝向定制的热特性
立面是控制建筑物太阳能流并影响其能量平衡和环境影响的主要接口。最近,已经探索了半透明聚合物的大规模3D打印(3DP),作为一种制造具有定制特性和功能的立面组件的技术。透射率对于建筑外墙至关重要,因为对太阳辐射的响应对于获得舒适感至关重要,并且会极大地影响电力和冷却需求。但是,仍不清楚3DP参数如何影响半透明聚合物的光学性质。本研究建立了一个实验程序,将PETG组件的光学特性与设计和3DP参数相关联。观察到打印参数控制层沉积,该沉积控制层中的内部光散射和整体光传输。此外,层分辨率决定角度依赖性属性。表明,可以调整打印参数以获得量身定制的光学特性,从高正常透明度(≈90%)到透明度(≈60%),并且具有一定范围的雾霾水平(≈55-97%)。这些发现为大规模3DP的定制立面提供了机会,可以有选择地接纳或阻止太阳辐射,并提供空间的均匀日光。在建筑部门脱碳的背景下,这种组件具有减少排放的巨大潜力,同时确保乘员舒适。

Zignerf:带有可逆生成神经辐射场
生成的神经辐射场(NERF)通过学习一组未经未介绍的图像的分布来综合多视图图像,表现出非常熟练的熟练程度。尽管现有的生成nerf具有在数据分布中生成3D一致的高质量随机样本的才能,但创建单数输入图像的3D表示仍然是一个巨大的挑战。在此手稿中,我们介绍了Zignerf,这是一种创新的模型,该模型执行零击生成的对抗网(GAN)倒置,以从单个脱离分布图像中生成多视图。该模型的基础是一个新型逆变器的基础,该逆变器映射到了发电机歧管的潜在代码中。毫无意义,Zignerf能够将对象从背景中解散并执行3D操作,例如360度旋转或深度和水平翻译。使用多个实数数据集对我们的模型的效率进行验证:猫,AFHQ,Celeba,Celeba-HQ和Compcars。

egecentric 3D手姿势估计的单一对偶视图改编
对准确的3D手姿势估计的追求是理解以自我为中心视力领域的人类活动的基石。大多数现有估计方法仍然依赖单视图像作为输入,从而导致潜在的局限性,例如,深度有限的视野和义务。解决这些问题,添加另一个相机以更好地捕获手的形状是实践方向。然而,现有的多视图手姿势姿势方法具有两个主要缺点:1)重新训练的多视图注释,这些注释是备用的。2)在测试过程中,如果相机参数/布局与训练中使用的相同,则模型将变为inpapplicable。在本文中,我们提出了一种新颖的单算观看改编(S2DHAND)解决方案,该解决方案将预先训练的单视估计器适应双视图。与现有的多视图训练方法相比,1)我们的适应过程是无监督的,消除了对多视图注释的需求。2)此外,我们的方法可以处理带有未知相机参数的Arbitarary双视图对,从而使该模型适用于不同的相机设置。具体来说,S2DHAND建立在某些立体声约束上,包括两种视图之间的成对跨视图共识和转换的不变性。这两个立体声约束以互补的方式使用来进行伪标记,从而允许可靠的适应性。评估结果表明,在内部和跨数据库设置下,S2DHAND在任意摄像机对上实现了重大的实现,并且胜过具有领先性能的现有适应方法。项目页面:https://github.com/ut-vision/s2dhand。

通过零件式层次结构消息传递
生成的3D部分组装涉及了解零件关系,并预测其6-DOF姿势,用于组装逼真的3D形状。先前的工作通常集中在各个部分的几何形状上,忽略了整个物体的零件。利用两个关键的观察:1)超级部分姿势提供了有关零件姿势的强烈提示,而2)由于较少的超级部分,预测超级零件的姿势更容易,我们提出了一个零件 - 整个层次结构消息传递网络,以实现有效的3D零件组件。我们首先通过在没有任何语义标签的情况下对几何相似部分进行分组,从而引入超级零件。然后,我们采用零件整体的层次编码器,其中超级零件编码器预测基于输入部分的潜在超级零件姿势。随后,我们使用潜在姿势转换点云,将其馈送到零件编码器中,以汇总超级零件信息和有关零件关系的推理以预测所有部分姿势。在培训中,仅需要地面零件姿势。在推断期间,超级零件的预测潜在可增强可解释性。Partnet数据集上的实验结果表明,我们的方法可以部分地达到最新的功能和连接精度,并实现可解释的层次结构组件。代码可在https://github.com/pkudba/3dhpa上找到。

从文本说明中生成人类运动
由于其广泛的应用范围,从文本描述中产生人类动作已引起了越来越多的研究兴趣。但是,只有少数作品将人类场景的互动与文本条件一起考虑,这对于视觉和物理现实主义至关重要。本文提出了在3D门场景中产生人类动作的任务,鉴于人类习惯的文本描述。由于文本,场景和运动的多种形式性质以及对空间推理的需求,此任务提出了挑战。为了应对这些挑战,我们提出了一种新方法,将复杂的概率分解为两个更可管理的子问题:(1)目标对象的语言接地和(2)以对象为中心的信息产生。对于目标对象的语言基础,我们利用大型语言模型的力量。对于运动生成,我们设计了一个以对象为中心的场景代表生成模型,以专注于目标对象,从而降低场景的复杂性并促进人类运动与对象之间关系的建模。实验证明了与基准相比,我们的方法的更好运动质量并验证了我们的设计选择。代码将在链接上可用。