
XiaoMi-AI文件搜索系统
World File Search SystemDiffusion

使用扩散模型在潜在空间中进行图像修复
使用扩散模型进行图像修复通常使用预条件模型(即针对绘画任务进行微调的图像条件模型)或后条件模型(即在推理时重新用于绘画任务的非条件模型)。预条件模型在推理时很快,但训练成本极高。后条件模型不需要任何训练,但在推理过程中很慢,需要多次前向和后向传递才能收敛到理想的解决方案。在这里,我们推导出一种不需要昂贵训练但推理速度很快的方法。为了解决昂贵的推理计算时间,我们在潜在空间而不是图像空间上执行前向-后向融合步骤。这是通过扩散过程中新提出的传播模块解决的。在多个领域进行的实验表明,我们的方法达到或改善了状态
基于扩散模型的机器人视觉运动策略学习
背景和动机视觉策略学习涉及将视觉观察映射到运动动作上,使机器人能够有效地与环境互动。传统方法通常在多模式作用分布的复杂性以及对高精度和时间一致性的需求中挣扎。最近引入的扩散策略通过采用有条件的降级扩散过程来生成机器人动作,从而提供了有希望的解决方案。这些模型在产生复杂的行为方面表现出了卓越的性能,使其成为机器人操纵和组装任务的理想候选人。此外,整合自然语言处理(NLP)允许多功能任务调理,使机器人能够根据人类指令执行各种任务。
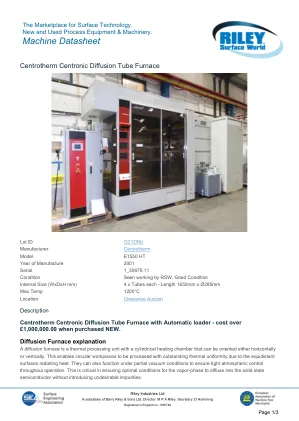
Centrotherm Centronic扩散管炉
扩散炉是一个热处理单元,具有圆柱加热室,可以水平或垂直定向。由于等距表面辐射热量,因此可以通过出色的热均匀性处理圆形工件。它们也可以在部分真空条件下发挥作用,以确保整个操作中的大气控制。这对于确保蒸气相扩散到固态半导体的情况下而无需引入不良杂质的最佳条件至关重要。

通过跳跃扩散驱动的神经SDE的多变量时间序列建模
在数据科学和机器学习的不断发展的景观中,时间序列建模的领域已成为一个重要且挑战性的研究领域。时间序列数据及其独特的时间依赖性和顺序模式,在金融,医疗保健和气候科学等各个领域中找到了应用[1,2,3]。时间序列的准确建模对于创建强大的模型和理解复杂系统至关重要。建模时间序列的一种方法是通过生成模型[4],该模型在异常检测[5]和数据增强[6]中具有实际应用。在本文中,我们提出了一种基于时间序列生成和建模的神经SDE的新颖方法。尤其是,我们旨在创建一个可以利用默顿模型[3]作为跳跃框架的模型,该模型可以考虑实际市场的跳跃。归一化流是具有易生化密度估计的生成模型家族。主要思想是通过组成几个函数f i将初始复杂的数据分散分散转换为一个简单的想法。有一些

布局 - 敏捷场景文本图像综合与扩散模型
虽然扩散模型已显着提高了图像生成的质量,但它们在这些图像中准确且相干渲染文本的能力仍然是一个重大挑战。场景文本生成的常规基于扩散的方法通常受到对中间布局输出的依赖的限制。这种依赖性通常会导致文本样式和字体的多样性限制,这是布局生成阶段的确定性质所引起的固有限制。为了应对这些挑战,本文介绍了SceneTeTgen,这是一种基于新颖的扩散模型,专门设计用于规避预定义布局阶段的需求。这样做,场景 - 文本促进了文本的更自然和多样化的代表。SceneTextGen的新颖性在于其三个关键组成部分的整体:一个字符级编码器,用于捕获详细的印刷属性,并与字符级实例分割模型和Word-

gpld3d:通过执行几何学和物理先验
扩散概率模型(DDPM)[39,40],通过开发合适的3D表示,例如,体积网格[50],点云[3,53],三角形网格[24,32],隐式含量[24,32],隐式代表[12,28,36,36,36,36,56,36,56,36,36,36,56)。但是,这些生成模型的一个共同主题是匹配由训练数据定义的经验分布以及从潜在空间的先前分布中得出的诱导分布。这些方法在3D域中对下游应用程序至关重要的3D域中没有明确模型。考虑使用隐式形状代表的许多状态形状发生器。合成形状通常具有断开的作品,并具有其他物理稳定性和几何可行性的问题。现有技术的一个主要问题是,他们只看到培训实例,这是一组非常稀疏的样本。但是,它们没有对合成实例的几何和物理特性进行建模。这种问题不容易通过开发合适的神经代表来解决。随着人造形状具有多种拓扑结构,在可以对不同拓扑结构建模的代表下执行这些属性,例如隐式表面和点云仍然非常具有挑战性。在本文中,我们介绍了一种名为GPLD3D的新颖方法,该方法极大地增强了合成形状的几何学性和物理稳定性。考虑一个预先训练的生成模型,该模型将潜在空间映射到形状空间。我们将潜在扩散范式[12,34,36,56]证明是一种最先进的形状基因产生模型。与训练一个扩散模型不同,该模型将潜在空间的高斯分布映射到由训练形状的潜在代码定义的经验分布,我们介绍了一个潜在代码的优质检查器,以定义潜在空间的连续正规化分布。此质量检查器集成了一个学到的功能,该功能量化了合成形状的几何可行性评分以及量化其物理稳定性评分的刚度ma-Trix的光谱特性。我们展示了如何扩展最新的扩散框架EDM [20],以整合数据分布和学习质量的denoising网络的质量检查器。关键贡献是一种原则性的方法,它决定了数据分散的损失条款与不同噪声水平的质量检查器之间的权衡参数。我们已经评估了shapenet-v2上GPLD3D的性能[6]。实验结果表明,在多个指标上,GPLD3D显着优于最先进的形状发生器。我们还提出了一项消融研究,以证明合并质量检查器并优化训练损失的超参数的重要性。

训练扩散模型通过增强学习
扩散模型在图像生成中表现出了前所未有的ca。然而,它们从原始训练集中纳入并扩大了数据偏差(例如性别,年龄),从而限制了产生的IMEG的多样性。在本文中,我们在基于图像集的重新函数的指导下,使用增强学习(RL)提出了一种面向多样性的细调方法(RL)。具体而言,所提出的奖励函数(表示为多样性奖励),利用一组生成的信息来评估当前生成分配W.R.T.的覆盖范围。参考分布,由一组无偏见的图像表示。建立在分布差异估计的概率方法的基础上,差异奖励可以有效地用一小部分图像来测量相对分布差距。我们进一步将扩散过程作为多步决策问题(MDP),并通过最大化多样性奖励来应用策略梯度方法来微调扩散模型。在放样后选择任务上验证了奖励,其中根据多样性奖励值选择了最多样化的图像的子集。我们还展示了我们的RL微调框架的有效性,可以通过不同类型的扩散模型(包括班级条件模型和文本条件模型,例如stablediffusion)增强图像生成的多样性。
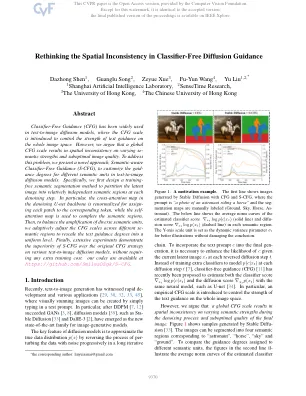
重新考虑无分类器扩散指导中的空间不一致
无分类器指导(CFG)已广泛用于文本到图像扩散模型中,其中引入了CFG量表以控制整个图像空间的文本指导强度。但是,我们认为全球CFG量表会导致空间不一致,这是不同的脱节优势和次优的图像质量。为了解决这个问题,我们提出了一种新颖的方法,即语义意识的无分类器指导(S-CFG),以自定义文本到图像扩散模型中不同语义单元的指导学位。具体来说,我们首先设计了一种训练 - 免费的语义分割方法,将潜在图像分配到每个Denoising步骤中相对独立的语义区域。尤其是,将U-NET主链中的跨意义图被重新归一化,以将每个贴片分配给相应的令牌,而自我注意力图则用于完成语义区域。然后,为了平衡各种语义单元的扩增,我们会自适应地调整各个不同区域的CFG尺度,以将文本指导学度重新确定为统一水平。最后,广泛的实验证明了S-CFG优于原始CFG策略在各种文本到图像扩散模型上的优越性,而无需任何额外的培训成本。我们的代码可在https://github.com/smilesdzgk/s-cfg上找到。
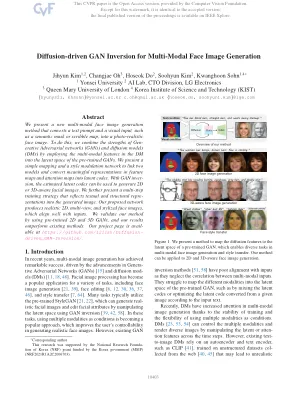
多模式面部图像生成的扩散驱动的GAN倒置
摘要我们提出了一种新的多模式面部图像生成方法,该方法将文本提示和视觉输入(例如语义掩码或涂鸦图)转换为照片真实的面部图像。为此,我们通过使用DM中的多模式特征在预训练的GAN的潜在空间中使用多模式特征来结合一般的对抗网络(GAN)和扩散模型(DMS)的优势。我们提供了一个简单的映射和一个样式调制网络,可将两个模型链接起来,并在特征地图和注意力图中将有意义的表示形式转换为潜在代码。使用gan inversion,估计的潜在代码可用于生成2D或3D感知的面部图像。我们进一步提出了一种多步训练策略,该策略将文本和结构代表反映到生成的图像中。我们提出的网络生成了现实的2D,多视图和风格化的面部图像,这些图像与输入很好。我们通过使用预训练的2D和3D GAN来验证我们的方法,我们的结果表现优于现有方法。我们的项目页面可在https://github.com/1211SH/diffusion-driven_gan-inversion/。