
XiaoMi-AI文件搜索系统
World File Search SystemDiffusion
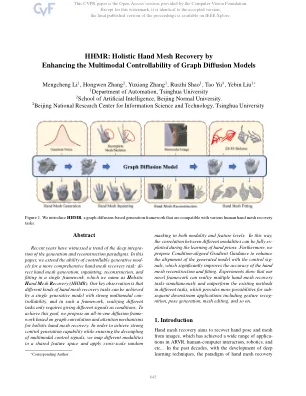
HHMR:通过增强图扩散模型的多模式可控性
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机
基于扩散模型的机器人视觉运动策略学习
背景和动机视觉策略学习涉及将视觉观察映射到运动动作上,使机器人能够有效地与环境互动。传统方法通常在多模式作用分布的复杂性以及对高精度和时间一致性的需求中挣扎。最近引入的扩散策略通过采用有条件的降级扩散过程来生成机器人动作,从而提供了有希望的解决方案。这些模型在产生复杂的行为方面表现出了卓越的性能,使其成为机器人操纵和组装任务的理想候选人。此外,整合自然语言处理(NLP)允许多功能任务调理,使机器人能够根据人类指令执行各种任务。

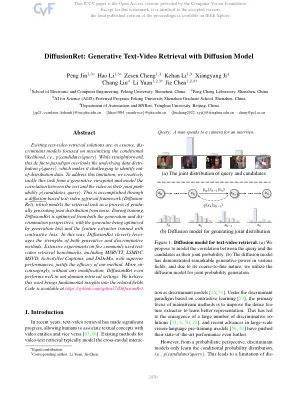
具有扩散模型的生成文本视频检索
现有的文本视频检索解决方案本质上是侧重于最大程度地提高条件可能性的模型,即P(候选人|查询)。虽然很简单,但这种事实上的范式却忽略了基本的数据分布p(查询),这使得识别出分布数据的挑战。为了解决这一限制,我们从生成观点创造性地解决了此任务,并将文本和视频之间的相关性建模为其关节概率P(候选人,查询)。这是通过基于扩散的文本视频检索框架(扩散-RET)来完成的,该框架将检索任务建模为从噪声中产生关节分布的过程。在训练过程中,从发电和犯罪的角度优化了Diffusionret,其发电机通过生成损失优化,并且具有对比度损失的训练的特征提取器。以这种方式,diffusionret巧妙地杠杆化了生成和歧视方法的优势。在五个常用的文本检索基准测试中进行了广泛的实验,包括MSRVTT,LSMDC,MSVD,ActivityNet字幕和DIDEMO,并具有出色的性能,证明了我们方法的效果。更加谨慎,没有任何修改,diffusionret甚至在外域检索设置中表现良好。我们认为这项工作带来了对相关领域的基本见解。代码可从https://github.com/jpthu17/diffusionret获得。
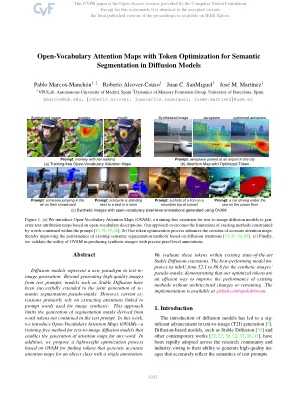
在扩散模型中使用令牌优化的开放式摄取注意图
扩散模型代表文本到图像生成中的新范式。除了从文本提示中生成高质量的图像之外,诸如稳定扩散之类的模型已成功扩展到了共同生成的分段伪遮罩。但是,当前的敏感主要依赖于提取与用于图像合成的及时单词相关的关注。这种方法限制了从文本提示中未包含的单词代币中得出的分割掩码的产生。在这项工作中,我们介绍了开放式摄影注意力图(OVAM) - 用于文本到图像扩散模型的无训练方法,可为任何单词生成注意力图。此外,我们提出了一个基于OVAM的轻巧优化过程,用于查找具有单个注释的对象类的准确注意图。

带有扩散模型的视频插值-CVF Open Access
我们提出了Vidim,这是一个视频间隔的生成模型,该模型在启动和最终框架下创建了简短的视频。为了实现高保真度并在输入数据中产生了看不见的信息,Vidim使用级联的分化模型首先以低分辨率生成目标视频,然后在低分辨率生成的视频上生成高分辨率视频。我们将视频插补的先前最新方法归纳为先前的最新方法,并在大多数设置中演示了这种作品如何在基础运动是复杂,非线性或模棱两可的情况下失败,而Vidim可以轻松处理此类情况。我们还展示了如何在开始和最终框架上进行无分类器指导,并在原始高分辨率框架上调节超级分辨率模型,而没有其他参数可以解锁高保真性结果。vidim可以从共同降低所有要生成的框架,每个扩散模型都需要少于十亿个pa-rameters来产生引人注目的结果,并且仍然可以在较大的参数计数下享有可扩展性和提高质量。请在vidim- Interpolation.github.io上查看我们的项目页面。

gpld3d:通过执行几何学和物理先验
扩散概率模型(DDPM)[39,40],通过开发合适的3D表示,例如,体积网格[50],点云[3,53],三角形网格[24,32],隐式含量[24,32],隐式代表[12,28,36,36,36,36,56,36,56,36,36,36,56)。但是,这些生成模型的一个共同主题是匹配由训练数据定义的经验分布以及从潜在空间的先前分布中得出的诱导分布。这些方法在3D域中对下游应用程序至关重要的3D域中没有明确模型。考虑使用隐式形状代表的许多状态形状发生器。合成形状通常具有断开的作品,并具有其他物理稳定性和几何可行性的问题。现有技术的一个主要问题是,他们只看到培训实例,这是一组非常稀疏的样本。但是,它们没有对合成实例的几何和物理特性进行建模。这种问题不容易通过开发合适的神经代表来解决。随着人造形状具有多种拓扑结构,在可以对不同拓扑结构建模的代表下执行这些属性,例如隐式表面和点云仍然非常具有挑战性。在本文中,我们介绍了一种名为GPLD3D的新颖方法,该方法极大地增强了合成形状的几何学性和物理稳定性。考虑一个预先训练的生成模型,该模型将潜在空间映射到形状空间。我们将潜在扩散范式[12,34,36,56]证明是一种最先进的形状基因产生模型。与训练一个扩散模型不同,该模型将潜在空间的高斯分布映射到由训练形状的潜在代码定义的经验分布,我们介绍了一个潜在代码的优质检查器,以定义潜在空间的连续正规化分布。此质量检查器集成了一个学到的功能,该功能量化了合成形状的几何可行性评分以及量化其物理稳定性评分的刚度ma-Trix的光谱特性。我们展示了如何扩展最新的扩散框架EDM [20],以整合数据分布和学习质量的denoising网络的质量检查器。关键贡献是一种原则性的方法,它决定了数据分散的损失条款与不同噪声水平的质量检查器之间的权衡参数。我们已经评估了shapenet-v2上GPLD3D的性能[6]。实验结果表明,在多个指标上,GPLD3D显着优于最先进的形状发生器。我们还提出了一项消融研究,以证明合并质量检查器并优化训练损失的超参数的重要性。
重新思考多重对比 MRI 超级扩散模型...
最近,扩散模型 (DM) 已应用于磁共振成像 (MRI) 超分辨率 (SR) 重建,并表现出令人印象深刻的性能,尤其是在细节重建方面。然而,当前基于 DM 的 SR 重建方法仍然面临以下问题:(1)它们需要大量迭代来重建最终图像,效率低下且消耗大量计算资源。(2)这些方法重建的结果通常与真实的高分辨率图像不一致,导致重建的 MRI 图像出现明显失真。为了解决上述问题,我们提出了一种用于多对比 MRI SR 的有效扩散模型,称为 DiffMSR。具体而言,我们在高度紧凑的低维潜在空间中应用 DM 来生成具有高频细节信息的先验知识。高度紧凑的潜在空间确保 DM 只需要几次简单的迭代即可产生准确的先验知识。此外,我们设计了 Prior-Guide Large Window Transformer (PLWformer) 作为 DM 的解码器,它可以扩展感受野,同时充分利用 DM 产生的先验知识,以确保重建的 MR 图像保持不失真。在公共和临床数据集上进行的大量实验表明,我们的 DiffMSR 1 优于最先进的方法。
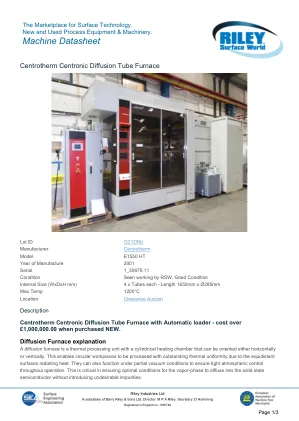
Centrotherm Centronic扩散管炉
扩散炉是一个热处理单元,具有圆柱加热室,可以水平或垂直定向。由于等距表面辐射热量,因此可以通过出色的热均匀性处理圆形工件。它们也可以在部分真空条件下发挥作用,以确保整个操作中的大气控制。这对于确保蒸气相扩散到固态半导体的情况下而无需引入不良杂质的最佳条件至关重要。

使用扩散模型在潜在空间中进行图像修复
使用扩散模型进行图像修复通常使用预条件模型(即针对绘画任务进行微调的图像条件模型)或后条件模型(即在推理时重新用于绘画任务的非条件模型)。预条件模型在推理时很快,但训练成本极高。后条件模型不需要任何训练,但在推理过程中很慢,需要多次前向和后向传递才能收敛到理想的解决方案。在这里,我们推导出一种不需要昂贵训练但推理速度很快的方法。为了解决昂贵的推理计算时间,我们在潜在空间而不是图像空间上执行前向-后向融合步骤。这是通过扩散过程中新提出的传播模块解决的。在多个领域进行的实验表明,我们的方法达到或改善了状态