
XiaoMi-AI文件搜索系统
World File Search SystemDiffusion

稳定扩散启用水下深度估计
单眼深度估计在近年来,由于深度学习的进步,近年来在陆地图像上取得了重大进展。,但主要是由于数据稀缺性而导致的水下场景不足。鉴于水中的光衰减和背面的固有挑战,获得清晰的水下图像或精确的深度非常困难且昂贵。为了减轻此问题,基于学习的方法通常依赖于综合数据或转向自欺欺人或无监督的举止。尽管如此,它们的性能通常受到域间隙和宽松的约束而阻碍。在本文中,我们提出了一种新的管道,用于使用准确陆地深度生成感性的水下图像。这种方法有助于对水下深度估计的模型进行超级培训,从而有效地降低了限制和水下环境之间的性能差异。与以前的合成数据集相反,这些数据集仅将样式转移应用于没有场景内容的情况下的Terres试验图像,我们的方法通过通过创新的STA-

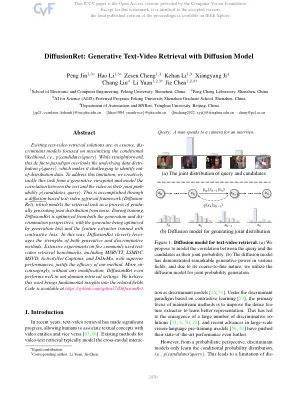
具有扩散模型的生成文本视频检索
现有的文本视频检索解决方案本质上是侧重于最大程度地提高条件可能性的模型,即P(候选人|查询)。虽然很简单,但这种事实上的范式却忽略了基本的数据分布p(查询),这使得识别出分布数据的挑战。为了解决这一限制,我们从生成观点创造性地解决了此任务,并将文本和视频之间的相关性建模为其关节概率P(候选人,查询)。这是通过基于扩散的文本视频检索框架(扩散-RET)来完成的,该框架将检索任务建模为从噪声中产生关节分布的过程。在训练过程中,从发电和犯罪的角度优化了Diffusionret,其发电机通过生成损失优化,并且具有对比度损失的训练的特征提取器。以这种方式,diffusionret巧妙地杠杆化了生成和歧视方法的优势。在五个常用的文本检索基准测试中进行了广泛的实验,包括MSRVTT,LSMDC,MSVD,ActivityNet字幕和DIDEMO,并具有出色的性能,证明了我们方法的效果。更加谨慎,没有任何修改,diffusionret甚至在外域检索设置中表现良好。我们认为这项工作带来了对相关领域的基本见解。代码可从https://github.com/jpthu17/diffusionret获得。
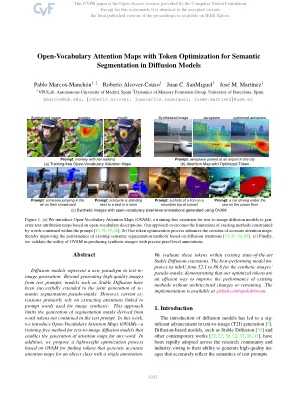
在扩散模型中使用令牌优化的开放式摄取注意图
扩散模型代表文本到图像生成中的新范式。除了从文本提示中生成高质量的图像之外,诸如稳定扩散之类的模型已成功扩展到了共同生成的分段伪遮罩。但是,当前的敏感主要依赖于提取与用于图像合成的及时单词相关的关注。这种方法限制了从文本提示中未包含的单词代币中得出的分割掩码的产生。在这项工作中,我们介绍了开放式摄影注意力图(OVAM) - 用于文本到图像扩散模型的无训练方法,可为任何单词生成注意力图。此外,我们提出了一个基于OVAM的轻巧优化过程,用于查找具有单个注释的对象类的准确注意图。

训练扩散模型通过增强学习
扩散模型在图像生成中表现出了前所未有的ca。然而,它们从原始训练集中纳入并扩大了数据偏差(例如性别,年龄),从而限制了产生的IMEG的多样性。在本文中,我们在基于图像集的重新函数的指导下,使用增强学习(RL)提出了一种面向多样性的细调方法(RL)。具体而言,所提出的奖励函数(表示为多样性奖励),利用一组生成的信息来评估当前生成分配W.R.T.的覆盖范围。参考分布,由一组无偏见的图像表示。建立在分布差异估计的概率方法的基础上,差异奖励可以有效地用一小部分图像来测量相对分布差距。我们进一步将扩散过程作为多步决策问题(MDP),并通过最大化多样性奖励来应用策略梯度方法来微调扩散模型。在放样后选择任务上验证了奖励,其中根据多样性奖励值选择了最多样化的图像的子集。我们还展示了我们的RL微调框架的有效性,可以通过不同类型的扩散模型(包括班级条件模型和文本条件模型,例如stablediffusion)增强图像生成的多样性。
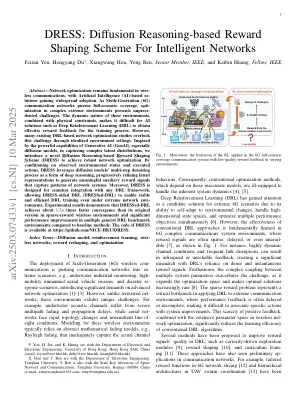
着装:智能网络基于扩散推理的奖励成型方案
摘要 - 通过人工智能(AI)基于人工智能(AI)基于人工智能的沟通优化仍然是基础的基础。作为第六代(6G)通信网络追求全赛纳里奥的覆盖范围,在复杂的极端环境中的选择提出了未经证实的挑战。这些环境的动态性质,结合物理约束,使AI解决方案(例如深度强化学习(DRL))很难为培训过程获得有效的奖励反馈。但是,许多现有的基于DRL的网络优化研究通过理想化的环境设置忽略了这一挑战。受到生成AI(Genai)(尤其是扩散模型)的强大功能的启发,在捕获复杂的潜在分布时,我们引入了一种新颖的基于扩散推理的奖励成型方案(着装),以实现强大的网络优化。通过对观察到的环境状态进行调节和执行动作,着装利用扩散模型的多步降级过程作为深层推理的一种形式,逐渐完善了潜在表示,以产生有意义的辅助奖励信号,以捕获网络系统模式。此外,连衣裙设计用于与任何DRL框架的无缝集成,允许连衣裙辅助的DRL(装扮得出)即使在极端的网络环境下也可以实现稳定而有效的DRL培训。实验结果表明,穿着的DRL大约达到1。礼服代码可从https://github.com/nice-hku/dress获得。与基线方法相比,在稀疏奖励无线环境中的收敛速度比其原始版本快于其原始版本,并且在多个一般DRL基准环境中的性能得到了显着改进。
脱氧得分蒸馏:从嘈杂的扩散预处理到一步高质量一代
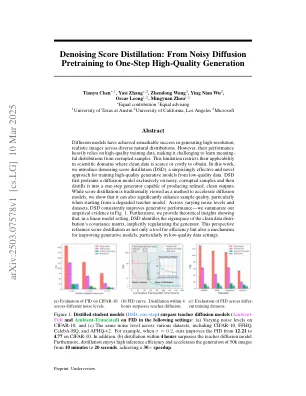
扩散模型在产生各种自然分布的高分辨率,逼真的图像方面取得了巨大的成功。但是,他们的性能在很大程度上依赖于高质量的培训数据,这使得从损坏的样本中学习有意义的分布变得具有挑战性。此限制限制了它们在稀缺或昂贵的科学领域中的适用性。在这项工作中,我们引入了DeNoising评分蒸馏(DSD),这是一种出奇的有效和新颖的方法,用于训练低质量数据的高质量生成模型。DSD首先预修了一个扩散模型,专门针对嘈杂,损坏的样品,然后将其提炼成能够生产精制,干净的输出的单步生成器。传统上将得分蒸馏视为加速扩散模型的一种方法,但我们表明它也可以显着提高样本质量,尤其是从退化的教师模型开始时。在不同的噪声水平和数据集中,DSD始终提高生成性能 - 我们在图中总结了我们的经验证据1。此外,我们提供了理论见解,表明在线性模型设置中,DSD识别了干净的数据分散协方差矩阵的特征空间,并隐含地正规化了生成器。此透视图将蒸馏片重新升级为效率的工具,而且是改善生成模型的机制,尤其是在低质量的数据设置中。

标题:在体内测试 - 重测的定量表征回波平面成像的显而易见的扩散系数可重复可重现
标题:在1.5T MR-LINAC平台上对头颈癌的显而易见的扩散系数的回波平面成像的重新延伸系数的重现:使用QIBA计量学的技术验证作者:Brigid A. McDonald 1,Dina El-Habashy 1,Renjie He 1,Sammir 1,Sam Mir Bir 1,2 Mohamed 1, 3 , Sara Ahmed 1 , Yao Ding 4 , Jihong Wang 4 , Stephen Y. Lai 5 , Alex Dresner 6 , John Christodouleas 7 , Clifton D. Fuller 1 Affiliations: 1 The University of Texas MD Anderson Cancer Center, Department of Radiation Oncology, Houston, TX, USA 2 UT MD Anderson Cancer Center UTHealth Houston Graduate School of Biomedical Sciences, Houston,美国德克萨斯州3贝勒医学院,放射肿瘤学系,美国德克萨斯州休斯敦4 4美国德克萨斯州安德森大学癌症中心,放射物理系,美国德克萨斯州休斯顿,美国5号,美国德克萨斯州癌症中心,德克萨斯州癌症中心,德克萨斯州休斯敦,德克萨斯州休斯敦,美国德克萨斯州休斯敦,美国6美国菲利普斯医疗保健MR on Ceport,美国埃尔克斯郡,美国7月,美国埃尔克斯郡。目的:为了检测放射治疗期间的明显扩散系数(ADC)值的变化,用于生物图像引导的自适应放射治疗,必须表征ADC的变异性。我们评估了1.5T MR-LINAC上头颈癌中ADC值的可重复性。方法:39例头颈癌患者(36例原发性肿瘤,55个淋巴结)在1.5T MR-LINAC上在辐射疗法开始之前的两个时间点上以回声 - 平面成像扩散加权MRI成像。为每个病变测量平均值和中位ADC值和体积。绝对性和可重复性系数(RC)。线性回归分析和F检验,以确定病变体积或扫描之间的时间是否影响可重复性。Results: For primary tumors & lymph nodes: mean ADC, median ADC, and volume were 1.27 ± 0.33 mm 2 /s & 1.17 ± 0.34 mm 2 /s, 1.25 ± 0.35 & 1.16 ± 0.37 mm 2 /s, and 8.8 ± 12.3 cm 3 & 6.5 ± 7.2 cm 3 , respectively.对于肿瘤和节点,平均ADC的RC值为0.355 mm 2 /s&0.355 mm 2 /s,%RC值为29.1%和31.1%;中值ADC非常相似。可重现性与体积或扫描间隔没有显着相关,但是观察到较小体积的可重复性较差的趋势。结论:考虑到先前的报告,最佳%∆ ADC在头颈癌中的响应预测阈值约为15-30%,MR-LINAC上的这种序列具有可接受的可重复性来检测较大的ADC变化,但仍可能错过一些临床上显着的变化。
深度学习的扩散MRI拖拉术
图1。(a)我们提出的拖拉术算法的概述:给定种子点或部分已知的流线,我们的方法提取了相应的局部和邻域DMRI信号,以形成输入数据序列(x 1,…,x t)。然后将此序列馈送到我们的网络中,以预测传播的方向。随后,流线根据给定的步长和传播方向生长。更新的流线(不完整)将是我们方法的新输入,

使用经过扩散MRI训练的卷积神经网络的脑年龄分析和痴呆分类:印度和北美队列的测试
摘要 - 基于卷积神经网络(CNN)的深度学习模型已用于对阿尔茨海默氏病进行分类或从T1加权大脑MRI扫描中推断痴呆症的严重程度。在这里,我们研究了添加扩散加权MRI(DMRI)作为这些模型的输入的值。在这一领域进行了许多研究,重点介绍了特定数据集,例如阿尔茨海默氏病神经影像学计划(ADNI),该计划评估了北美人(主要是欧洲血统)的人,因此我们研究了对ADNI培训的模型,该模型如何推广到来自印度(Nimhans Cohort)的新人口数据集。我们首先通过预测“大脑时代”来基准我们的模型 - 从其MRI扫描中预测一个人的年龄并继续进行广告分类的任务。我们还评估了在训练CNN模型之前使用3D CycleGAN方法来协调成像数据集的好处。我们的实验表明,在大多数情况下,在协调后的分类性能会提高,并且DMRI作为输入的性能更好。