
XiaoMi-AI文件搜索系统
World File Search SystemEfficient

tcl-net:具有频率域融合和多角度注意的轻巧有效的飞行网络
摘要。朦胧的图像带来了一个具有挑战性的问题,由于信息丢失和颜色失真而遭受。当前的基于深度学习的去悬式方法通过增加网络深度来增强性能,但会导致大量参数开销。同时,标准卷积层集中在低频细节上,通常会说出高频信息,这阻碍了模糊图像中提出的先前信息的有效利用。在本文中,我们提出了TCL-NET,这是一个轻巧的飞行网络,该网络强调了频域特征。我们的网络首先包含一个用于提取高频和低频内形式的所谓层,该层是针对原始模糊图像的快速变压器专门设计的。同时,我们设计了一个频率域信息融合模块,该模块将高频和低频信息与后续卷积层的卷积网络作品集成在一起。此外,为了更好地利用原始图像的空间信息,我们引入了一个多角度注意模块。使用上述设计,我们的网络以仅0.48MB的总参数大小实现了出色的性能,与其他最先进的轻量级网络相比,参数的数量级降低了。

加油否认:气候变化反动运动和瑞典极右媒体
©作者2024。Open Access本文是根据Creative Commons Attribution 4.0 International许可获得许可的,该许可允许以任何媒介或格式使用,共享,适应,分发和复制,只要您对原始作者和来源提供适当的信誉,请提供与创意共享许可证的链接,并指出是否进行了更改。本文中的图像或其他第三方材料包含在文章的创意共享许可中,除非在信用额度中另有说明。如果本文的创意共享许可中未包含材料,并且您的预期用途不受法定法规的允许或超过允许的用途,则您需要直接从版权所有者那里获得许可。要查看此许可证的副本,请访问http://创建ivecommons。org/licen ses/by/4。0/。

Wafer-Scale Gold Nanomesh通过纳米转移印刷朝着具有成本效益的多重传感平台
检测化学和生物物质,以涉及各种应用方案,例如可穿戴电子设备,智能点(POC)诊断,环境监测等。[1,2]要适当地满足这些新兴要求,理想的生化传感器应具有诸如高灵敏度,长期鲁棒性,快速响应,实时监测能力,出色的选择性,低单位成本,检测下限,较大的动态范围,低功耗等等等特性[3]但是,人类仍然需要进行陡峭的攀登之旅才能实现这些目标。值得注意的是,2019年冠状病毒病的全球大流行(Covid-19)表明,我们的技术储备在满足这种紧急,庞大和多功能的要求方面并没有充分准备,并引起了对生化感测技术的极大关注。迄今为止,包括化学主义的几种主要技术路线,[4,5] plasonic,[6,7]电化学,[8,9]声传感器,[10,11]等。已经开发出来,每个传感器中的每一个都在某些上述方面具有针对各种实际应用方案的特定优点。纳米制造技术的快速开发用于不同材料和各种结构,由于其小特征和主动结构特性,例如高地表到数量,独特的物理特性,独特的物理特性等,戏剧性地增强了这些传感设备的性能。[12–14]
学习在实际环境中有效,精确地导航
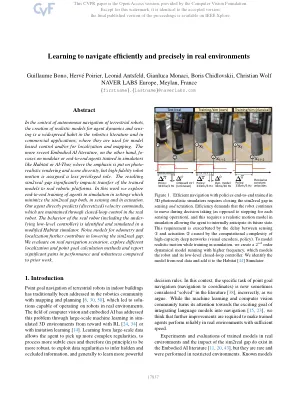
在陆地机器人自主导航的背景下,创建用于代理动力学和感官的现实模型是机器人文献和商业应用中的广泛习惯,在该习惯中,它们用于基于模型的控制和/或用于本地化和映射。另一方面,较新的AI文献是在模拟器或Ai-thor的模拟器或端到端代理上进行训练的,在这种模拟器中,重点放在照相现实渲染和场景多样性上,但是高效率机器人动作具有较少的特权角色。所得的SIM2REAL差距显着影响训练有素的模型转移到真正的机器人平台。在这项工作中,我们探讨了在设置中对代理的端到端培训,从而最大程度地减少了Sim2real Gap,在感应和驱动中。我们的代理直接预测(离散的)速度命令,这些命令是通过真实机器人中的闭环控制维护的。在修改的栖息地模拟器中鉴定并模拟了真实机器人的行为(包括底盘的低级控制器)。探视和定位的噪声模型进一步促进了降低SIM2REAL间隙。我们在实际导航方案上评估,探索不同的本地化和点目标计算方法,并报告与先前的工作相比的性能和鲁棒性的显着增长。

节能自适应3D传感-CVF开放访问
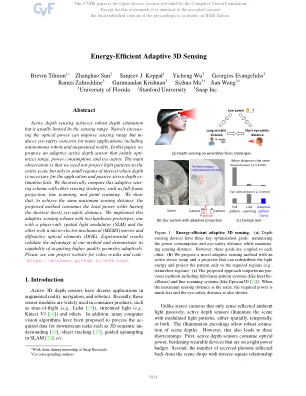
主动深度传感可实现强大的深度估计,但通常受感应范围的限制。天真地增加光学能力可以改善传感范围,但对许多应用(包括自主机器人和增强现实)的视力安全关注。在本文中,我们提出了一个自适应的主动深度传感器,该传感器可以共同介绍范围,功耗和眼部安全。主要观察结果是,我们不需要将光模式投影到整个场景,而只需要在关注的小区域中,在应用程序和被动立体声深度所需的深度失败的情况下。理论上将这种自适应感知方案与其他感应策略(例如全帧投影,线扫描和点扫描)进行了比较。我们表明,为了达到相同的最大感应距离,提出的方法在最短(最佳)眼部安全距离时会消耗最小的功率。我们用两个硬件原型实现了这种自适应感测方案,一个具有仅相位空间光调制器(SLM),另一个带有微电动机械(MEMS)镜像和衍射光学元素(DOE)。实验结果验证了我们方法的优势,并证明了其能力自适应地获得更高质量的几何形状。请参阅我们的项目网站以获取视频结果和代码:
通过群集掩模的有效视力语言预训练
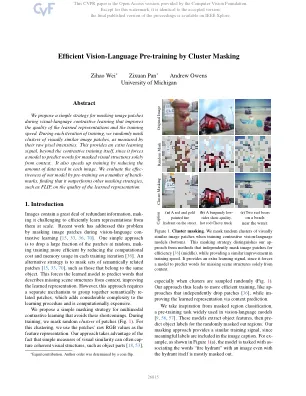
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],


通过信息填充信息填充信息
协作感知使每个代理人通过与其他代理人的传统消息交换来证明其感知能力。它固有地归结为感知和沟通成本之间的基本权衡。为了解决这个瓶颈问题,我们的核心思想是从两个关键方面优化协作序列:表示和选择。提出的基于密码的消息代表可以传输整数代码,而不是高维特征图。提出的信息填充消息选择优化了本地消息,以共同填充每个代理的信息需求,防止多个代理之间的信息溢出。通过对这两种设计进行介绍,我们提出了一种新颖的沟通效率协作感知系统,它大大提高了感知 - 交流权衡权衡,并且既包含了同性恋和异构协作环境。我们在现实世界数据集(DAIR-V2X)和新的仿真数据集OPV2VH+中评估了代码填充。结果表明,代码填充的表现超过了sota,其中2comm在dair-v2x/opv2vh+上具有1,333/1,206×较低的通信量。我们的代码可从https://github.com/phyllish/ codefilling获得。

一种简单而有效的可扩展多视图张量聚类
基于锚点的大规模多视图聚类因其在处理海量数据集方面的有效性而引起了广泛关注。然而,当前的方法主要通过探索锚点图或投影矩阵之间的全局相关性来寻找用于聚类的共识嵌入特征。在本文中,我们提出了一种简单而有效的可扩展多视图张量聚类(S 2 MVTC)方法,我们的重点是学习视图内和跨视图的嵌入特征的相关性。具体而言,我们首先通过将不同视图的嵌入特征堆叠到张量中并旋转它来构造嵌入特征张量。此外,我们构建了一种新颖的张量低频近似(TLFA)算子,它将图相似性结合到嵌入特征学习中,有效地实现不同视图内嵌入特征的平滑表示。此外,对嵌入特征应用共识约束以确保视图间语义一致性。在六个大规模多视图数据集上的实验结果表明,S 2 MVTC 在聚类性能和 CPU 执行时间方面明显优于最先进的算法,尤其是在处理海量数据时。S 2 MVTC 的代码已公开发布在 https://github.com/longzhen520/S2MVTC。