
XiaoMi-AI文件搜索系统
World File Search SystemGenerative

超越歧视:法医精神病学的生成AI应用和道德挑战
生成人工智能(Genai)的出现和日益普及有可能改变法医精神病学和刑事司法的AI应用,传统上依赖于歧视性的AI算法。生成的AI模型标志着从以前流行的范式中通过生成看似新的现实数据并分析和集成了来自不同数据格式的大量非结构化内容的能力的显着转变。这种潜力不仅仅是重塑常规做法,例如风险评估,诊断支持以及治疗和康复计划,还可以在以前未经置换的领域(例如培训和教育)中创造新的机会。本文研究了生成人工智能对法医精神病学和刑事司法中AI应用的变革性影响。首先,它引入了生成AI及其普遍模型。之后,它回顾了法医精神病学中歧视性AI的当前应用。随后,它对生成AI的潜力进行了彻底的探索,可以通过多模式生成模型,数据生成和数据增强来改变既定的实践并引入新颖的应用。最后,它提供了与部署生成AI模型相关的道德和法律问题的全面概述,重点是他们对个人的影响以及其更广泛的社会影响。总而言之,本文旨在为在法医背景下生成AI应用的动态挑战的持续论述做出贡献,突出了潜在的机会,风险和挑战。它提倡跨学科的合作,并强调对生成AI模型进行彻底,负责任的评估的必要性,然后在广泛采用的决策中常规地做出了实质性的改变后果。

检查用户界面对信任和与生成ai
本文研究了不同的用户界面(UI)设计如何影响用户对生成人工智能(AI)工具的信任。我们采用了OZ方法的向导来测试具有不同UI CHATGPT不同UI变化的三种工具的信任水平的实验。来自不同学科的九名志愿大学学生参加了会议。我们使用问卷来评估参与者与每个工具进行交互后以及与所有工具进行交互后对信任的看法。结果表明,参与者之间的信任水平受生成AI的UI设计的影响,尤其是Avatar设计和文本字体。尽管共享相同的文本源,但大多数参与者还是将CHATGPT评为最值得信赖的工具。结果还强调了对话界面在使用生成AI系统建立信任中的重要性,参与者表达了偏爱促进自然和引人入胜的互动的接口。该研究强调了UI对信任的重大影响,并旨在鼓励对生成AIS的更谨慎的信任。

生成的多模式模型是良好的类增量学习者
在班级学习(CIL)方案中,由于阶级的偏见对当前任务的偏见引起的灾难性遗忘者长期以来一直引起了重大挑战。它主要由判别模型的特征引起。随着生成性多模式模型的日益普及,我们将探索用CIL生成的歧视模型代替歧视模型。,从歧视到生成模式过渡需要解决两个关键挑战。主要挑战在于将生成的文本信息转移到不同类别的分类中。在方面,它需要在生成框架内制定CIL的任务。为此,我们提出了一种新颖的生成性多模式模型(GMM)框架,用于类增量学习。我们的方法直接使用改编的生成模型为图像生成Labels。获得详细的文本后,我们使用文本编码器来阐述文本特征,并采用匹配的功能来确定最相似的标签与分类的标签。在传统的CIL设置中,我们在长期序列的任务方案中取得了更好的影响。under少数CIL设置,与所有当前最新方法相比,我们的精度至少提高了14%,而遗忘的遗忘明显较小。我们的代码可在https://github.com/doubleclass/gmm上找到。
开放式对象检测的生成区域训练
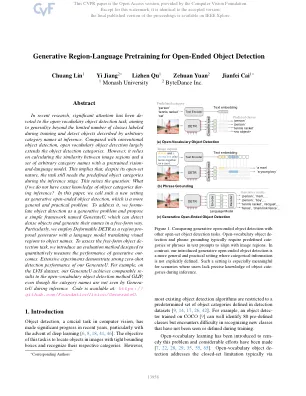
在最近的研究中,已对开放式摄制对象检测任务进行了大量关注,旨在概括训练期间标记的类别的有限级别,并检测推理时任意类别名称所描述的对象。与常规对象检测相比,打开的词汇对象检测在很大程度上扩展了对象检测类别。但是,它依赖于计算图像区域与一组具有验证视觉和语言模型的任意类别名称之间的相似性。这意味着,尽管具有开放式的性质,但该任务仍然需要在推理阶段的预定义对象类别。这提出了一个问题:如果我们在推理中对对象类别没有确切的了解,该怎么办?在本文中,我们称之为新的设置为生成性开放式对象检测,这是一个更普遍和实际的问题。为了解决它,我们将对象检测形式为生成问题,并提出了一个名为generateu的简单框架,该框架可以检测密集的对象并以自由形式的方式生成其名称。尤其是,我们采用可变形的DETR作为区域促成生成器,其语言模型将视觉区域转换为对象名称。为了评估自由形式的对象划分任务,我们介绍了一种评估方法,旨在定量测量生成量的性能。广泛的实验表明我们的生成量强烈的零射击性能。代码可在以下网址获得:https://github.com/foundationvision/generateu。例如,在LVIS数据集上,我们的GenerateU在推理过程中属于类别名称,即类别名称无法看到类别名称,即使类别名称看不见类别名称,我们的GenerateU也可以与开放式唱机对象检测方法GLIP相当。

sangea:可扩展和归因网络生成
深层生成模型(DGM)是用于学习数据表示的多功能工具,同时合并了域知识,例如条件概率分布的规范。最近提出的DGMS解决了比较来自不同来源的数据集的重要任务。这样的示例是对比分析的设置,该分析的重点是描述与背景数据集相比富含目标数据集中的模式。这些模型的实际部署通常假定DGM自然推断出可解释的和模块化的潜在表示,这在实践中是一个问题。因此,现有方法通常依赖于临时正规化方案,尽管没有任何理论基础。在这里,我们通过扩展非线性独立组件分析领域的最新进展,提出了对比较DGM的可识别性理论。我们表明,尽管这些模型在一般的混合功能上缺乏可识别性,但当混合函数在零件上时,它们令人惊讶地变得可识别(例如,由Relu神经网络参数化)。我们还研究了模型错误指定的影响,并从经验上表明,当未提前知道潜在变量的数量时,以前提出的用于拟合比较DGM的正则化技术有助于识别性。最后,我们引入了一种新的方法,用于拟合比较DGM,该方法通过多目标优化改善了多个数据源的处理,并有助于使用约束优化以可解释的方式调整正规化的超参数。我们使用模拟数据以及通过单细胞RNA测序构建的细胞中的遗传扰动数据集以及最新的数据集验证了我们的理论和新方法。关键字:非线性ICA;深层生成模型;变分推断;解开;

通过零件式层次结构消息传递
生成的3D部分组装涉及了解零件关系,并预测其6-DOF姿势,用于组装逼真的3D形状。先前的工作通常集中在各个部分的几何形状上,忽略了整个物体的零件。利用两个关键的观察:1)超级部分姿势提供了有关零件姿势的强烈提示,而2)由于较少的超级部分,预测超级零件的姿势更容易,我们提出了一个零件 - 整个层次结构消息传递网络,以实现有效的3D零件组件。我们首先通过在没有任何语义标签的情况下对几何相似部分进行分组,从而引入超级零件。然后,我们采用零件整体的层次编码器,其中超级零件编码器预测基于输入部分的潜在超级零件姿势。随后,我们使用潜在姿势转换点云,将其馈送到零件编码器中,以汇总超级零件信息和有关零件关系的推理以预测所有部分姿势。在培训中,仅需要地面零件姿势。在推断期间,超级零件的预测潜在可增强可解释性。Partnet数据集上的实验结果表明,我们的方法可以部分地达到最新的功能和连接精度,并实现可解释的层次结构组件。代码可在https://github.com/pkudba/3dhpa上找到。

在教育中利用生成AI的指南2024
最新的生成人工智能(生成AI)的快速发展对我们所有人都产生了深远的影响,不仅影响了我们的日常生活,还影响了大学内的教育和研究的景观。Tsukuba大学建立为新的概念大学,预计将对学术界内的这种变革性变革开放,采取开放态度,并以创造性和开放的思想态度来塑造可持续的未来社会。在这种情况下,在2023年5月11日,我们发表了“在Tsukuba University使用生成AI的基本政策”,并继续进一步探索这个问题。符合我们通过高级学术追求培养人才的使命,我们现在采取以下方法来先发行生成AI,如下:

训练小波域损失的训练生成图像超分辨率模型可以更好地控制伪影
抽象的超分辨率(SR)是一个不当的反问题,其中具有给定低分辨率图像的可行解决方案集的大小非常大。已经提出了许多算法,以在可行的解决方案中找到一种“好”解决方案,这些解决方案在忠诚度和感知质量之间取得了平衡。不幸的是,所有已知方法都会生成伪影和幻觉,同时试图重建高频(HF)图像细节。一个有趣的问题是:模型可以学会将真实图像细节与文物区分开吗?尽管有些重点侧重于细节和影响的分化,但这是一个非常具有挑战性的问题,并且尚待找到满意的解决方案。本文表明,与RGB域或傅立叶空间损耗相比,使用小波域损失功能训练基于GAN的SR模型可以更好地学习真正的HF细节与伪像的表征。尽管以前在文献中已经使用了小波域损失,但在SR任务的背景下没有使用它们。更具体地说,我们仅在HF小波子带上而不是在RGB图像上训练鉴别器,并且发电机受到小波子带的忠诚度损失的训练,以使其对结构的规模和方向敏感。广泛的实验结果表明,我们的模型根据多种措施和视觉评估实现了更好的感知延续权权衡。
通过学习的先验
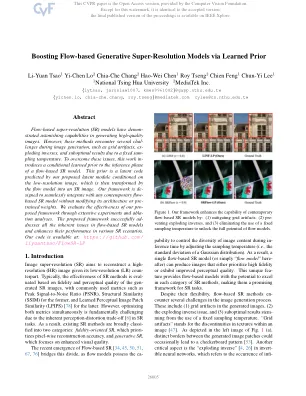
基于流量的超分辨率(SR)模型在生成高质量图像方面具有令人惊讶的功能。然而,这些方法在图像产生过程中遇到了几个challenges,例如网格伪像,进行倒置和由于固定的Sam固定温度而导致的次优结果。为了克服这些问题,这项工作涉及基于流量SR模型的推断阶段之前学到的条件。此先验是我们所提出的潜在模块预测的潜在代码,该模块在低分辨率图像上进行了条件,然后将流量模型转换为SR图像。我们的框架被签署为与任何基于当代流量的SR模型无缝集成,而无需修改其体系结构或经过预先训练的权重。我们通过广泛的实验和ABLATION分析来评估我们提出的框架的有效性。所提出的框架成功地为所有固有的问题结合了基于流的SR模型,并在各种SR场景中提高了其性能。我们的代码可在以下网址提供:https://github.com/ liyuantsao/flowsr-lp

讲师指南:利用生成式人工智能在比勒陀利亚大学进行教学和学习增强。docx
OpenAI 于 2022 年 11 月启动的 ChatGPT 引发了关于人工智能对高等教育影响的重要讨论。当学生使用它来撰写论文时,它打破了现状。与谷歌的 Gemini 和微软的 Copilot 一样,OpenAI 的 ChatGPT 是能够模仿人类对话的强大大型语言模型 (LLM) 的典型示例。大型语言模型在识别语言模式和预测上下文单词方面表现出色,并且擅长以最少的用户输入生成连贯且相关的文本响应。通过利用其广泛的训练语言模式数据库,大型语言模型可以提供准确反映用户输入上下文的生成文本响应。凭借对语言的掌握,他们可以创作创意诗歌,撰写全面连贯的文章,深入分析主题,并有说服力地提出论点。