
XiaoMi-AI文件搜索系统
World File Search SystemGenerative
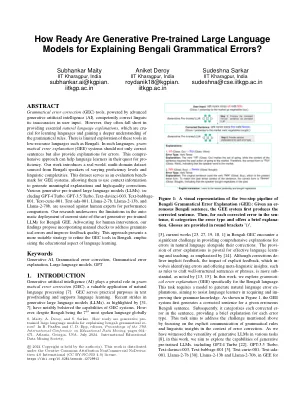
如何准备好生成的预训练的大语言模型来解释孟加拉语语法错误?
抽象的语法校正校正(GEC)工具,由先进的生成人工智能(AI)提供动力,在用户输入中有效地纠正了语言的不准确性。但是,它们通常在提供基本的自然语言解释方面缺乏,这些解释是学习语言并获得对语法规则的更深入的理解。在低资源语言(例如孟加拉语)中对这些工具的探索有限。在这样的语言中,革命错误说明(GEE)系统不仅应正确句子,而且还应提供错误的解释。这种综合方法可以帮助语言学习者寻求提高能力。我们的工作介绍了一个现实世界中的多域数据集,该数据集来自孟加拉语扬声器,具有不同的义务水平和语言复杂性。此数据集可作为GEE系统的评估基准标记,允许他们使用上下文信息来生成有意义的解释和高质量的更正。Various generative pre-trained large language models (LLMs), in- cluding GPT-4 Turbo, GPT-3.5 Turbo, Text-davinci-003, Text-babbage- 001, Text-curie-001, Text-ada-001, Llama-2-7b, Llama-2-13b, and Llama-2-70b, are assessed against human experts for performance comparison.我们的研究强调了自动部署孟加拉人GEE的当前最新生成预培训的LLM的局限性。主张进行人干预,我们的发现提议合并手动检查以解决语法错误并提高反馈质量。这种方法提出了一种更合适的策略,以重新确定孟加拉语的GEC工具,并阐明了语言学习的教育方面。

Hanooman:一种生成的AI和大型语言模型聊天机器人,受到Hanuman勋爵的启发
摘要本文介绍了Hanooman,这是一种生成的AI和大型语言模型聊天机器人,其灵感来自Hindu Geity Lord Hanuman。Hanooman旨在体现力量,敏捷性和奉献精神的素质,利用尖端的语言处理能力,为用户提供信息丰富且引人入胜的对话。我们探索了哈诺曼的概念框架,架构和培训程序,展示了其在各个领域的潜在应用。我们的评估结果表明,在响应准确性和上下文理解方面,Hanooman优于现有的聊天机器人,使其成为自然语言处理和人类计算机互动的有前途的工具。大语言模型(LLM)和生成AI是人工智能的重大进步,彻底改变了我们与技术的互动,生成内容和理解人类语言的方式。llms,在大量数据集中受过培训,在语言翻译,文本摘要,问题答案和创意写作等任务中表现出色。生成的AI(AI的一个子集)会产生自主输出,通常表现出惊人的创造力和连贯性。印度亿万富翁穆克什·安巴尼(Mukesh Ambani)与IIT孟买和其他八个印度技术学院合作,加入了AI竞赛,以推出“ Hanooman”,这是一集,该集合以22种印度语言培训了大型语言模型。关键字:哈诺曼,大语言模型,人工智能,生成AI1。简介

北卡罗来纳州生成的AI实施建议和注意事项
已经创建了这些生成的AI实施建议和考虑因素,以共享信息和资源,以帮助直接负责执行生成AI工具并指导北卡罗来纳州公立学校的AI素养。请注意,随着生成AI正在新兴的技术,并且正在迅速改变,法律和规则的使用规则也是一份生动文档,它将根据需要进行更新,以反映在这种非常流畅的环境中发生的变化。最后一个更新将显示在每个页面的底部以供您参考。这些准则是围绕北卡罗来纳州数字学习计划的五个重点领域组织的,该计划指导北卡罗来纳州公立学校的数字教学。数字学习计划鼓励安全利用创新技术为学生做好准备,并为未来的学校做好准备,并努力改善学生的成果并支持适当使用技术来推进学习。th是围绕NC数字学习计划的五个焦点领域组织的,如该图形所示。
构建表达和可处理的概率生成模型:评论
1引言生成建模在机器学习和人工智能领域起着重要作用,因为它提供了一种能够理解,解释以及在我们数据丰富世界中存在的复杂模式的功能工具包。通过将概率理论作为捕获给定数据集中固有不确定性的原则方法,这些模型旨在近似负责生成数据的基础分布或随机过程。因此,概率生成模型具有解决各种问题的潜力,包括生成新的数据示例,进行观察给出的推理,估计事件的可能性以及有关不确定信息的推理。但是,从数据中学习分布是一个挑战问题,通常需要在建模灵活性和概率推断的障碍之间进行权衡。早期生成模型的优先级优先考虑可牵引推理,通常是通过图形模型的形式将概率结构施加在random变量上[Koller and Friedman,2009]。因此,他们缺乏对复杂分布进行建模的挠性。自那以后,提出的可进行的概率模型(TPM)的领域随后发生了,并提出了端流的参数化和学习范式,从而在概率电路的统一概念下产生了广泛而流行的模型类别。从障碍性的角度设计,这些模型可以有效地推断和精确的概率推理,使其适合于要求快速准确计算的任务。但是,

infinigen:具有动态KV缓存管理的大语言模型的有效生成推断
基于变压器的大语言模型(LLMS)在各种自然语言处理任务中都具有令人印象深刻的表现。为LLM推断为生成长含量而构成挑战,这是由于瞬态状态的巨大内存足迹(称为键值(KV)缓存),该状态以序列长度和批处理大小缩放。在本文中,我们提出了Infinigen,这是一种针对Longext Genertion量身定制的新型KV缓存管理框架,该框架协同与现代卸载基于卸载的推理系统合作。Infinigen利用了关键见解,即可以通过对当前层的最小彩排以及查询权重的一部分和后续层的关键缓存进行最小化的彩排来推测,对于计算变压器中后续注意力层至关重要的重要洞察力。这使我们只能预取基本的KV缓存条目(不提供所有内容),从而在基于卸载的LLM服务系统中减轻主机内存中的提取开销。我们对几种代表性LLMS的评估表明,与先前的KV高速缓存管理方法相比,Infinigen将基于现代卸载系统的总体性能提高了3.00倍,同时提供了更好的模型准确性。

detdiffusion:增强数据生成和感知的生成和感知模型
当前的感知模型在很大程度上取决于资源密集型数据集,从而促使需要创新。通过从各种注释中构造图像输入来利用综合数据的最新进展,证明对下游任务有益。虽然先前的方法已单独解决了生成和感知模型,但首次降低了两者的谐调,从而解决了为感知模型生成有效数据的挑战。通过感知模型增强图像发生,我们引入了感知感知损失(P.A.损失)通过细分,提高质量和可控性。为了提高特定感知模型的性能,我们的方法通过提取和利用感知意识来定制数据(P.A.attr)在一代中。对象检测任务的实验结果突出显示了detDiffusion的统治性能,建立了布局引导的新最新作品。此外,降低的图像合成可以有效地增强训练数据,从而显着增强下游检测性能。

网络安全中的生成AI
AI技术的快速进步,尤其是与机器学习(ML)和深度学习(DL)相关的技术的快速进步,已大大扩大了自动化系统攻击和防御能力的范围。ml是指可以在不明确编程的情况下从数据中学习的算法,而DL通过利用复杂的人工神经网络来基于ML构建ML,以从数据中的复杂模式中学习。但是,这一进度呈现了一把双刃剑。一方面,AI增强了网络安全度量,从而能够开发出强大的预测安全系统。另一方面,它具有同等授权的网络对手,他们利用这些技术来开发可超越传统安全措施,适应新环境并以惊人效率逃避检测的恶意软件。


重新思考生成人工智能评估
无论您从事的教育程度如何,这篇文章都是试图说服您试图抓住或检测GAI是徒劳的。不仅如此,检测工具和其他窃的调查器可能是不道德的,对GAI使用的惩罚性方法将增加教育工作者的工作量。今年,我在澳大利亚州和各州的许多不同学校工作。我已经提出了很多有关GAI和评估的问题,因此我将以FAQ介绍这篇文章。如果在文章结尾处,您仍然认为检测是一个可行的选择,我鼓励您通过左侧的“联系表”按钮与您取得联系。