
XiaoMi-AI文件搜索系统
World File Search SystemImage
用于医学图像超分辨率的多模态多头卷积注意
超分辨率医学图像可帮助医生提供更准确的诊断。在许多情况下,计算机断层扫描 (CT) 或磁共振成像 (MRI) 技术在一次检查期间会捕获多个扫描 (模式),这些扫描 (模式) 可以联合使用 (以多模态方式) 来进一步提高超分辨率结果的质量。为此,我们提出了一种新颖的多模态多头卷积注意模块来超分辨率 CT 和 MRI 扫描。我们的注意模块使用卷积运算对多个连接的输入张量执行联合空间通道注意,其中核 (感受野) 大小控制空间注意的减少率,卷积滤波器的数量控制通道注意的减少率。我们引入了多个注意头,每个头具有不同的感受野大小,对应于空间注意的特定减少率。我们将多模态多头卷积注意力 (MMHCA) 集成到两个深度神经架构中以实现超分辨率,并对三个数据集进行了实验。我们的实证结果表明,我们的注意力模块优于超分辨率中使用的最先进的注意力机制。此外,我们进行了一项消融研究,以评估注意力模块中涉及的组件的影响,例如输入的数量或头部的数量。我们的代码可在 https://github.com/lilygeorgescu/MHCA 免费获取。
调整视觉语言模型以实现医学图像中的通用异常检测
大规模视觉语言预训练模型的最新进展已在自然图像领域中的零样本/少样本异常检测方面取得了重大进展。然而,自然图像和医学图像之间巨大的领域差异限制了这些方法在医学异常检测中的有效性。本文介绍了一种新颖的轻量级多级自适应和比较框架,以重新利用 CLIP 模型进行医学异常检测。我们的方法将多个残差适配器集成到预训练的视觉编码器中,从而实现不同级别视觉特征的逐步增强。这种多级自适应由多级、逐像素的视觉语言特征对齐损失函数引导,将模型的重点从自然图像中的对象语义重新校准到医学图像中的异常识别。调整后的特征在各种医学数据类型中表现出更好的泛化能力,即使在模型在训练期间遇到看不见的医学模态和解剖区域的零样本场景中也是如此。我们在医学异常检测基准上进行的实验表明,我们的方法明显优于当前最先进的模型,在零样本和少样本设置下,异常分类的平均 AUC 改进分别为 6.24% 和 7.33%,异常分割的平均 AUC 改进分别为 2.03% 和 2.37%。源代码可从以下网址获取:https://github.com/MediaBrain-SJTU/MVFA-AD

m3t:使用多平面和多板变压器
在这项研究中,我们提出了使用多平面和多层跨前(M3T)网络的三维医学图像分类器,以在3D MRI图像中对阿尔茨海默氏病(AD)进行分类。提出的网络协同委托3D CNN,2D CNN和变压器用于准确的AD分类。3D CNN用于执行本机3D表示学习,而2D CNN用于利用大型2D数据库和2D代表学习的预训练权重。使用具有感应性偏置的CNN网络有效地提取局部大脑中与AD相关的异常的信息信息。跨前网络还用于获得CNN后多平面(轴向,冠状和矢状)和多切片图像之间的注意力关系。也可以使用不感应偏置的变压器学习分布在大脑中较大区域的差异。在此期间,我们使用了来自阿尔茨海默氏病神经影像学计划(ADNI)的训练数据集,该计划总共包含4,786 3D T1加权MRI图像。对于有效数据,我们使用了来自三个不同机构的数据集:澳大利亚成像,生物标志物和生活方式旗舰研究(AIBL)(AIBL),开放访问Imaging研究(OASIS)的开放访问系列(OASIS)以及来自培训数据集中的一些ADNI数据。我们提出的M3T基于曲线(AUC)下的区域(AUC)和AD分类的分类精度,与常规的3D分类网络相结合。这项研究表示,所构成的网络M3T在多机构验证数据库中实现了最高的性能,并证明了该方法有效地将CNN和Transformer用于3D医学图像的可行性。

从单目遥感图像进行 3D 建筑物重建
与从 LiDAR 数据和多视图影像重建相比,倾斜影像重建是大规模城市建模的重要研究问题和经济解决方案。然而,建筑物足迹和立面的部分不可见性、严重的阴影效应以及大范围区域内建筑物高度的极端变化等若干挑战将现有的基于单目影像的建筑物重建研究限制在某些应用场景中,即从近地面影像建模简单的低层建筑物。在本研究中,我们提出了一种新颖的单目遥感影像 3D 建筑物重建方法,解决了上述困难,从而为更复杂的场景提供了一种有吸引力的解决方案。我们设计了一个多任务建筑物重建网络 MTBR-Net,通过四个语义相关任务和三个偏移相关任务来学习倾斜影像的几何属性、3D 建筑物模型的关键组件及其关系。网络输出通过基于先验知识的 3D 模型优化方法进一步集成,以生成最终的 3D 建筑模型。在公共 3D 重建数据集和新发布的数据集上的结果表明,与目前最先进的方法相比,我们的方法将高度估计性能提高了 40% 以上,将分割 F1 分数提高了 2% - 4%。
草稿 - 对现实世界图像字幕和场景标识的全面分析
图像字幕是一项计算机视觉任务,涉及为图像生成自然语言描述。此方法在各个领域都有许多应用,包括图像检索系统,医学和各种行业。但是,尽管图像字幕进行了重要的研究,但大多数研究都集中在高质量的图像或受控环境上,而没有探索现实世界图像字幕的挑战。现实世界的图像字幕涉及复杂而动态的环境,具有许多关注点,图像通常在质量上非常差,甚至对于人类而言,这也是一项艰巨的任务。本文评估了在不同编码机制,语言解码器和培训程序之上构建的各种模型的性能,使用新创建的现实世界数据集由使用MIT室内场景数据集构建的65多个不同场景类的800多个图像组成。该数据集使用IC3方法字幕,该方法通过汇总来自图像的唯一视图点的标准图像字幕模型所涵盖的详细信息来生成更具描述性字幕。
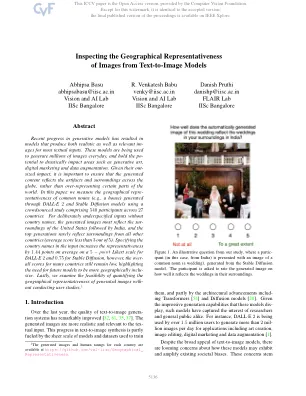
从文本到图像模型中检查图像的地理代表性
生成模型的最新进展导致了模型,这些模型既可以为大多数文本输入产生现实和相关的信息。这些模型每天都用于生成数百万张图像,并具有巨大影响诸如生成艺术,数字营销和数据增强等领域。鉴于它们的影响力,重要的是要确保生成的内容反映全球的伪影和周围环境,而不是过分代表世界的某些地区。在本文中,我们使用众包研究的研究衡量了通过dall·e 2产生的普通名词(例如房屋)的地理代表,以及稳定的扩散模型,其中包括27个国家 /地区的540名参与者。为了有意地指定没有国家名称的意见,生成的图像最反映了美国之后是印度的周围,而顶级世代很少反映出所有其他国家的周围环境(平均得分少于5分中的3个)。在输入中指定国家名称的代表性增加了1。平均在5-点李克特(Dall)的李子量表上为44点。75对于稳定的扩散,许多国家的超高分数仍然很低,这突出了将来模型在地理上更具包含的需求。最后,我们研究了量化使用用户研究的产生图像的地理代表性的可行性。1

热红外单幅图像去雾及盲图像质量评价
图像去雾是一种减少图像中雾霾、灰尘或雾气影响的方法,以便清晰地查看观察到的场景。文献中存在大量传统和基于机器学习的方法。然而,这些方法大多考虑可见光光谱中的彩色图像。显然,由于热红外光谱的波长较长,受雾霾的影响要小得多。但远距离观测期间的大气扰动也会导致热红外 (TIR) 光谱中的图像质量下降。在本文中,我们提出了一种为 TIR 图像生成合成雾的方法。然后,我们分析了现有的盲图像质量评估措施雾感知密度评估器 (FADE) 对 TIR 光谱的适用性。我们进一步全面概述了当前图像去雾的最新技术,并通过经验表明,许多最初为可见光图像设计的方法在应用于 TIR 光谱时表现得出奇的好。这在最近发布的 M3FD 数据集上进行的实验中得到了证实。

脑监督图像编辑
尽管用于语义图像编辑的深度神经模型最近取得了进展,但目前的方法仍然依赖于明确的人工输入。先前的工作假设有手动整理的数据集可用于监督学习,而对于无监督方法,需要人工检查发现的组件以识别那些修改有价值语义特征的组件。在这里,我们提出了一种新颖的替代方法:利用大脑反应作为学习语义特征表示的监督信号。在一项神经生理学实验中,向参与者 (N=30) 展示人工生成的面孔并指示他们寻找特定的语义特征,例如“老”或“微笑”,同时通过脑电图 (EEG) 记录他们的大脑反应。使用从这些反应推断出的监督信号,学习生成对抗网络 (GAN) 潜在空间内的语义特征,然后将其用于编辑新图像的语义特征。我们表明,隐性大脑监督实现的语义图像编辑性能与显性手动标记相当。这项工作证明了利用通过脑机接口记录的隐性人类反应进行语义图像编辑和解释的可行性。
像医学居民一样培训:对通用医学图像分割的上下文学习
临床成像工作流的主要重点是疾病诊断和管理,导致医学成像数据集与特定的临床目标密切相关。这种情况导致了开发特定于任务的分割模型的主要实践,而没有从广泛的成像群中获得见解。受到医学放射学居民培训计划的启发,我们提出了向普遍医学图像分割的转变,旨在通过利用临床目标,身体区域和成像方式的多样性和共同点来建立医学图像理解基础模型的范式。div of这个目标,我们开发了爱马仕,一种新颖的上下文 - 学习方法,以应对医学图像segmentation中数据杂基的挑战和注释差异。在五种模式(CT,PET,T1,T2和Cine MRI)和多个身体区域的大量各种数据集(2,438个3D图像)中,我们证明了通用范式比传统范式在单个模型中解决多个任务的传统范式的优点。通过跨任务的协同作用,爱马仕在所有测试数据集中都能达到最先进的性能,并显示出卓越的模型可伸缩性。其他两个数据集中的结果揭示了爱马仕在转移学习,分裂学习和对下游任务的概括方面的出色表现。爱马仕(Hermes)博学的先生展示了一个具有吸引力的特征,以反映任务和方式之间的复杂关系,这与既定的放射学解剖学和成像原则相吻合。代码可用1。