
XiaoMi-AI文件搜索系统
World File Search SystemImage
增强文本对图像合成的DF-GAN
摘要。文本对图像合成是机器学习中最具挑战性和最受欢迎的任务之一,许多模型旨在提高该领域的性能。深融合生成的对抗网络(DF-GAN)是图像生成的直接但有效的模型,但它具有三个关键局限性。首先,它仅支持句子级文本描述,从而限制了其从文字级输入中提取细颗粒特征的能力。第二,可以优化残差层和块的结构以及关键参数,以提高性能。第三,现有的评估指标,例如FréchetInception距离(FID),倾向于不适当地强调无关紧要的功能,例如背景,当重点放在生成特定对象上时,这是有问题的。为了解决这些问题,我们引入了一个新的文本编码器,该编码器增强了具有处理单词级描述能力的模型,从而导致更精确和文本一致的图像生成。此外,我们优化了关键参数,并重新设计了卷积和残留网络结构,从而产生了更高质量的图像并减少了运行时间。最后,我们提出了一种量身定制的新评估理论,以评估生成图像中特定对象的质量。这些改进使增强的DF-GAN在有效地产生高质量的文本分配图像方面更有效。
Synergynet:弥合离散和连续表示之间的差距,以进行精确的医学图像分割
近年来,已经提出了连续的潜在空间(CLS)和DISCRETE潜在空间(DLS)深度学习模型,以改善医学图像分析。但是,这些模型遇到了不同的挑战。cls模型捕获了复杂的细节,但由于其强调低级特征,因此在结构表示和易男性方面通常缺乏解释性。尤其是,DLS模型提供了可解释性,鲁棒性以及由于其结构性潜在空间而捕获粗粒度信息的能力。但是,DLS模型在捕获细粒细节方面的功效有限。为了确定DLS和CLS模型的局限性,我们采用了Synergynet,这是一种新型的瓶颈体系结构,旨在增强现有的编码器 - 核编码器分割框架。Synergynet无缝地将离散和连续的表示形式整合到利用互补信息中,并成功保留了细学的表示的细节。我们对多器官分割和CAR-DIAC数据集进行的实验实验表明,SynergyNet的表现优于包括Transunet:Transunet:DICE评分提高2.16%的其他最新方法,而Hausdorff分别分别提高了11.13%。在评估皮肤病变和脑肿瘤分割数据集时,我们观察到皮肤病变分割的交互分数的1.71%的重新提高,脑肿瘤分割的增长率为8.58%。我们的创新方法为增强医学图像分析关键领域中深度学习模型的整体性能和能力铺平了道路。

可控文本到图像合成,适用于多模态 MR 图像
近年来,生成模型取得了重大进展,尤其是在文本到图像合成领域。尽管取得了这些进展,但医学领域尚未充分利用大规模基础模型的功能来生成合成数据。本文介绍了一种文本条件磁共振 (MR) 成像生成框架,解决了与多模态考虑相关的复杂性。该框架包括一个预先训练的大型语言模型、一个基于扩散的提示条件图像生成架构和一个用于输入结构二进制掩码的附加去噪网络。实验结果表明,所提出的框架能够生成与医学语言文本提示一致的逼真、高分辨率和高保真的多模态 MR 图像。此外,该研究根据文本条件语句解释了生成结果的交叉注意力图。这项研究的贡献为未来文本条件医学图像生成的研究奠定了坚实的基础,并对加速医学成像研究的进步具有重要意义。
3D感知图像合成上自定义属性的定量操纵
尽管基于3D的GAN技术已成功地应用于具有各种属性的照片真实的3D图像,同时保持视图一致性,但很少有关于如何罚款3D impersimens的研究,而不会限制其属性特定对象的特定对象类别。为了填补此类研究空白,我们提出了一个基于3D的GAN代表的新型图像操纵模型,以对特定的自定义贡献进行细粒度控制。通过扩展最新的基于3D的GAN模型(例如,EG3D),我们的用户友好定量操作模型可以实现对3D操作多属性数量的精细而归一化的控制,同时实现了视图一致性。我们通过各种实验验证了我们提出的技术的有效性。
调整视觉语言模型以实现医学图像中的通用异常检测
大规模视觉语言预训练模型的最新进展已在自然图像领域中的零样本/少样本异常检测方面取得了重大进展。然而,自然图像和医学图像之间巨大的领域差异限制了这些方法在医学异常检测中的有效性。本文介绍了一种新颖的轻量级多级自适应和比较框架,以重新利用 CLIP 模型进行医学异常检测。我们的方法将多个残差适配器集成到预训练的视觉编码器中,从而实现不同级别视觉特征的逐步增强。这种多级自适应由多级、逐像素的视觉语言特征对齐损失函数引导,将模型的重点从自然图像中的对象语义重新校准到医学图像中的异常识别。调整后的特征在各种医学数据类型中表现出更好的泛化能力,即使在模型在训练期间遇到看不见的医学模态和解剖区域的零样本场景中也是如此。我们在医学异常检测基准上进行的实验表明,我们的方法明显优于当前最先进的模型,在零样本和少样本设置下,异常分类的平均 AUC 改进分别为 6.24% 和 7.33%,异常分割的平均 AUC 改进分别为 2.03% 和 2.37%。源代码可从以下网址获取:https://github.com/MediaBrain-SJTU/MVFA-AD


使用扩散模型在潜在空间中进行图像修复
使用扩散模型进行图像修复通常使用预条件模型(即针对绘画任务进行微调的图像条件模型)或后条件模型(即在推理时重新用于绘画任务的非条件模型)。预条件模型在推理时很快,但训练成本极高。后条件模型不需要任何训练,但在推理过程中很慢,需要多次前向和后向传递才能收敛到理想的解决方案。在这里,我们推导出一种不需要昂贵训练但推理速度很快的方法。为了解决昂贵的推理计算时间,我们在潜在空间而不是图像空间上执行前向-后向融合步骤。这是通过扩散过程中新提出的传播模块解决的。在多个领域进行的实验表明,我们的方法达到或改善了状态
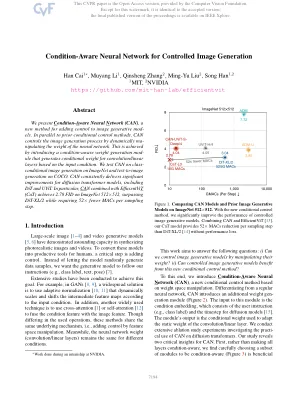
条件感知的神经网络,用于受控图像生成
我们介绍C ONTITION- WARE神经N ETWORK(CAN),这是一种将控制添加到图像生成模式中的新方法。与先前的条件控制方法并行,可以通过动态降低神经网络的重量来控制图像生成过程。这是通过引入条件感知的重量产生模式来实现的,该模块会根据输入条件为卷积/线性层生成条件重量。我们测试可以在Coco上的ImageNet和文本对图像生成上生成类别图像的生成。可以始终如一地为包括DIT和UVIT在内的扩散变压器模型提供显着改进。特别是,Ca n与有效的T(CAT)结合在Imagenet 512×512上达到2.78 FID,超过DIT-XL/2,同时每个采样步骤需要少52×MAC。

训练小波域损失的训练生成图像超分辨率模型可以更好地控制伪影
抽象的超分辨率(SR)是一个不当的反问题,其中具有给定低分辨率图像的可行解决方案集的大小非常大。已经提出了许多算法,以在可行的解决方案中找到一种“好”解决方案,这些解决方案在忠诚度和感知质量之间取得了平衡。不幸的是,所有已知方法都会生成伪影和幻觉,同时试图重建高频(HF)图像细节。一个有趣的问题是:模型可以学会将真实图像细节与文物区分开吗?尽管有些重点侧重于细节和影响的分化,但这是一个非常具有挑战性的问题,并且尚待找到满意的解决方案。本文表明,与RGB域或傅立叶空间损耗相比,使用小波域损失功能训练基于GAN的SR模型可以更好地学习真正的HF细节与伪像的表征。尽管以前在文献中已经使用了小波域损失,但在SR任务的背景下没有使用它们。更具体地说,我们仅在HF小波子带上而不是在RGB图像上训练鉴别器,并且发电机受到小波子带的忠诚度损失的训练,以使其对结构的规模和方向敏感。广泛的实验结果表明,我们的模型根据多种措施和视觉评估实现了更好的感知延续权权衡。
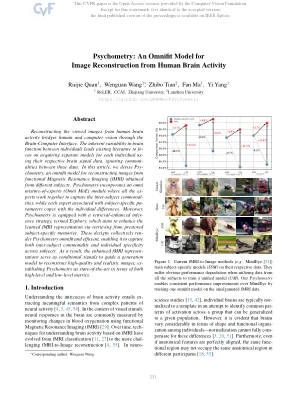
心理测量:一种用于从人类大脑活动重建图像的万能模型
通过脑机接口,重建所看到的人脑活动图像连接了人机视觉和计算机视觉。由于个体之间大脑功能存在固有差异,现有文献主要集中于使用每个人各自的脑信号数据为每个人获取单独的模型,而忽略了这些数据之间的共性。在本文中,我们设计了心理测量学,这是一个全方位模型,用于重建从不同受试者获得的功能性磁共振成像 (fMRI) 图像。心理测量学包含一个全方位专家混合 (Omni MoE) 模块,其中所有专家共同努力捕捉受试者间的共性,而与特定受试者参数相关的每个专家则负责处理个体差异。此外,心理测量学还配备了一种检索增强推理策略,称为 Ecphory,旨在通过检索预先存储的特定受试者记忆来增强学习到的 fMRI 表征。这些设计共同使心理测量变得万能而高效,使其能够捕捉受试者之间的共性和个体差异。因此,增强的 fMRI 表征可作为条件信号来指导生成模型重建高质量逼真的图像,从而使心理测量在高级和低级指标方面都成为最先进的技术。