
XiaoMi-AI文件搜索系统
World File Search SystemModeling

对表面质子耦合电子转移的反应性进行建模
Krauss,T。D.*; Bren,K。L.*; Matson,E。M*。 “通过多氧化烷层簇从CDSE量子点中增强光催化氢的活性”。 Commun。,2020,56,8762-8765。Krauss,T。D.*; Bren,K。L.*; Matson,E。M*。“通过多氧化烷层簇从CDSE量子点中增强光催化氢的活性”。Commun。,2020,56,8762-8765。
掩盖图像建模前进3D医学图像分析
最近,由于它能够从大量未标记的数据中学习,因此蒙版的图像建模(MIM)引起了很大的关注,并且已被证明对涉及自然IM的各种视觉任务有效。同时,由于数量的未标记图像以及质量标签的费用和困难,预计自我监督的学习3D医学图像的潜力预计将是巨大的。但是,MIM对医学图像的适用性仍然不确定。在本文中,我们证明了掩盖的进度建模方法除自然图像外,还可以推进3D医学图像分析。我们研究掩盖图像建模策略如何从3D医疗图像段的角度利用绩效,作为一项代表性的下游任务:i)与天真的对比度学习相比,掩盖的图像建模ap-par-ap-par-ap-par casge casge casge casgence convelence contergencience convergence contressed of被监督的火车的融合甚至更高(1.40×)得分(1.40×),并最终会产生较高的股票; ii)预测具有较高遮盖比和相对较小的斑块大小的原始体素值是用于医学图像的非琐碎的自我监督借口任务; iii)重建重建的轻量级解码器或投影头对3D医疗图像的掩盖图像模型非常可靠,该图像可以加快训练并降低成本; iv)最后,我们还研究了应用不同图像分辨率和标记的数据比率的不同实际情况下的MIM方法的有效性。匿名代码可在https://github.com/zekaichen/mim-med3d上找到。

基于二维稀疏心脏磁共振成像的三维双心室心脏形状重建和建模的神经变形模型
我们提出了一种新颖的神经可变形模型 (NDM),旨在从二维稀疏心脏磁共振 (CMR) 成像数据中重建和建模心脏的三维双心室形状。我们使用混合可变形超二次曲面对双心室形状进行建模,该超二次曲面由一组几何参数函数参数化,能够进行全局和局部变形。虽然全局几何参数函数和变形可以从视觉数据中捕捉到总体形状特征,但可以学习局部变形(参数化为神经微分同胚点流)来恢复详细的心脏形状。与传统可变形模型公式中使用的迭代优化方法不同,可以训练 NDM 来学习此类几何参数函数、来自形状分布流形的全局和局部变形。我们的 NDM 可以学习以任意尺度加密稀疏心脏点云并自动生成高质量的三角网格。它还可以隐式学习不同心脏形状实例之间的密集对应关系,以实现准确的心脏形状配准。此外,NDM 的参数直观,医生无需复杂的后处理即可使用。大型 CMR 数据集上的实验结果表明,NDM 的性能优于传统方法。

通过解决迷宫的增强学习对小鼠的基底神经节进行建模
本文的目的是通过深度增强学习对小鼠大脑的基底神经节功能进行建模。众所周知,基底神经节可以提供带有皮质直接影响运动功能的反馈回路。基底神经节中的大多数神经元都是抑制性或多巴胺能。这类似于加强学习的奖励体系。由于几乎不可能对基底神经节的整个应用进行建模,因此本文将重点介绍在迷宫的应用程序中对基底神经节进行建模,其中鼠标在迷宫中,并且需要找到“一块奶酪”(奖励)。这种现实世界的测试通常是在小鼠上进行的,并很好地展示了如何通过增强学习,通过奖励模仿学习[1]。在这种情况下,将在模拟动作方面抽象出其他相关领域(如感觉皮层和运动皮层)的功能和建模。总体而言,通过增强学习对基础神经节的关键功能将是其在行动选择和学习中的用途。
复合材料:建模,加工和表征
问题主机DOF 3D DOF主机/3D误差变量和收敛模式非均匀性动脉粥样硬化斑块 - 光束23529 761244 3%3%3%tranverse轴向应变,宿主 - > 3D复合cection cection cection spar - 光束89175 227675 2276739 4%25%25%25%25%25%25%的Edge Edge Ender-Ender 7 3D-3D-3D-3D-3D-3D-> - > 4560150 3% 30% Free-edge failure index, 3D -> HOST Composite notched specimen – Plate 10000 10000000 0.1% 3% Tensile peak stress, HOST -> 3D Multilayered beam – Beam 23595 63210 37% 0.4% Plastic strain, HOST -> 3D Double-swept blade – Beam 13200 203808 6% 1% Natural frequencies, HOST -> 3D Viscoelastic beam – Beam 5475 56400 10% 5% Modal loss factor, HOST -> 3D Randomly distributed RVE – Beam 13642 31524 43% 2% Local shear strain, HOST -> 3D Lattice structure – Beam 13584 617580 2% 1% Displacement, HOST -> 3D Three-point bending of a sandwich beam – Beam 14229 201504 1% 0% Transverse stress, HOST -> 3D Low-velocity impact on a bi-metallic plate – Plate 10659 856251 1% 16% Plastic strain, 3D -> HOST Large deflections in asymmetric cross-ply beams – Beam 5124 573675 1% 7% Shear stress, HOST -> 3D Disbonding in sandwich beams – Beam 41160 171888 24% 1% Peak load, HOST -> 3D Curing of a composite part –梁16569 599571 3%0%弹簧斜角,3D->主机

莱曼,弗兰克;越野,丹尼尔; Zimmermann;迈克尔},title = {{{tosca4qc:Tosca自动化
摘要 - 量词计算引入了一种新的计算范式,该范式有望解决无法通过经典计算机效率解决的问题。因此,量子应用程序将越来越多地集成到经典应用中。要将这些复合应用程序带入生产中,需要进行自动部署和编排技术,以避免手动易行错误和耗时的过程。对于非量化应用程序,近年来已经开发了各种部署技术。但是,量子应用程序的部署目前与非量子应用程序显着不同,因此导致了用于部署量子应用程序的不同建模程序。为了克服这些问题,我们提出了TOSCA4QC,该TOSCA4QC介绍了两种部署建模样式,该模型基于拓扑和编排规范的云应用程序(TOSCA)标准(TOSCA)标准,用于自动化量子应用的部署和编排:(i)SDK规格模型的模型,以覆盖所有技术模型,以涵盖所有技术部署详细信息(II)技术的详细信息(II)详细信息(II)详细信息(II)详细信息(II)。原则。我们进一步展示了如何将现有的模型驱动开发(MDD)方法应用于将SDK-静态模型重新定为可执行的SDK特定模型。我们证明了原型实施的实际可行性,作为Tosca生态系统Opentosca的扩展以及IBMQ和量子模拟器的三个案例研究。索引术语 - Tosca,量子计算,部署自动化,建模,编排

明智的帮助:在家庭中积极主动和自适应机器人帮助的战略对手建模
尽管在日常任务中对弱势群体(例如,老年人,儿童和残疾人)的辅助技术有很大的需求,但对高级AID辅助解决方案的研究确实满足了他们的各种需求,这仍然很少。传统的人机互动任务通常需要机器来简单地帮助您对人类能力和感觉的细微差别,例如他们进行实践和学习的机会,自我改善感和自尊心。解决这一差距时,我们定义了一个关键而新颖的挑战智能帮助,旨在为各种残疾人的人提供积极主动而自适应的支持,并在各种任务和环境中提供动态目标。为了确定这一挑战,我们利用AI2- [32]来构建一个新的互动3D实体家庭环境,以完成智能帮助任务。我们采用了一个创新的对手建模模块,该模块对主要代理的能力和目标有细微的理解,以优化辅助代理人的帮助政策。严格的实验验证了我们的模型组件的功效,并显示了我们整体方法与已建立基线的优越性。我们的发现说明了AI所辅助机器人在改善弱势群体的福祉方面的潜力。
创新的预测量子计算机建模
世纪,在量子级别上开发有效的工具是相当多的,以提高数据的确定性和互操作性。量子计算机以量子力学为基本的原理,即使我们正处于开发的开始,仍然有望带来惊喜。Quantum计算机是唯一可以实现指数加速经典compoter的计算模型。量子计算机当前面临的主要挑战包括增加或减少给定系统的量子数量,同时管理以保留量置的属性和量子系统的纠缠状态,以通过适当的量子算法执行数据操作。在本文中,我们将概述量子计算机,将描述加密的演变以及与量子计算机的计算性能,效率和预测性建模有关的理论。原型和量子模拟算法将提出改善新量子宇宙的寿命。

建模合作者:通过LLM工具使用
从内容节制到野生动植物保护,需要模型识别细微或主观的视觉概念的应用数量正在增长。传统上,开发用于此类概念的分类器需要在数小时,天甚至数月内衡量的大量手动努力来识别和注释培训所需的数据。即使最近提出的敏捷建模技术可以快速地进行图像分类器的快速启动,但仍需要用户花费30分钟或更多的单调,重复的数据标签,以训练一个罪恶的分类器。利用了Fiske的认知灾难理论,我们提出了一个新框架,通过用自然语言相互作用代替人类标签,从而减少了由自然语言相互作用,从而减少了通过一个数量级来定义的总体努力所需的总体努力:从将2,000张标记的图像定义为只有2,000张图像到只有100张图像到100次自然语言相互作用。我们的框架利用了大型语言模型和视觉语言模型的基础模型的最新进展,以通过对话和自动标记培训数据点来雕刻概念空间。最重要的是,我们的框架消除了对人群来源注释的需求。此外,我们的框架最终生产出在成本敏感的方案中可部署的轻量级分类模型。在15个主观概念和2个公共图像分类数据集中,我们训练的模型的表现优于传统敏捷建模以及最先进的零拍模型,例如Align,clip,cupl,Cupl和大型视觉问题回答诸如Pali-X之类的模型。
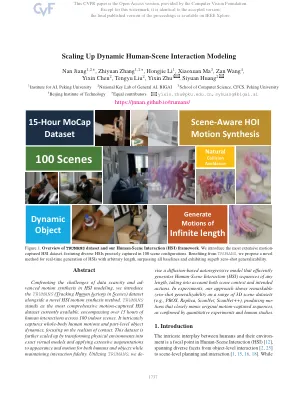
扩展动态的人类场景相互作用建模
已经取得了显着的迈进,该领域显然是由于缺乏高质量数据集而导致的。早期数据集(如Pigraphs [39]和Prox [16])启动了探索,但受到可扩展性和数据质量的约束。MOCAP数据集[14,30]使用Vicon等复杂的设备优先考虑高质量的人类运动限制。但是,他们通常缺乏捕获多样化和沉浸式的HSI。通过RGBD视频录制的可扩展数据集提供了更广泛的实用程序,但受到人类姿势和对象跟踪质量较低的阻碍。合成数据集的出现[1,3,4,55]提供了成本效率和适应性,但无法封装完整的现实HSI频谱,尤其是在捕获动态3D触点和对象跟踪时。为了应对这些挑战,这项工作首先引入了trumans(t rack hum a um a u u u u u u u u u u u u u u a ctio n s in s cenes)数据集。Trumans成为最广泛的运动捕获HSI数据集,涵盖了15个小时以上15个小时的室内场景中的各种相互作用。它捕获了全身的人类动作和部分级别的对象动力学,重点是接触的现实主义。通过将物理环境复制到准确的虚拟模型中,可以进一步增强此数据集。外观和运动的广泛增强都应用于人类和物体,以确保相互作用的高度有限。接下来,我们设计了一个计算模型,通过将场景和动作作为条件同时采取行动来应对上述挑战。我们对杜鲁士数据集和运动合成方法进行了全面的交叉评估。特别是,我们的模型采用自回归的条件扩散,场景和动作嵌入作为征用输入,能够产生任意长度的运动。为了整合场景上下文,我们通过在本地化的基础上查询全局场景的占用来开发有效的场景感知者,这在导航杂乱的场景时表现出了3D感知的碰撞避免的强大效率。为了将框架的动作标签合并为条件,我们将时间特征集成到动作片段中,使模型在粘附在给定的动作标签时随时接受指令。场景和动作条件的这种双重整合增强了我们方法的可控性,为在3D场景中合成合理的长期运动提供了细微的界面。将trumans与现有人物进行比较,我们证明了杜鲁士人明显提高了最先进的方法的性能。此外,我们的方法在定性和定量上进行了评估,超过了现有的运动综合方法,其质量和零击性能力在看不见的3D场景上,非常接近原始运动捕获数据的质量。除了运动合成之外,杜鲁士人已经针对人类的姿势和接触估计任务进行了基准测试,证明了其多功能性并将其确立为一系列未来的研究努力的宝贵资产。