
XiaoMi-AI文件搜索系统
World File Search SystemScene
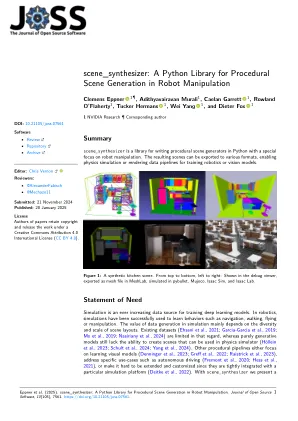
scene_synthesizer:机器人操纵中的程序场景生成的Python库
仿真是培训深度学习模型的越来越多的数据源。在机器人技术中,模拟已成功地用于学习诸如导航,步行,飞行或操纵之类的行为。模拟中数据生成的价值主要取决于场景布局的多样性和规模。现有数据集(Ehsani等,2021; Garcia-Garcia等,2019; Mo等,2019; Nasiriany等,2024)在这方面受到限制,而纯粹的生成模型仍然缺乏在物理模拟中可以使用的场景(HOLLEIN及2023 al。el。,et e e eT el。 2024)。其他程序管道要么专注于学习视觉模型(Denninger等,2023; Greff等,2022; Raistrick等,2023),要解决特定的用例,例如自主驾驶(Fremont等,2020; Hess等; Hess等,2021),或者很难扩展和自定义的平台(它们是一个特定的平台(它们是一个与众不同的平台(DET)(DEIT)(DEIT)(DEIT)(DEIT)(DEIT)(DETIT)(DETER)(DETER)。 )。使用scene_synthesizer我们提出
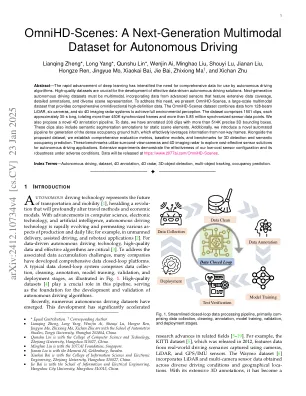
OmniHd-Scenes:用于自动驾驶的下一代多模式数据集
摘要 - 深度学习的快速进步加剧了对自动驾驶算法使用的全面数据的需求。高质量数据集对于开发有效数据驱动的自动驾驶解决方案至关重要。下一代自动驾驶数据集必须是多模式的,结合了来自高级传感器的数据,这些数据具有广泛的数据覆盖率,详细的注释和不同的场景表示形式。为了满足这一需求,我们提出了OmniHd-Scenes,这是一个大规模的多模式数据集,可提供全面的全向高清数据。OMNIHD-SCENES数据集结合了来自128束梁雷达,六个摄像机和六个4D成像雷达系统的数据,以实现完整的环境感知。数据集包含1501个夹子,每个夹子长约30秒,总计超过450K同步帧和超过585万个同步传感器数据点。我们还提出了一个新颖的4D注释管道。迄今为止,我们已经注释了200个剪辑,其中有超过514K精确的3D边界框。这些剪辑还包括静态场景元素的语义分割注释。此外,我们还引入了一条新型的自动化管道,以生成密集的占用地面真理,从而有效利用了非钥匙框架的信息。与拟议的数据集一起,我们为3D检测和语义占用预测建立了全面的评估指标,基线模型和基准。这些基准测试利用环绕摄像机和4D成像雷达来探索用于自动驾驶应用的具有成本效益的传感器解决方案。广泛的实验证明了我们的低成本传感器构型及其在不利条件下的鲁棒性的有效性。数据将在https://www.2077ai.com/omnihd-scenes上发布。

校正:基于带注释的像素和点云的弱监督语义分割
在此处给出了完整的确认部分:致谢:这项工作得到了中国国家自然科学基金会(No.62227801和No.UME20B2062,No.62376024)的支持,以及中国国家关键研究与发展计划(20222ZD0117900)。


法医专家II,DEU犯罪现场技术员
6。在适当的情况下,使用详细的书面报告,照片和图表记录证据恢复和处理犯罪现场。7。保护犯罪现场免受污染。8。在犯罪现场处理技术,证据收集和保存方法方面的证词和法院提供可信的专家证词。根据需要准备报告,照片,图表和其他视觉助手。9。检查并卸下枪支。10。执行案例的技术/行政评论。11。位置需要打个电话状态。保持可靠且可预测的出勤率。必须具有必要的加班,灵活的时间,夜晚,周末和/或假期的强制性加班能力。12。必须具有在所有类型的天气条件下处理犯罪场景的能力。13。现任者有望继续通过研究,参加教育会议,相关课程或讲习班,并保持最新的国家麻醉趋势和安全预防措施以进行恢复和测试。14。必须能够在所有环境中佩戴APR/SCBA时正确地戴和DOFF个人防护设备并执行艰巨的任务。15。根据需要执行相关职责。16。此类规范不应被解释为包容性。旨在确定此工作的基本功能和要求。可以要求任职者执行与工作相关的职责和任务,而不是本规范中所述的任务。如果任职者/申请人无法执行该功能或要求,则该类别的任何基本功能或要求将根据2008年《美国残疾人法》(ADA)的修订(ADAAA)修订(ADAAA)修订;以及《密苏里人权法》(MHRA)。

mllm-sul:在流量方案中的语义场景理解和本地化的多模式大语言模型
摘要 - 多模式大语言模型(MLLM)在许多自动驾驶任务中都表现出令人满意的效果。在本文中,MLLM可用于解决联合语义场景的理解和风险本地化任务,而仅依靠前视图像。在拟议的MLLM-SUL框架中,双分支视觉编码器首先旨在从两种分辨率中提取特征,并且丰富的视觉信息有助于语言模型,以准确描述不同尺寸的风险对象。然后,对于语言生成,美洲驼模型进行了微调,以预测场景描述,其中包含驾驶场景的类型,风险对象的动作以及驱动意图和自我车辆的建议和建议。最终,基于变压器的网络结合了回归令牌,以定位风险对象。在现有的戏剧 - 罗利人数据集和扩展的戏剧-SRIS数据集上进行了广泛的实验表明,我们的方法是有效的,超过了许多基于图像的最新和基于视频的方法。具体来说,我们的方法在现场理解任务中获得了80.1%的BLEU-1分数和298.5%的苹果酒得分,而本地化任务的精度为59.6%。代码和数据集可在https://github.com/fjq-tongji/mllm-sul上找到。

PAC 成员表演的 Stagestruck 场景
Greenbriar at Whittingham VOICE 是新泽西州门罗镇 Greenbriar at Whittingham 居民出版的月刊。所有要出版的编辑材料应在出版月份前一个月的 3 号或之前提交给编辑部。Greenbriar at Whittingham 居民可以将材料投递到位于 Towne Centre 图书馆的 GW VOICE 邮箱。Greenbriar at Whittingham VOICE 对可能出现的任何印刷错误概不负责,包括其展示或分类广告中的印刷错误,以及广告空间成本。注意:据 The VOICE 和 Princeton Editorial 所知,Greenbriar at Whittingham VOICE 中的广告准确呈现了所提供的产品和服务。但是,The VOICE 或任何其他方不代表或暗示认可。所有材料的接受由出版商自行决定。我们保留编辑所有材料的权利

Duffield Scene 2025 年 1 月
当罗德尼·伍德 (Rodney Wood) 于 1999 年提出要建立一个自然保护区来庆祝千禧年时,他和达菲尔德的居民都没有想到这个美妙的地区会取得如此大的成功,以及它对村庄的重要性。它因对增加生物多样性的贡献而获奖,一些稀有物种被记录在案。最重要的是,它给所有在这里散步的人带来了极大的快乐,他们欣赏着树木、花朵、动物、鸟类和昆虫不断变化的色彩。这是一个安全、平静的散步场所,有机会静静地坐在大自然中,观看和聆听河流的声音,感受一天的压力消失。它还为威廉吉尔伯特学校的孩子们提供了一个参加森林学校的机会,在那里他们可以亲身体验自然。谢谢罗德尼。我决定坐下来阅读去年 1 月的文章,以提醒自己一年前的情况,并回想起去年冬天的洪水事件。被洪水淹没的房屋、田野和道路让人们非常痛心,德文特河的水位是前所未有的。一年后,当我写下这篇文章时,情况已经大不相同了。谢天谢地,大多数人都会
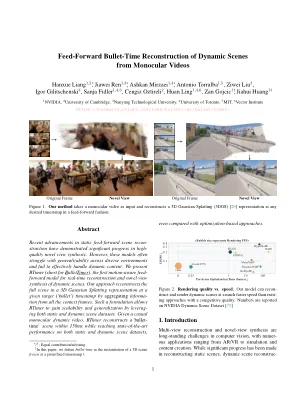
单眼视频的动态场景的进发弹时间重建
静态馈送场景的最新进展已显示出高质量的新型视图合成中的显着进步。但是,这些模型通常会在各种环境中的普遍性中挣扎,并且无法有效处理动态内容。我们提出了BTIMER(Bullettimer的缩写),这是实时重建和动态场景的新型视图综合的第一个运动感知馈送模型。我们的方法通过从所有上下文框架中汇总信息,以给定目标(“子弹”时间戳)在给定目标的3D高斯分裂表示中重建整个场景。这样的公式允许BTIMER通过掌握静态和动态场景数据集来获得可扩展性和概括性。给定一个随意的单眼视频,BTimer在150ms内重建了子弹时间1场景,同时在静态和动态场景数据集上达到最先进的性能,

利用扩散模型的可靠和可编辑场景
项目说明恢复场景的属性,例如许多计算机视觉和计算机图形应用程序中的形状,材料和照明属性是至关重要的任务。此任务称为逆渲染,它可以启用对象插入[1],场景重新定义[2]和场景编辑[3]。在学习场景的3D表示方面的最新进展显示出令人印象深刻的新型合成结果,例如NERF [4]和3D高斯裂口[5]。但是,由于场景属性被烘烤到辐射字段中,这些表示不可重复 /可编辑。许多最先进的解决方案[6,7,8]提出了反向渲染管道,使这些3D表示可以编辑。尽管取得了这种进步,但当前的方法通常与铸造阴影,镜头亮点和其他复杂的照明相互作用困难。基于扩散的生成模型[9]已成为一种有希望的视觉生成方法。扩散模型可以更改许多图像方面,例如图像样式[10]或将前景对象融合到背景[11],重新贴上场景[12],编辑特定对象的颜色[13]等。这种适应性强调了扩散模型有效地学习和操纵各种内在场景的潜力,包括材料和照明条件,同时维持光真相。它们在编辑任务中的用法会导致灵活的表示形式,从而可以操纵场景属性[14,15]。此实习将着重于开发利用扩散模型的方法来解开和操纵内在的场景属性,包括材料和照明。实习生将探索新颖的方法,以产生完全可编辑且可重新确定的表示形式。特定目标包括: