
XiaoMi-AI文件搜索系统
World File Search SystemSing

文章的风险因素和先天性心脏病的儿童在体外膜中氧合 - 十年单中心报告
摘要:对于患有先天性心脏缺陷(CHD)的儿童,可能需要进行体外生活支持。这项回顾性的单中心研究旨在调查体外膜氧合(ECMO)儿童的结果,重点是各种危险因素。在88例患者中,有36例(41%)具有单腹膜心脏缺陷,而52(59%)的患者患有双心脏缺陷。总共有25个(28%)幸存,第一个组中有7(8%),后者有18个(20%)。p值为0.19,表明存活率没有显着差异。患有双室心脏的儿童的ECMO持续时间较短,但在重症监护室中停留更长的时间。单个心室的儿童(赔率[OR] 1.57,95%的置信间隔[CI] 0.67–3.7)的儿童ECMO并发症的总体率更高。在两组中,出血都是最常见的并发症。单个心室患者(22%比9.6%),第二次ECMO运行的发生更为常见。ECMO对于包括单腹膜患者在内的先天性心脏缺陷的儿童有效。出血仍然是与较差的结果相关的严重并发症。需要在30天内进行第二次ECMO运行的患者的存活率较低。

引用本文:Thomas KF Chiu、Benjamin Luke Moorhouse、Ching Sing Chai 和 Murod Ismailov (2023):教师支持和学生学习动机
摘要 随着人工智能 (AI) 技术的进步,它将不可避免地给课堂实践带来许多变化。然而,教育领域的人工智能研究与教学观点或教学方法的联系较弱,特别是在 K-12 教育领域。人工智能技术可能使有上进心和先进的学生受益。需要了解教师在课堂上使用人工智能技术调解和支持学生学习方面所起的作用。本研究使用自我决定理论作为支撑框架,调查教师支持如何调节学生专业知识对需求满足和使用人工智能技术学习的内在动机的影响。这项实验研究涉及 123 名 10 年级学生,并在实验中使用聊天机器人作为基于人工智能的技术。分析表明,使用聊天机器人学习的内在动机和能力取决于教师支持和学生专业知识(即自我调节学习和数字素养),教师支持更好地满足了关联性需求,而不太满足自主性需求。研究结果完善了我们对自我决定理论应用的理解,并扩展了人工智能应用和教学实践的教学和设计考虑。
无人机检测技术的评估 - 新加坡
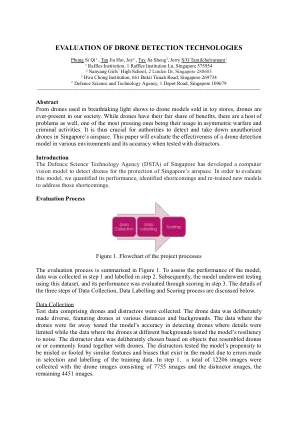
收集了包括无人机和干扰因素的数据收集测试数据。无人机数据故意多样化,以各种距离和背景为特色。无人机在遥远的地方测试了模型检测无人机的准确性,该数据的细节受到限制,而在不同背景下的无人机测试了模型对噪声的弹性。根据类似于无人机或与无人机一起发现的对象,故意选择了干扰物数据。由于在选择和标记训练数据时犯了错误,该模型测试了模型被模型中存在的类似特征和偏见误导或愚弄的倾向。在步骤1中,总共收集了12206张图像,其中包括7755张图像和分散图像,其余4451张图像。
研究@YDSP项目报告 - 新加坡
无人接地车辆(UGV)为传统校园监视方法提供了一种新颖的替代方法,包括手动巡逻和摄像机监视。该项目旨在为校园监视开发低成本,健壮和模块化的UGV,从而使校园安全能够有效地远程监视不同的区域。通过同时本地化和映射算法的使用,UGV能够映射和自动绘制。通过测试,我们确定了UGV的最佳计划和运动控制器在城市环境中运行。之后,UGV在本地执行计算机视觉(CV)任务,以通过使用姿势估计模型来检测其视线中的任何潜在入侵者。检测到的入侵者的图像将通过另一个姿势分类模型通过,以确定任何其他可疑运动。
映射在指数增殖的哺乳动物细胞中单拷贝基因座的DNA复制的起源
最近已经开发了一种用于确定双向DNA复制起源的物理位置的一般方法,并证明能够正确识别Simian病毒40复制的起源(L. vassilev和E. M. Johnson,Nucleic Acids,Res。17:7693-7705,1989)。该方法比以前报道的其他方法的优点是,它避免了使用代谢抑制剂的使用,细胞同步的需求以及对原点序列的多个副本的需求。将这种方法应用于含有未扩增的单拷贝二氢叶酸还原酶基因基因座的非扩增,单拷贝的卵巢凝胶的应用显示,DNA的复制在大约2.5千千公斤的起始区域开始,大约2.5个千千万酶,长期以来,长期以来,长期以来,大约17千千千万的基础与DHFR Gene的下降序列相结合,以前是早期复制的。这些结果证明了该映射方案用于识别复制的celular起源的实用性,并建议在正常和放大的DHFR基因座中使用相同的cedlular起源。

1。单细胞定量表达报告(SCQERS)
●将细胞和质粒混合到预燃烧的(ICE)1毫米比色杯以进行电穿孔(例如),非常小心地避免气泡(如果需要时,可以避免使用气泡,以避免气泡,移液器<25 ul)。将比色杯保持在冰上。●电塑料(例如Biorad Gene脉冲器,2 kV,200 𝛀,25 UF)。点击比色杯以消除气泡,并先用吸收纸从比色杯中擦拭冰/水。时间常数应在4.0至4.3 ms范围内。短时常数带有火花,表明出现问题。如果发生这种情况,请重复,减少质粒的量并注意气泡。●成功进行电穿孔后,立即添加475 UL恢复介质(例如SOC),转移到1.5 ml管,并在37℃下摇动。●串行稀释电穿孔,板块在氨苄青霉素板上的转化为0.1%,以评估转化效率。●您可以将电穿孔的细胞保持在4C,直到确认高效率,也可以用氨苄青霉素在LB中过夜(通常在250毫升250 mL烧瓶中,37C,37C,轨道振荡器200 rpm)。●确认高效率后(您应该在0.1%板中看到> 1000个菌落,对应于1m> 1m的转化剂),制作甘油库存以备将来使用,并通过mini或MIDI Prep纯化质粒或MIDI PREP,适用于下游克隆
shvit:带有内存有效宏设计的单头视觉变压器
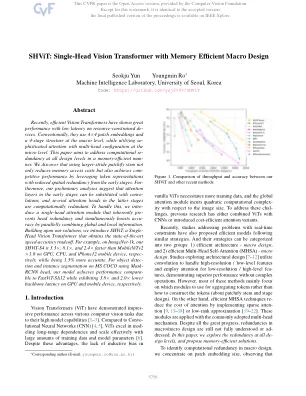
最近,有效的视觉变压器表现出出色的性能,并且在资源受限的范围内延迟较低。通常,他们在宏观水平上使用4×4贴片嵌入式和4阶段结构,同时在微观级别利用多头配置的同时注意力。本文旨在解决记忆效率高的人中所有设计级别的计算重复。我们发现,使用较大的修补茎不仅降低了内存访问成本,而且还通过利用令牌表示,从早期阶段降低了空间冗余,从而实现了态度性能。fur-hoverore,我们的初步分析表明,在早期阶段的注意力层可以用会议代替,并且后期阶段的几个注意力头在计算上是多余的。为了处理这一点,我们介绍了一个单头注意模块,该模块固有地预先预先冗余,并同时通过相结合的全局和本地信息来提高准确性。在解决方案的基础上,我们引入了Shvit,这是一种单头视觉变压器,获得了最先进的速度准确性权衡。例如,在ImagEnet-1k上,我们的SHVIT-S4在GPU,CPU和iPhone12移动设备上比MobileVitV2×1.0快3.3×,8.1×和2.4倍,而同时更准确。用于使用Mask-RCNN头对MS Coco进行的对象检测和实例分割,我们的模型分别在GPU和移动设备上表现出3.8×和2.0×下骨架潜伏期时,可以与FastVit-SA12进行比较。

首先要筛查单胎怀孕中无细胞的胎儿DNA的非整倍性 - 瑞士单中心体验
通过检测无细胞DNA(C Q Q QA)和非侵入性产前测试(NIPT)[1,2]的发育来彻底筛选染色体非整倍型的染色体。While over decades, the detection rate (DR) of trisomy 21 could be improved from only 30% to 90% at a false positive rate (FPR) of 5% by first trimester combined screening (FTCS), c ff DNA has a DR of Down syndrome of 99% at a very low FPR of 0.04% [3, 4, 5, 6, 7, 8, 9, 10, 11, 12].三体三体第18和18的DRS与双胞胎妊娠中的C扰性[9、10、11、12]相似。尽管表现出色,但C效应仍然是筛查测试,并且通过侵入性测试确认了高风险C扰动的结果[13,14]。由于其高昂的成本,大多数医疗保健系统并未对所有孕妇进行DNA筛查。因此,已经提出了直接c或偶然筛选的不同模型[15,16,17]。在瑞士,所有孕妇的健康保险提供者都偿还了FTC,包括一名经过认证的超声检查员的详细超声检查,并测量了胎儿颈部半透明(NT)以及生化分析。在超声波中看到的胎儿异常,NT> 95%的胎儿疾病或FTCS≥1:380的任何三体造期风险。自2015年7月以来,作为全球最早的国家之一,斯威茨 - 以偶然的方式实施了常规筛查。如果在FTC上将孕妇年龄(MA)和NT与生化血清标记物β-人类绒毛膜促性腺激素

egecentric 3D手姿势估计的单一对偶视图改编
对准确的3D手姿势估计的追求是理解以自我为中心视力领域的人类活动的基石。大多数现有估计方法仍然依赖单视图像作为输入,从而导致潜在的局限性,例如,深度有限的视野和义务。解决这些问题,添加另一个相机以更好地捕获手的形状是实践方向。然而,现有的多视图手姿势姿势方法具有两个主要缺点:1)重新训练的多视图注释,这些注释是备用的。2)在测试过程中,如果相机参数/布局与训练中使用的相同,则模型将变为inpapplicable。在本文中,我们提出了一种新颖的单算观看改编(S2DHAND)解决方案,该解决方案将预先训练的单视估计器适应双视图。与现有的多视图训练方法相比,1)我们的适应过程是无监督的,消除了对多视图注释的需求。2)此外,我们的方法可以处理带有未知相机参数的Arbitarary双视图对,从而使该模型适用于不同的相机设置。具体来说,S2DHAND建立在某些立体声约束上,包括两种视图之间的成对跨视图共识和转换的不变性。这两个立体声约束以互补的方式使用来进行伪标记,从而允许可靠的适应性。评估结果表明,在内部和跨数据库设置下,S2DHAND在任意摄像机对上实现了重大的实现,并且胜过具有领先性能的现有适应方法。项目页面:https://github.com/ut-vision/s2dhand。
单眼弱监督的单眼3D检测...
单眼3D检测(M3D)的目的是从单视图像中进行精确的3D观察定位,该图像通常涉及3D检测框的劳动密集型注释。最近已经研究了弱监督的M3D通过利用许多存在的2D注释来遵循3D注释过程,但通常需要额外的培训数据,例如LiDAR Point Clouds或多视图图像,这些数据会大大降低其在各种应用中的适用性和可用性。我们提出了SKD-WM3D,这是一个弱监督的单眼3D检测框架,利用深度插入以实现M3D,并具有单一视图图像,而无需任何3D注释或其他培训数据。SKD-WM3D中的一个关键设计是一个自我知识的蒸馏框架,它通过融合深度信息并有效地减轻单核场景中固有的深度模棱两可,从而将图像特征转换为3D类似的表示形式,而无需计算上的计算层面。此外,我们设计了不确定性感知的分离损失和梯度定位的转移调制策略,分别促进了知识获取和知识转移。广泛的实验表明,SKD-WM3D明显超过了最新的实验,甚至与许多完全监督的方法相当。