
XiaoMi-AI文件搜索系统
World File Search SystemWhere
分析“为什么?”和“哪里”招聘过程有时会失败:焦点
irm/dvs/mba/ma-econ摘要:本研究的主要目的是分析招聘过程的复杂性,该过程在选择候选人时会导致过程偏见,并提出一种可能的方法,该方法可以缓解一个关键步骤之一,即在招聘过程中招募合适的候选人,即在招聘过程中简称或筛选。这个过程,如果不仔细研究,则应导致人力资源管理(HRM)招聘团队在筛选合适的候选人进行面试时的决策不良。数据源是通过办公桌调查从现有文献和知识体系中收集的,以及对各种组织和商业公司的招聘人员的访谈。在本研究中采用了定性研究方法。收集信息的方法是结构化的和非结构化的问卷。判断抽样技术。“ NC”组织(南苏丹共和国的一个监管机构),“ NP”政府公司以及公司“ JN”公司,该公司是互联网服务提供商(ISP)和组织“ ARD-AF”,这是南苏丹即将到来的民间社会组织的样本。为了本研究的目的,研究人员决定利用Excel表进行数据分析。强调了受访者的专业成就及其对在招聘过程中应用的入围方法的认识程度已得到强调。简介HRM部门在组织结构中非常重要。关键字:招聘,偏见,问卷调查,调查,判断,数据分析,筛选,入围,裙带关系,HRM,组织和样本。可以确保该组织招募合适的工作候选人,并为官员提供与他们的时间,精力和专业知识相称的适当薪酬(Szalados,2021年)。该部门进一步指导组织遵守组织和运营国家的法律文书。在人力资源管理部门内确定了工作需求,启动了能力建设计划并进行了绩效评估,进行了精神和其他挑战的官员的咨询,以确保工作场所的安全和公平治疗方面的安全措施(Radin等人,2019年)。这些是提高组织中生产率,减少时间和资源浪费,限制周转率并维持运营方面的关键练习。招聘是由组织的需求指导的,这是由于对现有劳动力无法进行的庞大或不断增加的工作活动所产生的劳动需求的增加,或者从事新业务

让人工智能在最重要的地方发挥作用
从提示到生产力:为您的团队释放 AI 的全部潜力。ChatGPT 和 Copilot 等 AI 工具正在彻底改变我们的工作方式,但大多数企业仅触及它们功能的表面。本次研讨会专为希望超越基础并将 AI 集成到其工作流程中以实现最大影响的企业领导者和团队而设计。在您的业务中实施 AI 有三个级别:

人工智能的价值在哪里?
人工智能的常见说法涉及支持功能——人力资源、IT、法律等——其中相对低级和重复的功能的自动化可以创造巨大的价值。但创造最大价值的公司不仅在支持功能中部署生产力,而且还专注于重塑其核心业务流程并发明新的收入来源。他们正在从研发到运营,从销售和营销到客户服务等广泛职能中从人工智能中取得成果。由于他们已经建立了必要的能力,他们可以更容易地识别、试行和扩大创造价值的用例。例如,一家化学品公司预计将从端到端转型中创造超过 5 亿美元的价值,该转型将在运营、现场服务和采购中实施人工智能。

现在,与气候变化的战斗现在要去哪里?
•COP29在气候融资方面取得的进展有限,到2035年每年仅30亿美元来支持发展中国家•如预期的那样,没有任何跟进,如预期的那样,从化石燃料中过渡如何过渡到化石燃料中如何在最终的驾驶中降低了我们在2030年之前的范围,我们在最终的范围内都没有提及,我们在2030年之前就没有努力地进行整理,而我们又可以付出了代价,我们在2030年之前就可以在绿色的范围内进行过多的态度,我们在2030年之前就可以在绿色的范围内进行过多的态度,而我们却可以在2030年之前付出了良好的态度。它在欧洲在这一领域的努力进一步加速•唐纳德·特朗普的连任使对应对气候变化的斗争的不确定性引起了很多不确定性,但我们认为,各种保障措施都应该限制他在全球范围内的影响•经济和财务现实是企业的重点,这将使政治领先于政治

在哪里建立食物银行:机器学习方法
摘要 目前有超过 4400 万美国人饱受粮食短缺之苦,其中 1300 万是儿童。粮食短缺已导致一系列身体和发育问题。在美国各地,数以千计的食品银行和食品储藏室是粮食短缺家庭的重要食物和其他形式援助来源。通过优化食品银行的位置,急需食物的家庭将更容易获得食品银行及其资源。本文旨在构建一个机器学习框架,该框架能够优化食品银行的位置并考虑中等收入等因素。我们为此使用了 K 均值聚类算法,因为它具有高处理速度和考虑大量数据的能力,以及其无监督性质,不需要训练时间或标记训练数据。我们提出的方法将 K 均值应用于来自加利福尼亚州和印第安纳州美国人口普查和地理空间数据的一系列房屋,并在有收入数据时应用加权 K 均值算法。我们创建了旨在优先考虑低收入家庭的食品银行位置,并将这些位置与 Feeding America 下属的真实食品银行进行了比较。我们的结果表明,不仅 K-means 速度极快,而且我们的食品银行位置平均比现有的食品银行位置更好,缩短了加利福尼亚州和印第安纳州食品银行与家庭之间的距离。

“我的东西在哪里?”项目是一项协作电气行业的“供应链”可见性工作。电气行业协会参与者
“我的东西在哪里?”项目是一项协作电气行业的“供应链”可见性工作。电气行业协会的参与者包括全国电气分销商协会(NAED),国家电气制造商协会(NEMA),国家电气承包商协会(NECA)和国家电气制造商代表协会(NEMRA)。这项工作由全国电气分销商协会(NAED)通过其数字卓越中心(DCOE)领导和资助。的目标是通过创建所需的数据定义和标准,以及实时通信方法来提高电气行业的供应链透明度和效率,以使无缝访问实时信息无缝访问,从而彻底改变了订单的跟踪,管理和在整个供应链中进行的方式 - 在整个供应链中 - 在制造商,制造商,制造商,制造商,制造商,制造商的代表和最终用户客户和最终用户客户之间进行了沟通。

发生的(会议)房间发生:在有才华和才华横溢的教育中解释不正确的代表
当前的研究利用了一个大型学区的全面数据,以更好地了解天才教育中不正确的代表性的程度,可以通过种族和社会经济群体之间的平均评估评分差异来解释。的发现表明,在控制了非语言能力,认知能力,数学成就,阅读成就和对天才行为的教师评分,黑人学生,西班牙裔学生以及来自低收入背景的学生的可能性比同样得分的美国人或更高的美国或更高含量的人都高1.3倍至5.4倍。尽管有黑色,西班牙裔和低收入学生在有天赋的学生人数中仍然不足,但仍发现了这些结果。这项研究对理解和改善高级学习机会的公平交付具有重要意义。

印度经济将走向何方?
从总体来看,印度的情况稍好一些。2012 年,瑞士信贷估计印度的财富为 7.35 万亿美元,中国为 34.6 万亿美元,美国为 70.8 万亿美元。2022 年的数字分别为 15.4 万亿美元、74.5 万亿美元和 140 万亿美元。印度的崛起落后于中国。其增量为 8 万亿美元(约合每人 6,200 美元),而美国为 70 万亿美元(每人超过 210,000 美元)。2010 年至 2023 年,印度的财富年增长率为 7%,中国为 8%,美国为 6%。18 2013 年至 2023 年,印度 GDP 几乎翻了一番,年产出增加了 1.7 万亿美元。中国 GDP 的增长速度没有那么快,但也增加了 8 万亿美元。美国的速度要慢得多,但也增加了 10.5 万亿美元。 19 使用美元对印度不利,因为卢比在此期间贬值近 40%。但这引发了一个问题:为什么这个增长最快的大型经济体的货币如此长期疲软。
vanp:学习自我导航的位置...
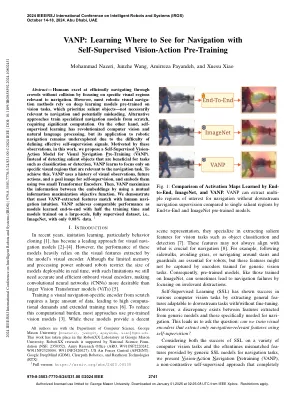
摘要 - 人类通过专注于与导航相关的特定视觉区域,在没有碰撞的情况下有效地通过人群导航。但是,大多数机器人视觉导航方法都依赖于对视觉任务进行预训练的深度学习模型,这些模型优先考虑显着对象,而不一定与导航和潜在的误导有关。替代方法从头开始训练专业导航模型,需要大量计算。另一方面,自我监督的学习彻底改变了计算机视觉和自然语言处理,但是由于难以定义有效的自学信号,因此其在机器人导航中的应用仍未被忽略。是由这些观察结果激励的,在这项工作中,我们为视觉导航预训练(VANP)提出了一种自我监督的视觉动作模型。而不是检测对分类或检测等任务有益的显着对象,而是学会仅专注于与导航任务相关的特定视觉区域。为了实现这一目标,VANP使用了视觉观察的历史记录,未来的动作和一个自upervision的目标图像,并使用两个小型变压器编码器嵌入它们。然后,通过使用共同信息最大化目标函数,VANP最大化嵌入之间的信息。我们证明了大多数VANP提取的功能与人类导航直觉匹配。vanp的性能可相当,因为模型学习了端到端的一半训练时间和在大规模,完全监督的数据集(即Imagenet)上进行培训的模型,只有0.08%的数据。1

在哪里接种必需和推荐的疫苗
CVS/TARGET 确保您在网络内就诊以降低费用。要查找网络内提供商,请拨打保险卡背面的免费电话或访问保险公司的网站。务必提前致电确认疫苗供应情况并讨论任何可能的费用。