
XiaoMi-AI文件搜索系统
World File Search Systempresenta

知识表示和人类机器人互动领域知识的互动学习
本文介绍了在人机协作背景下代表,推理和交互式学习领域知识的综合体系结构。答案集Prolog是一种非单调逻辑推理范式,用于用不完整的comsense域知识来表示和理由,为任何给定目标计算计划并诊断出意外的观察。基于ASP的推理还用于指导以前未知的动作的互动学习以及编码负担能力,动作前提和效果的公理。此学习将主动探索,反应性动作执行和人类(口头)描述的输入观察以及学习的动作和公理用于后续推理。在模拟机器人上评估了架构,该机器人协助人类在室内域中。

使用4D隐式神经表示
构建准确的地图是构成可靠的局部设备,计划和导航的关键构建块。我们提出了一种新的方法,可以利用LiDAR扫描来建立动态环境的准确地图。为此,我们建议将4D场景编码为新的时空隐式神经图表示,通过将时间依赖性的截断符号距离函数拟合到每个点。使用我们的代表,我们通过填充动态零件来提取静态图。我们的神经表示基于稀疏特征网格,一种全球共享的解码器和时间依赖性的BAIS函数,我们以无监督的方式共同优化。要从一系列li-dar扫描学习此表示形式,我们设计了一个简单而有效的损耗函数,以分段方式监督地图优化。我们在包含静态图的重建质量和动态点云的分割的各种场景上评估了我们的方法1。实验结果表明,我们的方法是删除输入点云的动态部分的过程,同时重建准确而完整的3D地图,以超出几种最新方法。

糖:机器人技术的预训练3D视觉表示
从网络数据中学习可概括的视觉表示已为机器人技术带来了令人鼓舞的结果。然而,预循环方法着眼于预训练2D表示,是应对闭塞的优势,并在复杂的3D场景中准确地将对象定位。同时,3D代表学习仅限于单对象。为了解决这些局限性,我们引入了一个名为Sugar的机器人技术的新型3D预训练框架,该框架通过3D点云捕获对象的语义,几何和负担性能。我们强调了3D表示学习中混乱场景的重要性,并自动构建一个受益于模拟中无需成本监督的多对象数据集。Sugar采用一种多功能变压器的模型来共同解决五个预训练任务,即用于语义学习的跨模式知识蒸馏,以掩盖点建模,以取消几何结构,掌握姿势合成以进行对象负担,3D实例分割和引用表达地面以分析杂乱无章的场景。我们对三个与机器人相关的任务进行了学习的代表,即零射击3D对象识别,引用凸起的接地和语言驱动的机器人操作。实验结果表明,糖的3D表示优于最先进的2D和3D表示。
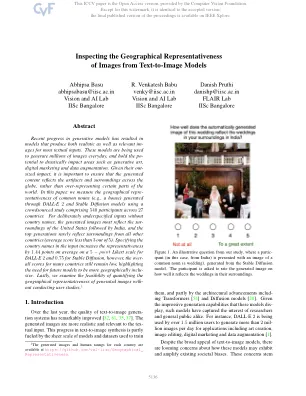
从文本到图像模型中检查图像的地理代表性
生成模型的最新进展导致了模型,这些模型既可以为大多数文本输入产生现实和相关的信息。这些模型每天都用于生成数百万张图像,并具有巨大影响诸如生成艺术,数字营销和数据增强等领域。鉴于它们的影响力,重要的是要确保生成的内容反映全球的伪影和周围环境,而不是过分代表世界的某些地区。在本文中,我们使用众包研究的研究衡量了通过dall·e 2产生的普通名词(例如房屋)的地理代表,以及稳定的扩散模型,其中包括27个国家 /地区的540名参与者。为了有意地指定没有国家名称的意见,生成的图像最反映了美国之后是印度的周围,而顶级世代很少反映出所有其他国家的周围环境(平均得分少于5分中的3个)。在输入中指定国家名称的代表性增加了1。平均在5-点李克特(Dall)的李子量表上为44点。75对于稳定的扩散,许多国家的超高分数仍然很低,这突出了将来模型在地理上更具包含的需求。最后,我们研究了量化使用用户研究的产生图像的地理代表性的可行性。1

recore:正式化对比度表示世界模型
虽然最近的无模型增强学习(RL)方法已经证明了人类水平在游戏环境中的有效性,但它们在视觉导航等日常任务中的成功受到了限制,尤其是在很明显的外观变化下。此限制来自(i)样本效率不佳和(ii)对培训方案的过度效果。为了应对这些挑战,我们提出了一种世界模型,该模型使用(i)对比不受监督的学习和(ii)干预不变的统治者学习不变特征。学习世界动态的明确表示世界模型,提高样本效率,而对比度学习隐含地实施不变特征的学习,从而改善了概括。,随着对比的损失与世界模式的na'整合还不够好,因为基于世界模型的RL方法独立地优化表示表示和代理策略。为了克服这个问题,我们提出了一种干预 - 不变的正规剂,其形式是辅助任务,例如深度预测,图像DeNoising,图像分割等,以明确执行不变性以进行样式的干预。我们的方法优于当前基于最新的模型和不含模型的RL方法,并显着改善了IGIBSON基准测试中评估的分数范围内导航任务。仅使用视觉观察,我们进一步证明了我们的方法超过了最近的语言引导导航基础模型,这对于在计算功能有限的机器人上部署至关重要。最后,我们证明了我们提出的模型在吉布森基准上其感知模块的SIM到真实传输方面表现出色。
解释基于深度学习的静息状态功能连接数据表示:重点解释自闭症中的非线性模式
背景:静息态功能性磁共振成像 fMRI (rs- fMRI) 已广泛用于研究精神疾病的大脑功能,从而深入了解大脑组织。然而,rs-fMRI 数据的高维性给数据分析带来了重大挑战。变分自动编码器 (VAE) 是一种神经网络,在提取静息态功能连接 (rsFC) 模式的低维潜在表示方面发挥了重要作用,从而解决了 rs-fMRI 数据的复杂非线性结构。尽管取得了这些进展,但解释这些潜在表示仍然是一个挑战。本文旨在通过开发可解释的 VAE 模型并使用 rs-fMRI 数据在自闭症谱系障碍 (ASD) 中测试其效用来解决这一差距。


通过增强学习
学习表征捕获对世界的非常基本的理解是机器学习的关键挑战。隐藏在数据中的解释因素的层次结构是如此一般的表示,并且可以通过分层VAE实现。然而,培训层次的VAE总是遭受“后塌陷”的苦难,其中数据信息很难传播到更高级别的潜在变量,因此导致层次结构不良。为了解决这个问题,我们首先是从信息理论的角度来减轻后层崩溃的现有方法的缺点,然后突出了正规化的必要性,即在维持不同级别之间的依赖性的同时,将数据信息明确传播到高级潜在变量。这自然会导致提出高级潜在表示作为顺序决策过程的推断,这可能受益于应用强化学习(RL)。将RL的目标与正规化的目标保持一致,我们首先引入了一条跳过的途径,以获取奖励,以评估潜在的潜在表示的信息内容,然后基于它的Q-VALUE函数可能具有正规化的一致优化方向。最后,策略梯度是典型的RL方法之一,用于训练层次VAE,而无需引入梯度估计器。1。简介实验结果坚定地支持我们的分析,并证明我们提出的方法有效地减轻了后塌陷问题,学习了信息的层次结构,获得了可解释的潜在表示,并且在下游任务中明显优于其他基于层次的VAE方法。

第 7 课:数据表示和存储
文件格式对于数据兼容性和质量至关重要,因为它们决定了数据在文件中的编码、压缩和结构。选择合适的文件格式可确保与不同的软件应用程序、操作系统和设备兼容,让用户无缝共享、分发和访问数字内容。此外,文件格式会影响内容的质量和保真度,影响图像分辨率、音频清晰度和视频播放流畅度等因素。了解常见的数字文件格式及其特性有助于用户在创建、共享和使用数字内容时做出明智的决定。
