
XiaoMi-AI文件搜索系统
World File Search System编码
ard-vae:一种统计公式,以找到变异自动编码器的相关潜在维度
变异自动编码器(VAE)[19,41]是一个人口,深,潜伏的模型(DLVM),这是由于其简单而有效的数据用于建模数据分布。优化VAE目标函数比其他DLVM更易于管理。VAE的瓶颈维度是一个至关重要的设计选择,并且对模型的性能具有很强的冲突,例如使用VAE学到的代表来找到数据集的隐藏解释因素。但是,VAE的潜在维度的大小通常被视为通过反复试验和误差经验估计的高参数。为此,我们提出了一个统计公式,以发现建模数据集所需的潜在因素。在这项工作中,我们在潜在空间中使用层次先验,使用编码数据估算潜在轴的方差,该数据标识了相关的潜在维度。为此,我们用层次的先验代替了VAE客观功能中的固定先验,使剩余的配方保持不变。我们将所提出的方法称为变异自动编码器(ARD-VAE)1中的自动相关性检测。我们证明了ARD-VAE在多个基准数据集中找到相关的LATENT尺寸及其对不同评估的效果(例如FID得分和分离分析分析)的疗效。

不使用电脑学习编码似乎是不可能的,但这非常有意义,特别是对于家里没有电脑的孩子来说
我们为孩子们创建了 7 项免费编码活动,您可以将其添加到您的家庭学校课程中,以教授编码的基本原理。它包括有趣、儿童友好的最爱,如编码单词搜索和编码填字游戏。您还可以使用我们的可打印工作表向孩子们教授算法、ASCII 代码和冒泡排序。为您的学生打下元认知、解决问题和抽象思维的基础。

可扩展的高斯流程变量自动编码器
稀疏的高斯过程。在稀疏的高斯过程近似过程中已经进行了一系列工作,可以追溯到Snelson和Ghahramani(2006),Qui〜nonero-Candela和Rasmussen(2005)等。这些稀疏方法中的大多数都依赖于一个汇总的一组,称为诱导点,主要是选择这些点的确切方式。在Titsias(2009)中首先考虑了诱导点的变异学习,并被证明会导致显着的性能提高。而不是在非变化稀疏模型中使用近似边缘的GP可能性,而是在确切的GP边际可能性上的下限被得出并用作训练目标。与我们工作相关的另一种方法是Hensman等人的随机变异方法。(2013),作者提出了一个稀疏模型,除了降低GP复杂性外,还可以在小型批次中训练,从而使(极其)大型数据集使用GP模型。
靶向免疫原性死亡 - 相关的非编码RNA
癌症免疫疗法已通过刺激宿主免疫系统识别和攻击癌细胞来治疗多种恶性肿瘤。免疫原性细胞死亡(ICD)可以扩增抗肿瘤免疫反应并逆转免疫抑制性肿瘤微环境,从而提高癌症免疫疗法的敏感性。近年来,非编码RNA(NCRNA)已成为ICD和肿瘤免疫的关键调节因素。因此,与ICD相关的NCRNA有望成为优化癌症免疫疗法有效性的新型治疗靶标。然而,尚未全面总结与ICD相关的NCRNA的免疫调节特性。因此,我们总结了有关ICD涉及的NCRNA的当前知识及其在癌症免疫疗法中的潜在作用。它加深了我们对与ICD相关的NCRNA的理解,并通过特定针对ICD相关的NCRNA提供了一种新的策略来增强癌症免疫疗法。

AI 编码助手
近年来,生成式人工智能 (AI) 引起了媒体和社会的广泛关注。这些是根据输入创建文本、图像或视频等内容的 AI 模型。受文本生成领域巨大进步的推动,最近开发了大量基于大型语言模型 (LLM) 的 AI 编码助手,用于源代码生成的(部分)自动化。这些模型根据方法的不同,要么在大量文本上进行训练,然后使用源代码进行微调,要么直接在大量源代码上进行训练。在应用中,这些模型的使用方式类似于聊天机器人。用户给模型一个提示,可以是所需功能的描述,也可以是(带注释的)源代码框架。输出是用户选择的编程语言中具有所需功能的源代码。当前一代模型除了生成最佳建议外,还会生成多个替代方案 - 这是模型认为最有可能正确的建议。用户可以选择其中一个建议并将其采纳到他们当前的软件项目中。这些 AI 编码助手通常通过集成开发环境 (IDE) 的插件访问。此外,开发人员还会使用托管在云端或本地的通用聊天机器人进行编程。

使用植物衍生的外泌体样纳米颗粒作为基于CRIS/ CAS9的疗法的输送系统,用于编辑癌症中长的非编码RNA div>
结肠癌是美国癌症的主要原因之一。结肠癌是由结肠癌细胞基因组中的许多基因突变发展而来的。长的非编码RNA(LNCRNA)会导致许多癌症(包括结肠癌)的发育和进展。lncRNA已经并且可以通过簇状的定期间隔短的短质体重复序列(CRISPR)相关的核酸酶9(CRISPR/CAS9)系统的聚类重复序列的基因编辑技术来纠正,以减少结肠癌细胞的增殖。但是,许多用于运输基于CRISPR/CAS9的疗法的当前输送系统需要更多的安全性和效率。基于CRISPR/CAS9的治疗药需要安全有效的递送系统,以更直接,更明确地靶向结肠中存在的癌细胞。本综述将提供有关使用植物衍生的外泌体样纳米颗粒作为纳米载体的效率和安全性的相关证据,以提供基于CRISPR/CAS9的疗法以直接靶向结肠癌细胞。

信息、编码和生物功能
摘要 20 世纪中叶,两门新的科学学科强势崛起:分子生物学和信息通信理论。起初,两者的相互影响十分深刻,以至于遗传密码这一术语被普遍接受用来描述 mRNA 三联体(密码子)作为氨基酸的含义。然而,如今,这种协同作用并未充分利用这两门学科的飞速发展,而是带来了更多的挑战而不是答案。这些挑战不仅具有重大的理论意义,而且代表了下一代生物学不可避免的里程碑:从个性化基因治疗和诊断到人工生命,再到生物活性蛋白质的生产。此外,这一问题与理论生物学所需的范式转变密切相关,这种转变早已开创,需要生物学领域以外的学科共同做出贡献。信息作为概念隐喻的使用需要转化为定量和预测模型,这些模型可以通过经验检验并以统一的视角进行整合。要成功完成这些任务,需要采取广泛的多学科方法,包括人工生命研究人员来解决这一问题。

实习:建造3D网状自动编码器-AFIG
实习的主要目标是对网格代表领域内的当前文献进行彻底审查。随后,目的是设计和实现3D网格自动编码器,以便能够准确捕获对象的形状并有效地将它们压缩到潜在表示中。利用潜在空间已被证明在生成模型中非常有效,如文本对图像模型中所示[6,7]。该自动编码器的潜在应用是多种多样的。主要是,它有可能通过促进潜在空间内的直接操作来大大减轻模型的计算负担。这不仅解锁了在网格序列上无缝工作的运动模型的可能性,而且还使模型的扩展能够处理多个字符,从而结合了它们之间的相互作用。其次,潜在空间可用于生成模型中,从而促进了从文本/图像/视频到姿势/运动的翻译。
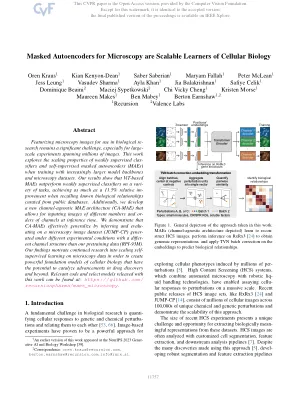
显微镜的掩盖自动编码器是细胞生物学的可扩展学习者
为生物搜索中使用的显微镜图像仍然是一个重要的挑战,尤其是对于跨越数百万图像的大规模实验。这项工作探讨了经过越来越较大的模型骨架和显微镜数据集训练时,弱监督的clasifirers和自我监管的蒙版自动编码器(MAE)的缩放属性。我们的结果表明,基于VIT的MAE在一系列任务上的表现优于弱监督的分类器,在召回从公共数据库中策划的已知生物学关系时,相对实现的相对效果高达11.5%。此外,我们开发了一种新的通道敏捷的MAE架构(CA-MAE),该体系结构允许在推理时输入不同数字和通道的图像。我们证明,在不同的实验条件下,在不同的实验条件下,CA-MAE通过推断和评估在显微镜图像数据集(Jump-CP)上有效地概括了,与我们的训练数据(RPI-93M)相比,通道结构不同。我们的发现促使人们继续研究对显微镜数据进行自我监督学习,以创建强大的细胞生物学基础模型,这些模型有可能促进药物发现及其他方面的进步。与此工作发布的相关代码和选择模型可以在以下网址找到:https://github.com/ recursionpharma/maes_microscopy。

Deep Video Compression的任务意识编码器控制
对机器任务的深视频压缩(DVC)的事先研究通常需要为每个特定任务培训一个独特的编解码器,从而规定每个任务的专用解码器。相比之下,传统视频编解码器采用了flex ible编码器控制器,从而通过模式预测等机制使Single编解码器适应了不同的任务。从中汲取灵感,我们引入了一个创新的编码器控制器,以用于机器的深度视频压缩。此控制器具有模式预测和一组图片(GOP)选择模块。我们的AP-ARACH在编码阶段集中控制控制,从而允许跨不同任务(例如检测和跟踪)进行适应性的编码器调整,同时与标准的预训练的DVC解码器保持合理性。示例证明我们的方法是在具有各种现有预训练的DVC的多个任务中适用的。此外,广泛的实验表明,对于不同的任务,我们的方法比以前的DVC比以前的DVC大约25%,只有一个预先训练的解码器。