
XiaoMi-AI文件搜索系统
World File Search System扩散模型

使用扩散模型在潜在空间中进行图像修复
使用扩散模型进行图像修复通常使用预条件模型(即针对绘画任务进行微调的图像条件模型)或后条件模型(即在推理时重新用于绘画任务的非条件模型)。预条件模型在推理时很快,但训练成本极高。后条件模型不需要任何训练,但在推理过程中很慢,需要多次前向和后向传递才能收敛到理想的解决方案。在这里,我们推导出一种不需要昂贵训练但推理速度很快的方法。为了解决昂贵的推理计算时间,我们在潜在空间而不是图像空间上执行前向-后向融合步骤。这是通过扩散过程中新提出的传播模块解决的。在多个领域进行的实验表明,我们的方法达到或改善了状态

细浓度:通过扩散模型进行细粒度及时驱动的3D人姿势估计
3D人姿势估计(3D HPE)任务使用2D图像或视频来预测3D空间中的人类关节坐标。尽管最新的基于深度学习的方法取得了进步,但它们主要忽略了可访问的文本和自然可行的人类知识的能力,而错过了有价值的隐性监督,以指导3D HPE任务。此外,以前的努力经常从整个人体的角度研究这项任务,从而忽略了隐藏在不同身体部位的细粒度指导。为此,我们基于3D HPE的扩散模型(名为FinePose)提出了一个新的细粒及时驱动的DeNoiser。它由三个核心块组成,增强了扩散模型的反向过程:(1)通过耦合辅助辅助文本和可学习的提示以模拟隐式指南的耦合知识,并通过耦合的辅助辅助文本和自然可行的零件知识,可以通过耦合的辅助辅助文本和自然可行的零件知识来构建精细的部分零件感知的提示。(2)Fine-
弥合扩散模型之间的差距和图像压缩的通用量化
通过利用量化误差和加性噪声之间的相似性,可以通过使用扩散模型“ denoise”量化引入的伪影来构建基于扩散的图像压缩编解码器。但是,我们确定了这种方法中的三个差距,从而导致量化的数据排除在扩散模型的分布之外:噪声水平,噪声类型和由离散化引起的差距的差距。为了解决这些问题,我们提出了一个新型的基于量化的正向扩散过程,该过程是理论上建立的,并桥接了上述三个差距。这是通过经过精心量身定制的量化时间表以及对均匀噪声训练的扩散模型来实现的。与以前的工作相比,我们提出的架构也会产生一贯的现实和详细的结果,即使是在极低的比特率下,同时保持对原始图像的忠诚度。

使用预先训练的垂直二维扩散模型改善三维成像
扩散模型由于其众多优点已成为一种流行的图像生成和重建方法。然而,大多数基于扩散的逆问题解决方法仅处理二维图像,即使是最近发表的三维方法也没有充分利用三维分布先验。为了解决这个问题,我们提出了一种新方法,使用两个垂直的预训练二维扩散模型来解决三维逆问题。通过将三维数据分布建模为不同方向切片的二维分布的乘积,我们的方法有效地解决了维数灾难。我们的实验结果表明,我们的方法对于三维医学图像重建任务非常有效,包括 MRI Z 轴超分辨率、压缩感知 MRI 和稀疏视图 CT。我们的方法可以生成适合医疗应用的高质量体素体积。代码可在 https://github.com/hyn2028/tpdm 获得

布局 - 敏捷场景文本图像综合与扩散模型
虽然扩散模型已显着提高了图像生成的质量,但它们在这些图像中准确且相干渲染文本的能力仍然是一个重大挑战。场景文本生成的常规基于扩散的方法通常受到对中间布局输出的依赖的限制。这种依赖性通常会导致文本样式和字体的多样性限制,这是布局生成阶段的确定性质所引起的固有限制。为了应对这些挑战,本文介绍了SceneTeTgen,这是一种基于新颖的扩散模型,专门设计用于规避预定义布局阶段的需求。这样做,场景 - 文本促进了文本的更自然和多样化的代表。SceneTextGen的新颖性在于其三个关键组成部分的整体:一个字符级编码器,用于捕获详细的印刷属性,并与字符级实例分割模型和Word-
提示文本到图像扩散模型的迅速反转
提供给文本对图像差异模型的提示的质量决定了生成的内容对用户意图的忠诚程度,通常需要“及时工程”。要通过及时的工程来利用目标图像的视觉概念,当前方法在很大程度上通过优化然后将它们映射到伪tokens来依赖嵌入反演。然而,使用这种高维矢量表示是具有挑战性的,因为它们缺乏语义和可解释性,并且只允许使用它们时模拟矢量操作。相反,这项工作着重于反转扩散模型,以直接获得可靠的语言提示。这样做的挑战在于,由此产生的优化问题从根本上是离散的,提示的空间呈较大。这使得使用标准优化技术,例如随机梯度下降,困难。为此,我们利用延迟的投影方案来访问代表模型中词汇空间的提示。此外,我们利用了扩散过程的时间段与图像中不同级别的细节相差的发现。后来的,嘈杂的,前传扩散过程的时间段对应于语义信息,因此,此范围内的迅速反转提供了代表图像语义的令牌。我们表明,我们的方法可以确定目标图像的语义可解释和有意义的提示,该提示可用于合成具有相似内容的多样化图像。我们说明了优化提示在进化图像生成和概念删除中的应用。
将扩散模型缩放到现实世界3D激光雷达场景完成
计算机视觉技术在自动驾驶汽车的感知堆栈中起着核心作用。使用此类方法来感知给定数据的车辆周围环境。3D激光雷达传感器通常用于从场景中收集稀疏的3D点云。然而,根据人类的看法,这种系统努力鉴于那些稀疏的点云,因此很难塑造现场的看不见的部分。在此问题中,场景完成任务旨在预测LiDAR测量中的差距,以实现更完整的场景表示。鉴于最近扩散模型作为图像的生成模型的有希望的结果,我们建议将其扩展以实现单个3D LIDAR扫描的场景。以前的作品使用了从LiDAR数据提取的范围图像上使用扩散模型,直接应用了基于图像的扩散方法。差不多,我们建议直接在这些点上操作,并介绍尖锐的和降解的扩散过程,以便它可以在场景规模上有效地工作。与我们的方法一起,我们提出了正规化损失,以稳定在denoising过程中预测的噪声。我们的实验评估表明,我们的方法可以在单个LIDAR扫描中完成场景,作为输入,与最新场景完成方法相比,产生了更多详细信息的场景。我们认为,我们提出的扩散过程公式可以支持应用于场景尺度点云数据的扩散模型中的进一步研究。1

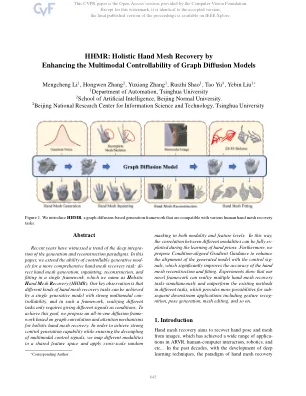
HHMR:通过增强图扩散模型的多模式可控性
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机