
XiaoMi-AI文件搜索系统
World File Search SystemChatbot

流程建模者与聊天机器人:生成AI是否接管过程建模?
摘要。大语言模型(LLMS)已成为自动化复杂任务的有前途的工具,例如从文本中生成过程模型。为了评估LLM在生成过程模型中的功能,提供评估产出质量的手段至关重要。一些研究已经提供了关键的绩效指标,用于评估以定量方式评估模型的完整性。在本文中,我们专注于基于用户调查的LLMS生成的生成过程模型的定性评估。通过分析用户偏好,我们旨在确定LLM生成的过程模型是否满足专家的需求和期望。我们的分析表明,有60%的用户,无论其建模经验如何,都喜欢LLM生成的模型而不是人为创建的地面真相模型。

使用Amazon的医疗保健相关提示的RAG聊天机器人...
自然语言处理(NLP)用于大语言模型(LLM)的抽象应用继续随着域生成AI(Genai)的技术进步而继续发展。数据的巨大爆炸,可扩展的计算能力和机器学习创新的可用性,LLM,都导致生成AI(Genai)变得越来越流行。基本模型LLM涉及的主要挑战是它们幻觉的趋势。LLMS中的幻觉是指不一致的不一致的输出,有时是不正确的信息或响应。这是因为大多数LLM经过大量通用数据训练,并且必须使用特定于域和外部数据来增强用于Genai任务,例如聊天机器人,问答,摘要和文本生成。为了应对幻觉的挑战,本研究将以PDF文件的形式利用特定领域的医疗保健数据以及FM来创建检索增强生成(RAG)Chatbot。本研究利用了亚马逊基岩的基础基础模型,Llama 2。我们的特定领域的医疗保健数据来自相关和可靠的来源。使用Python开发了RAG聊天机器人,并使用Rouge和Meteor,评估自动生成的文本评估指标对响应进行了评估。评估是基于三种情况:响应小于250个字符,超过250个字符以及来自多个LLM的响应。关键字 - LLM,亚马逊基岩,Genai,基础模型,Llama2,幻觉。我们的发现提供了有力的证据,表明具有特定数据的基础模型(FMS)可以提高模型在为患者提供可靠的医学知识时的质量。

Digi-nose第2部分:使用传感器技术提高数字鼻系统的准确性和效率,以尽早发现森林变化
最近,BPM社区已开始尝试LLMS以提取过程信息并从自然文本中生成工艺模型,并采用[1,2,2,3,4,5]等方法。这些作品表明了该任务的LLMS有希望的功能。在宣传[6,7]中,文献中也有一个在线工具1。该工具不仅允许初始生成文本的过程模型。它还提供了用于完善生成模型的反馈循环。促销表示该任务的LLMS具有很高的潜力。但是,应用的提示策略和中间格式的使用费显着高。首次尝试该工具时,我们生成了一个三步过程,并具有两个反馈循环的迭代。使用GPT-4的OpenAI API费用为0.8美元。虽然当前的GPT-4O模型更具成本效益,但我们认为应该优化此类系统以有效地使用LLM资源来降低成本,同时保持高质量的输出。我们建议,优化的系统可以使过程建模可能民主化,或者至少使更广泛的受众访问过程建模。因此,我们已经在[8]中开发了自己的方法,该方法着重于所需的令牌数量的建模成本。
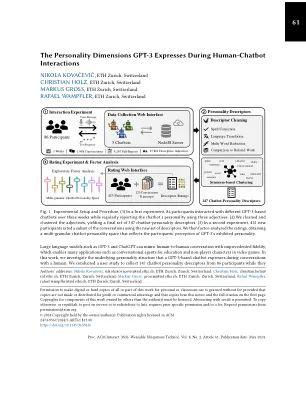
人格维度GPT-3在人类肉体相互作用期间表达
1简介大型生成语言模型(LLM)的最新出现,例如GPT-3 [16]及其继任者Chatgpt [96]和GPT-4 [83],彻底改变了自然语言处理和人工智能领域。由于他们具有前所未有的精度处理自然语言的能力,这些模型在各种环境中开放了新的应用程序和用例[26,35,96]。具体来说,它们产生的文本通常与人类生成的文本无法区分的能力使它们可以用作对话剂[57,62,86,108],从而增加了可信性[70,106],浸入性[52]和互动的个性化[58]。在游戏[2,5]中成功地改编了这种对话代理为非玩家字符(NPC),并对教学应用显示了巨大的希望[1]。然而,考虑到有关一致性和用户影响的问题仍未解决,必须对这种技术进行集成[27、55、57、74]。诸如安全和内容控制问题之类的新挑战阻碍了该技术进入高风险应用程序,例如教育和心理保健服务,那里没有任何不一致或适得其反的毒剂行为的空间[9,82]。因此,必须研究人类如何与基于LLM的对话剂相互作用,并了解在这种相互作用情况下出现的风险和挑战。人类肉体相互作用的一个重要方面是对转化药物的人格的设计和控制[32,33,109]。传达对话剂中的个性使交互作用引人入胜且令人信服,使用户拟人化代理[40,66],增强用户参与度[88]和用户体验[91],并通过高度个性化[98]来增加用户对代理的接受。然而,关于语音服务助理(例如Siri和Alexa)所表现出的人格的最新发现[103]表明,建立完善的人格模型(例如五因子模型[25,69])与用户与此类助手相互作用时所感知的人格之间存在结构差异。这导致了一个问题,即最近基于LLM的对话代理人表现出的人格尺寸在多大程度上与人格模型一致,以及这些维度是否与先前工作中得出的维度一致。研究这种结构差异是必须将代理人个性的设计与用户的感知和期望保持一致[103,104],从而使基于LLM的对话代理在人格维度方面实现系统的设计,评估和比较。在这项工作中,我们研究了在人类聊天对话期间由基于GPT-3的聊天机器人表达的潜在人格结构,并将结果与Völkel等人的演员人格模型进行了比较。[103]和人格的五因素模型[25,69]。在我们的研究中(见图1),有86名参与者在与聊天机器人交谈的同时定期将基于GPT-3的聊天机器人的个性描述。我们通过执行包括拼写的多个处理步骤

教育系统中基于人工智能的聊天机器人的灾难性风险
基于人工智能的聊天机器人将被广泛的人群使用,包括学生、教师和家长,用于各种目的,其对提高教师和学生生产力的影响是不可否认的。这些系统将为不同教育水平的所有学生带来个性化学习。然而,似乎在不解决基于人工智能的系统固有挑战的情况下快速部署可能会导致由于这些系统的快速崛起而未在文献中报道的若干风险。本文探讨了在教育环境中使用基于人工智能的聊天机器人所带来的潜在灾难性风险,整合了最近研究的见解,特别关注隐私、安全、道德困境和技术依赖性。认识到新出现的挑战,我提出了一种新颖的解决方案,利用区块链技术来增强教育环境中基于人工智能的聊天机器人的安全性、透明度和完整性。提供了减轻这些风险的建议,强调教育机构的独特背景以及需要创新方法来保护学生数据并保持教育质量。

戒烟聊天机器人的有效性和用户经验:混合方法研究比较动机访谈和对抗性咨询
背景:吸烟构成主要的公共卫生风险。聊天机器人可以作为一种可访问且有用的工具来促进停止,因为它们的高可访问性和促进长期个性化互动的潜力。为了提高有效性和可接受性,仍然需要识别和评估这些聊天机器人的咨询策略,这一方面在先前的研究中尚未全面解决。目的:本研究旨在确定此类聊天机器人支持戒烟的有效咨询策略。此外,我们试图深入了解吸烟者对聊天机器人的期望和经验。方法:这项混合方法研究结合了基于网络的实验和半结构化访谈。吸烟者(n = 229)与动机访谈(MI) - 式(n = 112,48.9%)或对抗性咨询 - 风格(n = 117,51.1%)聊天机器人相互作用。评估了与戒烟相关的(即退出和自我效能的意图)和与用户经验相关的结果(即,参与,敬业,治疗联盟,感知的移情和互动满意度)。对16名参与者进行了半结构化访谈,每个条件的8个(50%),并使用主题分析分析了数据。结果:多元ANOVA的结果表明,参与者的MI(VS对抗咨询)聊天机器人的总体评级明显更高。后续判别分析表明,对MI Chatbot的更好看法主要是用用户体验与相关的结果来解释的,与戒烟相关的结果扮演了较少的角色。探索性分析表明,在这两种情况下吸烟者都报告说,聊天机器人相互作用后戒烟和自我效能的意图增加。访谈结果说明了几种构造(例如情感态度和参与),解释了人们以前的期望以及聊天机器人的及时和回顾性经验。结论:结果证实聊天机器人是激励戒烟的有前途的工具,使用MI可以改善用户体验。我们没有为MI提供额外的支持来激励停止并讨论了可能的原因。吸烟者在退出过程中表达了关系和工具需求。讨论了对未来研究和实践的影响。

医学教育中的人工智能聊天机器人
近年来,教育中技术的整合改变了学生学习和与教育内容互动的方式。该领域的一个特定创新是人工智能聊天机器人的实施,这源于深度学习,自然语言处理,变形金刚和大语言模型(LLMS)的进步。这些聊天机器人旨在模仿用户输入潜在复杂请求的交互式对话,并且聊天机器人提供了类似人类的响应。1自成立以来,这些聊天机器人已用于各种应用程序,包括回答问题,生成解释和摘要,在语言之间翻译以及执行其他自然语言任务。这些应用已导致LLMS整合到咨询,IT和教育等行业中。2

人工智能聊天机器人:威胁还是机遇? - 利兹贝克特资料库
2022 年 11 月,OpenAI 推出了 ChatGPT,这是一款人工智能聊天机器人,截至 2023 年 2 月,用户数量已超过 1 亿。基于大型语言模型和机器学习的人工智能聊天机器人有可能彻底改变我们与计算机和数字系统的交互方式。这些发展的支持者声称,这些应用可以而且将为每个人带来巨大的好处。许多其他人,包括那些处于技术前沿的人,则持更加怀疑的态度,一些人现在声称,目前形式的人工智能是有毒和危险的,可能对人类构成威胁。尽管后一种担忧似乎牵强附会和不合时宜,但这些最新发展的后果是严重的,需要广泛的分析、关注和采取行动,才能避免虚假信息呈指数级增长,从而导致人们对这些技术产生严重且不可挽回的不信任。
开发一种生成AI驱动的聊天机器人用于分析Maude数据库
摘要。本文提供了一个聊天机器人,简化了与Maude数据库中与医疗设备相关的不良事件的开放记录。聊天机器人由生成AI技术提供动力,启用计数和搜索查询。聊天机器人使用OpenFDA API和GPT-4模型来解释用户的自然语言查询,生成适当的API调用并汇总不良事件报告。聊天机器人还提供了一个可下载的链接指向原始报告。该模型在生成准确的API调用方面的性能通过训练并改进了几乎没有查询 - url对的示例。此外,通过人类专家评级评估了基于内容的摘要的质量。这项倡议是使患者安全数据可访问,可复制且易于管理的重要一步。

自动化客户支持:关于机器学习驱动聊天机器人和虚拟助手的功效的研究
摘要 - 本研究研究了机器学习驱动的聊天机器人和虚拟助手在自动化客户支持方面的功效。随着对企业提供快速,高效且可扩展的客户服务的需求日益增长,因此必须采用机器学习(ML)等高级技术。本研究探讨了如何利用这些技术来增强客户支持操作,并将其绩效与传统支持方法进行比较。这项研究的主要目标是评估ML驱动的聊天机器人和虚拟助手在客户支持角色中的表现,将这些高级技术与传统客户支持方法的疗效进行比较,并在与ML驱动的系统互动时评估客户满意度和响应效率,并确定使用机器学习中使用机器学习的收益和限制。本研究采用了混合方法研究设计,结合了定性和定量方法来收集全面数据。该方法包括通过调查和与客户的访谈收集数据,并支持员工,以收集有关用户体验和满意度水平的定性数据。还分析了来自客户支持交互的历史数据。实施了各种ML模型,包括自然语言处理(NLP)和深度学习算法,以实现为聊天机器人和虚拟助手。这些模型在广泛的客户查询和响应数据集中进行了培训。统计和分析技术,包括回归分析和假设检验,用于解释收集的数据。使用响应时间,准确性和用户满意度得分等指标评估了由ML驱动的聊天机器人和虚拟助手的性能。该研究的主要发现表明,ML驱动的聊天机器人和虚拟助手