
XiaoMi-AI文件搜索系统
World File Search SystemDataset
egoexolearn:用于桥接异步自我
抽象能够将他人的活动映射到自己的观点中,即使从很小的时候就开始是一种基本的人类技能。迈向理解这种人类能力的一步,我们介绍了EgoExolearn,这是一个大规模的数据集,该数据集在过程之后模仿人类的演示,在该过程中,个人在执行以exentric-exentric-view示范视频为指导的任务时记录了以自我为中心的视频。关注日常援助和专业支持中的潜在应用,Egoexolearn Conconconconconconconconconconcons conconce concection和示范视频数据涵盖了在日常生活场景和专业实验室中捕获的120小时的120小时。与视频一起,我们记录了高质量的凝视数据并提供了详细的多模式注释,并构建了一个游乐场,用于建模人类从不同观点桥接异步程序动作的能力。为此,我们提出了基准,例如跨视图协会,跨视图行动计划和跨视图所引用的技能评估以及详细的分析。我们期望EgoExolearn可以作为跨越观点弥合行动的重要资源,从而为创建能够通过在现实世界中观察人类进行缝隙学习的AI代理铺平了道路。数据集和基准代码可在https://github.com/opengvlab/egoeexolearn上找到。

随意对话:用于衡量公平性的数据集......
本文介绍了一种新颖的“公平性”数据集,以衡量 AI 模型对不同年龄、性别、表观肤色和环境光照条件的稳健性。我们的数据集由 3,011 名受试者组成,包含 45,000 多个视频,平均每人 15 个视频。这些视频是在美国多个州录制的,参与者是不同年龄、性别和表观肤色组的成年人。一个关键特征是每个受试者都同意参与并使用他们的肖像。此外,我们的年龄和性别注释由受试者自己提供。一组训练有素的注释者使用 Fitzpatrick 皮肤类型量表标记受试者的表观肤色 [ 6 ]。此外,还提供了在低环境光下录制的视频的注释。作为衡量跨某些属性的预测稳健性的应用,我们评估了最先进的表观年龄和性别分类方法。我们的实验从公平对待来自不同背景的人的角度对这些模型进行了彻底的分析。
Interead:中断阅读的眼睛跟踪数据集
阅读过程中抽象的眼动动作提供了一个了解认知过程和语言理解的窗口,但是缺少中断数据的稀缺性 - 学习者在日常学习环境中经常遇到这些数据 - 妨碍了智能学习技术发展的进步。我们介绍了Interead - 一种新颖的50个参与者数据集的目光数据集,该数据集在对现实世界文本的自定进度读取过程中记录。Interead进一步提供了整个文本中散布的中断的细粒度注释以及这些中断产生的恢复滞后。中断。我们通过报告有关凝视行为的不同度量的跨学科分析来验证我们的数据集。与先前的研究一致,我们的分析表明,中断以及单词长度和单词频率效应会显着影响阅读过程中的眼睛运动。我们还探索了数据集中的个体差异,从而阐明了量身定制的教育解决方案的潜力。可以从我们的数据集访问网页:https://www.ife.uni-stuttgart.de/en/llis/research/datasets/。
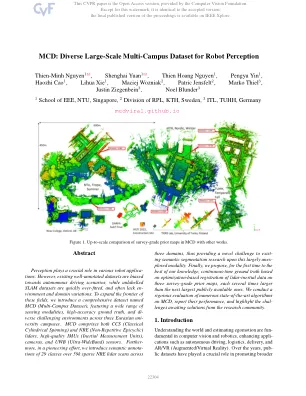
MCD:机器人感知的多种大型多校区数据集
感知在各种机器人应用中起着至关重要的作用。但是,现有的良好的数据集偏向自动驾驶场景,而未标记的SLAM数据集则很快过于拟合,并且通常缺乏环境和域变化。为了扩大这些领域的边界,我们介绍了一个名为MCD(Multi-campus数据集)的全面数据集,其中包含各种感应方式,高准确的地面真相以及在三个欧亚大学的欧亚大学校园内的挑战性环境。MCD包括CCS(经典的圆柱旋转)和NRE(非重复性环球)LIDAR,高质量的IMU(惯性测量单元),相机和UWB(URWB(Ultra-Wideband))传感器。更重要的是,在开创性的努力中,我们引入了29堂课的语义注释,超过59k稀疏的nre lidar扫描

●我们的结果表明IPS是可推广的多...
图3。km存活曲线(顶部面板)和多元Coxph森林图(底部面板)说明了POL/POLD 1的左侧的RWPF(左侧RWPF,右侧RWOS)的结果(RWOS),用免疫疗法(IO)治疗的患者(IO)以及与化学疗法和IO + IO + IO + IO + IO + IO + IO(IO)组合的结局(左侧),并与IO + IO + IO(IO)组合进行了突变(基因(其他)。在KM图中指定了随着时间的流逝的中位生存时间和处于危险中的患者人数。森林图具有多元COXPH模型的危险比(HR),所有协变量(POL/POLD1突变,TMB,MSI状态和指示)的置信间隔为95%,表明相对的进展或死亡风险。

发现地理卫星:从数据集到Kelvins Spotgeo挑战
地球同步赤道轨道(GEO)是许多重要空间资产的所在地,例如远程通讯和导航卫星。GEO中监视居民空间对象(RSO)是实现空间情境意识(SSA)和保护批判空间资产的关键方面。然而,由于目标的极端距离以及包括云的缘故,大气/天气效应,光污染,传感器噪声/缺陷和恒星闭合,因此基于地面的地理对象进行了挑战。Kelvins Spotgeo挑战旨在确定来自低成本地面望远镜的图像在多大程度上可用于检测GEO和近Geo RSO,仅来自没有任何其他元数据的光度信号。同时,Spotgeo数据集还解决了有关卫星检测问题的计算机视觉观点中缺乏公开可用的数据集;通过组装和释放这样的数据集,我们希望在光学检测RSO上付出更多的努力,并为现有方法和将来的方法提供客观的台式标记。在这项工作中,我们介绍了Spotgeo数据集开发,Challenge设计,评估指标和结果分析的详细信息。
svgeditBench:用于定量评估LLM SVG编辑功能的基准数据集
文本到图像模型近年来已显示出进展。随着这一进展,从文本中生成向量图也已提出。svg是向量图形的流行效果,SVG代表带有XML文本的场景。因此,大型语言模型可以直接处理SVG代码。考虑到这一点,我们专注于使用LLMS编辑SVG。用于定量评估LLMS编辑SVG的能力,我们提出了SVGeditBench。svgeditBench是评估LLMS编辑SVG代码能力的基准。在提议的基准下进行评估时,我们还显示了GPT-4和GPT-3.5结果。在实验中,GPT-4在定量和质量上都显示出与GPT-3.5的优势。该数据集可在https://github.com/mti-lab/svgeditBench上找到。

synfog:基于结束的照片真实合成雾数据集...
为了推进基于学习的融化算法的研究,已经开发了各种合成雾数据集。但是,现有的数据集使用大气散射模型(ASM)或十个实时渲染引擎而努力产生光真实的雾图像,以准确模仿实际的成像过程。这种限制阻碍了模型从合成到真实数据的有效概括。在本文中,我们引入了旨在生成照片现实的雾图图像的端到端模拟管道。该管道全面构建了整个基于物理的雾化场景成像,与现实世界图像捕获的方法紧密相位。基于此管道,我们提出了一个名为Synfog的新合成雾数据集,该数据集具有天空和主动照明条件以及三个级别的雾气状态。实验结果表明,与其他人相比,在与其他模型中相比,与其他人相比,在synfog上训练的模型在视觉感知和检测准确性方面表现出了较高的性能。

一个航天器数据集用于检测,分割和零件识别
现代生活的几乎所有方面都取决于太空技术。多亏了计算机视频的一般和深度学习技术的巨大进步,几十年来,全世界都见证了将深度学习的发展用于解决太空问题的问题,例如自动驾驶机器人,诸如示踪剂,类似昆虫的机器人,类似昆虫的机器人和SpaceCraft的健康监测。这些只是一些在深度学习的帮助下具有高级空间行业的重要例子。但是,深度学习模型的成功需要大量的培训数据才能具有不错的性能,而另一方面,用于培训深度学习模型的公开空间数据集非常有限。当前没有用于基于太空的对象检测或实例分割的公共数据集,部分原因是手动注释对象分割掩码非常耗时,因为它们需要像素级标签,更不用说从空间获取图像的挑战了。在本文中,我们的目标是通过释放数据集以进行航天器检测,实例分割和零件识别来填补这一差距。这项工作的主要贡献是使用太空设置和卫星的图像开发数据集,并具有丰富的注释,包括绑定的航天器和口罩的框架盒对物体部分的水平,这些盒子是通过自动程序和手动努力的混合而获得的。我们还提供了对象检测和Intance Sementation的最新方法作为数据集的基准。可以在https://github.com/yurushia1998/satellitedataset上找到下载建议数据集的链接。
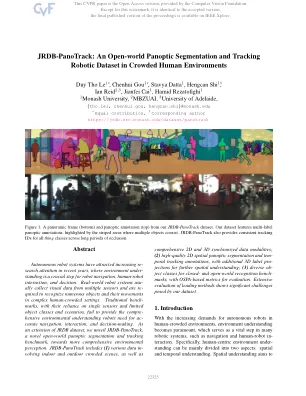
JRDB-Panotrack:一个开放世界的全景进行分割和跟踪拥挤的人类环境中的机器人数据集
自主机器人系统近年来引起了越来越多的关注,在这种环境中,环境是机器人导航,人类机器人互动和决策的关键步骤。现实世界机器人系统通常会从多个传感器中收集视觉数据,并经过重新识别以识别许多对象及其在复杂的人拥挤的设置中。传统的基准标记,依赖单个传感器和有限的对象类和场景,无法提供机器人对策划导航,互动和决策的需求的综合环境理解。作为JRDB数据集的扩展,我们揭开了一种新颖的开放世界式分割和跟踪基准,介绍了一种新型的开放世界式分割和跟踪基准。JRDB-Panotrack包括(1)各种数据室内和室外拥挤的场景,以及