
XiaoMi-AI文件搜索系统
World File Search SystemEgo

egecentric 3D手姿势估计的单一对偶视图改编
对准确的3D手姿势估计的追求是理解以自我为中心视力领域的人类活动的基石。大多数现有估计方法仍然依赖单视图像作为输入,从而导致潜在的局限性,例如,深度有限的视野和义务。解决这些问题,添加另一个相机以更好地捕获手的形状是实践方向。然而,现有的多视图手姿势姿势方法具有两个主要缺点:1)重新训练的多视图注释,这些注释是备用的。2)在测试过程中,如果相机参数/布局与训练中使用的相同,则模型将变为inpapplicable。在本文中,我们提出了一种新颖的单算观看改编(S2DHAND)解决方案,该解决方案将预先训练的单视估计器适应双视图。与现有的多视图训练方法相比,1)我们的适应过程是无监督的,消除了对多视图注释的需求。2)此外,我们的方法可以处理带有未知相机参数的Arbitarary双视图对,从而使该模型适用于不同的相机设置。具体来说,S2DHAND建立在某些立体声约束上,包括两种视图之间的成对跨视图共识和转换的不变性。这两个立体声约束以互补的方式使用来进行伪标记,从而允许可靠的适应性。评估结果表明,在内部和跨数据库设置下,S2DHAND在任意摄像机对上实现了重大的实现,并且胜过具有领先性能的现有适应方法。项目页面:https://github.com/ut-vision/s2dhand。
egoexolearn:用于桥接异步自我
抽象能够将他人的活动映射到自己的观点中,即使从很小的时候就开始是一种基本的人类技能。迈向理解这种人类能力的一步,我们介绍了EgoExolearn,这是一个大规模的数据集,该数据集在过程之后模仿人类的演示,在该过程中,个人在执行以exentric-exentric-view示范视频为指导的任务时记录了以自我为中心的视频。关注日常援助和专业支持中的潜在应用,Egoexolearn Conconconconconconconconconconcons conconce concection和示范视频数据涵盖了在日常生活场景和专业实验室中捕获的120小时的120小时。与视频一起,我们记录了高质量的凝视数据并提供了详细的多模式注释,并构建了一个游乐场,用于建模人类从不同观点桥接异步程序动作的能力。为此,我们提出了基准,例如跨视图协会,跨视图行动计划和跨视图所引用的技能评估以及详细的分析。我们期望EgoExolearn可以作为跨越观点弥合行动的重要资源,从而为创建能够通过在现实世界中观察人类进行缝隙学习的AI代理铺平了道路。数据集和基准代码可在https://github.com/opengvlab/egoeexolearn上找到。
基于以上为中心的视觉模型,基于便携式实时智能助手
图4。Egovideo-VL模型的概述。 eGovideo-VL是一种旨在实时自我中心的理解和援助的多模式视觉语言模型。 该模型包含五个关键组件:(1)遵循Egovideo [58]的设计模态编码器,并包括一个视频编码器和用于多模式特征提取的文本编码器; (2)存储模块,该模块存储历史上下文以实现时间基础,摘要和个性化互动; (3)大型语言模型(LLM),该模型执行多模式推理和响应生成; (4)生成模块,该模块综合了视觉动作预测,以指导用户完成任务; (5)检索模块,该模块检索第三人称专家演示以补充以自我为中心的理解。Egovideo-VL模型的概述。eGovideo-VL是一种旨在实时自我中心的理解和援助的多模式视觉语言模型。该模型包含五个关键组件:(1)遵循Egovideo [58]的设计模态编码器,并包括一个视频编码器和用于多模式特征提取的文本编码器; (2)存储模块,该模块存储历史上下文以实现时间基础,摘要和个性化互动; (3)大型语言模型(LLM),该模型执行多模式推理和响应生成; (4)生成模块,该模块综合了视觉动作预测,以指导用户完成任务; (5)检索模块,该模块检索第三人称专家演示以补充以自我为中心的理解。
在气候变化下的保护区域设计网络中整合功能连接:驯鹿案例研究
摘要 - 动态场景中的移动对象细分(MOS)是一个重要的,具有挑战性但探索不足的重新搜索主题,以供自动驾驶,尤其是对于从移动的自我车辆获得的序列而言。大多数分割方法利用了从光流图获得的运动提示。但是,由于这些方法通常是基于从连续的RGB框架中预先计算的光流,因此这忽略了对间框架内发生的事件的时间考虑,因此限制了其识别其表现出相对静态性但在运动中确实在运动中表现出相对静态物体的能力。为了解决这些局限性,我们建议利用事件摄像机以更好地理解视频,从而在不依赖光流的情况下提供了丰富的运动提示。为了培养该领域的研究,我们首先引入了一个名为DSEC-MOS的新型大型数据集,用于从移动自我车辆中移动对象进行分割,这是同类的第一个。为了进行基准测试,我们选择了各种主流方法,并在我们的数据集上严格评估它们。随后,我们设计了一种能够利用事件数据的新型网络。为此,我们将事件的临时事件与空间语义图融合在一起,以区分真正的移动对象和静态背景,并围绕着我们感兴趣的对象增加了另一个密集的监督。我们提出的网络仅依靠用于培训的事件数据,但在推理过程中不需要事件输入,从而使其直接与仅限框架方法相媲美,并且在许多应用程序情况下都可以使用更广泛的使用。源代码和数据集可公开可用:https://github.com/zzy-zhou/dsec-mos。详尽的比较突出了我们方法对所有其他方法的显着性能提高。
egomimic:通过以自我为中心视频
缩放人与机器人数据。为了研究人类和机器人数据源对性能的缩放效果,我们为cont进行了其他数据收集。对象中的孔任务。如图8,对2小时的机器人数据和1小时人类数据进行了训练,对3个小时的机器人数据(128 vs 74分)进行了训练。值得注意的是,一个小时的人类数据可产生1400个演示,而一个小时的机器人数据中只有135个演示。这些结果证明了自我有效利用人类数据收集效率的能力,从而产生了更明显的缩放效应,从而实质上可以提高任务性能,而不是仅靠机器人数据而实现的目标。我们注意到,在2小时的机器人数据下,在2小时的机器人数据中,egomimic优于ACT,因此一些改进归因于体系结构。

egosim:运动和活动期间的egecentric多视图模拟器和真实的型摄像机的真实数据集
对计算机视觉中以自我为中心任务的研究主要集中在标题相机上,例如鱼眼摄像机或沉浸式耳机内的嵌入式相机。我们认为,越来越多的光学传感器的微型化将导致相机在各个位置的多产摄像机中的多产。这将为计算机视觉中的确定任务带来新的观点,并使关键领域(例如人类运动跟踪,身体姿势估计或行动识别)尤其是针对下半身,通常会被遮挡。在本文中,我们介绍了Egosim,这是一种新颖的人体镜头相机的模拟器,该相机从佩戴者的身体上从多个角度产生了逼真的自我中心效果图。Egosim的关键特征是它使用真实的运动捕获数据来渲染运动伪像,这在手臂或腿部的摄像机中尤其明显。此外,我们还介绍了多款镜头的数据集,该数据集来自六个身体上的相机和地面真实真实的全身3D姿势:119小时的数据是从四个高效率的虚拟环境中的积极运动序列得出的,我们使用13个Gopro的5小时的运动范围和3 g的运动来增强,这些数据来自5小时,并从13个小时内增强。 套装。我们通过训练仅端到端视频3D姿势估计网络来证明Egosim的有效性。分析其域间隙,我们表明我们的数据集和模拟器大大帮助推断现实世界数据。EgoSim代码和MultieGoview数据集:https://siplab.org/projects/egosim
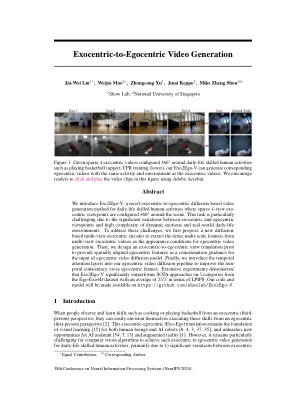
Exentric到中心的视频生成-NIPS Papers
我们介绍了Exo2EGO-V,这是一种新颖的以外为中心为中心的基于质量扩散的视频生成方法,用于日常生活熟练的人类活动,其中稀疏4-视图中心的观点在现场周围配置了360°。由于外主和以自我为中心的观点和动态运动和现实世界中日常生活环境之间的显着差异,此任务尤其具有挑战性。为了应对这些挑战,我们首先提出了一种新的基于扩散的多视图外科编码器,以从多视图exentric视频中提取密集的多尺度功能,作为以自我为中心视频的外观条件。然后,我们在提供空间对立的自我中心特征之前设计了一个自以为是至中心的视图翻译,作为对以egipentric视频扩散模型的输入的串联指导。最后,我们将时间关注层引入我们的以自我为中心的视频扩散管道中,以改善温度一致性跨eg中心框架。广泛的实验表明,Exo2EGO-V从EGO-EXO4D数据集中显着超过SOTA方法,而LPIP的平均为35%。我们的代码和模型将在https://github.com/showlab/exo2ego-v上提供。
从以自我为中心视频的过程理解
任务:给定视频段s及其以前的视频段历史记录,必须:1)确定先前的键步(在s t之前执行);推断如果S t为2)可选或3)程序错误; 4)预测缺失的密钥步骤(应该在s t之前进行,但不是); 5)下一个关键步骤(满足依赖关系)。
lanvikd:以自我为中心动作识别的跨模式语言知识蒸馏
通过分析以自我为中心的视频的分析,抽象理解人类行动是智能代理人的理想能力,并且是一个最近越来越受欢迎的研究领域。到目前为止,大多数以自我为中心的(视频)动作识别(EAR)的方法,即,根据预定义的自然语言描述(动作)对给定的视频剪辑进行分类的任务,代表目标动作类(标签)使用一个hot编码,从而忽略了某些动作之间的任何关系或相似性。这项工作的目标是通过利用预先训练的语言模型中编码的先前存在的知识来增强视觉模型的概括能力。具体来说,我们提出了一个语言知识蒸馏框架,以将预训练的语言模型对动作(文本中表达)的知识(在文本中表达)提高到视觉模型。我们不使用标签的单热编码表示,而是将所有动作类别(由语言模型构成)的概率分布作为教学信号。我们的实验表明,我们的框架根据Epic-Kitchens,Something of Something V2等基准获得了EAR的性能和泛化能力。
蒙版视频和肤色imu自动编码器用于以自我为中心动作识别
摘要。与视觉信号相比,放置在人体四肢上的惯性测量单元(IMU)可以捕获准确的运动信号,同时对照明变化和遮挡具有鲁棒性。尽管这些角色 - 在帮助以以上为中心的行动识别方面是有价值的,但IMU的潜力仍然不足。在这项工作中,我们提出了一种新颖的动作识别方法,该方法将来自人体磨损的IMU的运动数据与以自我为中心的视频相结合。由于标记的多模式数据的稀缺性,我们设计了一种基于MAE的自我监管预处理方法,通过对视觉和运动信号之间的自然相关性进行建模,从而获得了强大的多模式表示。为了建模整个体内的多个IMU设备的复合关系,我们利用了多个IMU设备中的协作动力学,并建议将人类关节的相对运动特征置入图形结构中。实验表明我们的方法可以在多个公共数据集上实现最新性能。在更具挑战性的场景中,我们的基于MAE的预培训和基于图的IMU建模的有效性得到了进一步的验证,包括部分缺少IMU设备和视频质量损坏,从而促进现实世界中更灵活的用法。