
XiaoMi-AI文件搜索系统
World File Search SystemEntity

利用大型语言模型进行供应链网络提取和实体分类
供应链网络对于行业的运营效率至关重要,但其日益复杂的特性给映射关系和识别各种实体的角色带来了巨大挑战。构建供应链网络的传统方法严重依赖结构化数据集和手动数据收集,限制了其范围和效率。相比之下,自然语言处理 (NLP) 和大型语言模型 (LLM) 的最新进展为使用非结构化文本数据发现和分析供应链网络提供了新的机会。本文提出了一种新方法,利用 LLM 从公开来源提取和处理原始文本信息以构建全面的供应链图。我们以土木工程领域为例,展示了 LLM 如何揭示公司、项目和其他实体之间的隐藏关系。此外,我们对 LLM 进行了微调,以对供应链图中的实体进行分类,从而提供有关其角色和关系的详细见解。结果表明,特定领域的微调提高了分类准确性,凸显了 LLM 在行业特定供应链分析中的潜力。我们的贡献包括为土木工程领域开发供应链图,以及增强实体分类和供应链网络理解的微调 LLM 模型。

汇丰 TCFD 实体报告 2023
在编制本报告所载的 ESG 相关信息时,我们做出了许多关键判断、估计和假设,所涉及的过程和问题很复杂。我们使用了 ESG(包括气候)数据、模型和方法,我们认为,截至使用之日,这些数据、模型和方法适合于理解和评估气候变化风险及其影响、分析排放、设定 ESG 相关目标以及评估可持续投资的分类。然而,这些数据、模型和方法(包括第三方专有估计模型、方法、假设、技术和未公开的模型数据输入)通常是新的、快速发展的,与其他财务信息中的标准不同,也不受相同或等效的披露标准、历史参考点、基准或全球公认会计原则的约束。特别是,在气候变化及其演变的情况下,不可能依赖历史数据作为未来轨迹的有力指标。

从零到英雄:在零和几射击上下文中利用生物医学命名实体识别的变压器
在生物医学领域中监督的命名实体识别(NER)取决于带有命名实体的大量带注释的文本。创建此类数据集可能是耗时且昂贵的,而新实体的提取需要其他注释任务并重新训练模型。本文提出了一种在生物医学领域中零和少量NER解决这些挑战的方法。该方法基于将多类令牌分类的任务转换为二进制令牌分类,并在大量数据集和生物医学实体上进行预训练,这使该模型可以学习给定和潜在的新颖命名实体标签之间的语义关系。,我们的零拍摄NER的平均F1得分为35.44%,单发NER为50.10%,10-Shot NER的平均F1得分为69.94%,在9种不同的具有基于微调PubMedbert模型的生物医学实体上,100-SHOT NER的平均F1得分为79.51%。结果证明了所提出的方法在识别没有或有限示例的新生物医学实体,优于先前的变压器方法,并且使用少于1000倍的参数的模型与基于GPT3的模型相媲美。我们公开制作模型并开发了代码。

直接归档实体公告 - 用户指南
出于表格5500的报告目的,私人退休金计划要么直接持有资产(例如现金,股票,政府证券,共同基金等)或间接(即在汇总投资安排中)。在某些情况下,这些合并投资安排的赞助商要么需要或可以选择为这些实体提交5500表格。表格5500指令确定直接申请实体(DFE)等实体。1取决于DFE是否提交表格5500,投资养老金计划的报告要求有所不同。投资不提交表格5500的DFE的退休金计划需要在附表H - 财务信息 - 大型计划中报告所有资产,就好像直接持有这些资产一样。投资于DFE的退休金计划,该计划提交5500表格可以通过报告正确的DFE类型的行项目中投资于这些DFE的所有资产,从而获得报告救济。
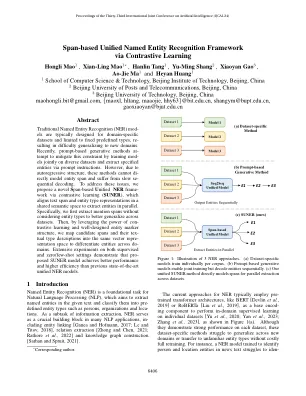
基于对比度学习的基于跨度的统一命名实体识别框架
传统命名实体识别(NER)模型通常是为特定于域的数据集而设计的,并且仅限于固定的预定义类型,这是难以推广到新域的困难。最近,基于及时的生成方法可以通过在不同的数据集上共同培训模式,并通过及时说明提取指定的实体,以减轻这种约束。但是,由于自回旋结构,这些方法无法直接建模实体跨度,并且会遭受缓慢的分解。为了解决这些问题,我们通过对比度学习(SUNER)提出了一个基于新颖的S基础的Unified Ner框架,该框架将文本跨度和实体类型表示在共享的语义空间中保持一致,以并行提取实体。具体来说,我们首先提取跨度,而无需考虑实体类型以更好地概括跨数据集。然后,通过利用构图的学习和精心设计的实体标记结构的力量,我们将候选人跨度及其textual类型描述映射到相同的矢量代表空间中,将其映射到跨多个方面的区分实体。对监督和零/少数拍摄设置进行了广泛的实验表明,与以前的最先进的统一NER模型相比,实现的Suner模型可实现更好的性能和更高的效率。

ds@gt clef2024 bionne竞赛工作说明
可能彼此包含的嵌套命名实体的抽象识别可以增强发现命名实体的覆盖范围。此功能对于诸如关系提取,实体链接和知识图种群等任务特别有用。本文介绍了组织者关于Bionne竞赛的报告,该报告的重点是英语和俄语的医学文本中嵌套的名为实体识别系统。比赛包括三个子任务:双语,面向英语和面向俄语。培训和验证集源自Nerel-Bio数据集的一个子集,该数据集是PubMed摘要的语料库。对于Bionne评估,从原始数据集中选择了八种最常见的医疗实体类型。此外,为共享任务开发了一个新颖的测试集,其中包括英语和俄语的154个摘要。在BioASQ研讨会的框架内举行,竞争旨在推进生物医学领域内嵌套的研究。

2021-2023 年中央采购实体框架报告
AAEE 额外可实现能源效率 AS 辅助服务 ATE 额外交通电气化 BTM 电表后 CAISO 加州独立系统运营商 CAM 成本分配机制 CARB 加州空气资源委员会 CEC 加州能源委员会 CCA 社区选择聚合器 CCGT 联合循环燃气轮机 CHP 热电联产 CPM 容量采购机制 CPE 中央采购实体 CPP 临界峰值定价 CPUC 加州公用事业委员会 CSP 竞争性招标程序 CT 燃气轮机 DA 直接访问 DG 分布式发电 DR 需求响应 DRAM 需求响应拍卖机制 ED 能源部门 EE 能源效率 ELCC 有效负荷承载能力 EFC 有效灵活容量 ESP 电力服务提供商 ExD 特殊调度 FERC 联邦能源管理委员会 GHG 温室气体 HE 每小时结束 IE 独立评估员 IOU 投资者所有的公用事业 IEPR 综合能源政策报告 IRP 综合资源规划 IV 帝国谷 kW千瓦 LCR 本地容量需求

人工智能可能的风险及缓解措施 - 命名实体识别
NER 如何工作?命名实体识别技术基于三种主要方法:词典、规则和机器学习 2 :• 基于词典或基于字典的方法依赖于来自不同来源(例如预先存在的标记数据集和在线资源)的预定义术语列表。在这种方法中,输入文本与词典中的条目匹配以识别命名实体。此方法可能难以对新命名实体和含义模糊或拼写变化的实体进行分类。• 基于规则的系统包含手动或自动构建的规则 3 ,旨在根据文本中的特定模式或标准检测实体。• 基于监督机器学习的方法可以通过从带注释的数据中学习,自动识别和分类新文本中的命名实体。此方法需要大量 4 带注释的训练数据来估计和微调模型的参数。虽然早期的 NER 系统主要依赖于词典和手工制定的基于规则的方法,但现代技术主要采用机器学习,因为它们能够很好地适应和推广到各种环境和领域。一些 NER 系统结合了多种方法来提高其性能和准确性。5 采用无监督机器学习的新兴 NER 系统(大型语言模型,如 BERT 6 、GPT-4、LlaMA 和 Mistral)可以提供一种替代方法,有助于减少通常耗时且昂贵的使用标记命名实体注释训练数据的过程。虽然这仍然是一种新颖的方法,但与传统的监督方法相比,它有潜力处理更复杂的任务。
实验室开发的测试:小实体合规指南
2024年5月6日,FDA在题为“医疗设备;实验室开发了测试”的联邦公报上发布了最终规则(89 FR 37286)(“ LDT最终规则”)。该最终规则修改了FDA法规,以明确表明体外诊断产品(IVD)是《联邦食品,药物和化妆品法》(FD&C ACT),包括IVD制造商是实验室的设备。1该修正案反映出FD&C ACT中的设备定义并未区分制造设备的实体。与修正案结合使用,FDA逐步淘汰其对实验室开发的测试(LDTS)2的一般执行酌处权方法,以便实验室制造的IVD通常与其他IVD相同的执法方法(即FDA对合规性的期望通常相同)。在LDT最终规则的序言中,更全面地描述了该阶段的策略,其中包括针对由实验室制造的特定类别的IVD的执法酌处权,包括目前以LDTS 3和LDTS提供的IVD,以满足未满足的需求。

德克萨斯可靠性实体公司 - 2025 年业务计划和预算
组织概述 德克萨斯可靠性实体公司 (Texas RE) 是一家德克萨斯州非营利性公司,是德克萨斯州电力可靠性委员会公司 (ERCOT) 地区的区域实体,根据其与北美电力可靠性公司 (NERC) 于 2021 年 1 月 1 日生效的修订和重述授权协议 (授权协议)。德克萨斯 RE 确保 ERCOT 地区大容量电力系统 (BPS) 的可靠性。ERCOT 地区是位于德克萨斯州境内的地理区域,在德克萨斯州公共事业委员会 (PUCT) 的管辖范围内运营,并且不与德克萨斯州以外运营的任何电力公司同步互连。ERCOT 地区包括德克萨斯州约 90% 的负荷和 75% 的德克萨斯州土地面积。