
XiaoMi-AI文件搜索系统
World File Search SystemInteract

知识表示和人类机器人互动领域知识的互动学习
本文介绍了在人机协作背景下代表,推理和交互式学习领域知识的综合体系结构。答案集Prolog是一种非单调逻辑推理范式,用于用不完整的comsense域知识来表示和理由,为任何给定目标计算计划并诊断出意外的观察。基于ASP的推理还用于指导以前未知的动作的互动学习以及编码负担能力,动作前提和效果的公理。此学习将主动探索,反应性动作执行和人类(口头)描述的输入观察以及学习的动作和公理用于后续推理。在模拟机器人上评估了架构,该机器人协助人类在室内域中。
50“全合一的PCAP交互式显示,灵感来自技术,专为创意空间而设计
用户控制图片(亮度,对比度,清晰度,背部,色彩,颜色,降噪,选择,低蓝光,低光,颜色温度,颜色控制,颜色控制,超级,图片重置),屏幕(缩放模式,自定义缩放,屏幕重置),音频(balance,balance,balance,traleble,treble,bass,bass,bass,audio nof(line out out(line),最高),最大volume, mute, audio reset, audio out sync, speaker setting), configuration 1 (Android launcher, switch on state, Touch lock, Touch mode, mouse mode, panel saving, RS232 routing, boot on source, WOL, conf.1 reset, factory reset), configuration 2 (OSD timeout, OSD H position, OSD V position, system rotation, info OSD, logo and animation, logo setting, animation设置,监视ID,监视信息,HDMI版本,conf2重置),高级选项(售货亭模式,侧栏,无信号图像,电动支架,电动控制,电源LED照明,风扇,关闭计时器,时间表,带有一根电线的HDMI,带有一线电线的HDMI,一根电线,故障转移,语言,OSD透明度,电源节省,电源节省,高级选项,高级选项重置)

肿瘤微环境相互作用引导图形学习,从全切片病理图像进行人类癌症生存分析
深度学习技术的最新进展为协助病理学家从全切片病理图像(WSI)中预测患者的生存期带来了可能性。然而,大多数流行的方法仅适用于WSI中特定或随机选择的肿瘤区域中的采样斑块,这对于捕捉肿瘤与其周围微环境成分之间复杂相互作用的能力非常有限。事实上,肿瘤在异质性肿瘤微环境(TME)中得到支持和培育,详细分析TME及其与肿瘤的相关性对于深入分析癌症发展的机制具有重要意义。在本文中,我们考虑了肿瘤与其两个主要TME成分(即淋巴细胞和基质纤维化)之间的空间相互作用,并提出了一种用于人类癌症预后预测的肿瘤微环境相互作用引导图学习(TMEGL)算法。具体来说,我们首先选择不同类型的块作为节点来为每个 WSI 构建图。然后,提出了一种新颖的 TME 邻域组织引导图嵌入算法来学习可以保留其拓扑结构信息的节点表示。最后,应用门控图注意网络来捕获肿瘤与不同 TME 组件之间与生存相关的交集以进行临床结果预测。我们在来自癌症基因组图谱 (TCGA) 的三个癌症队列上测试了 TMEGL,实验结果表明 TMEGL 不仅优于现有的基于 WSI 的生存分析模型,而且对生存预测具有良好的可解释能力。

双AI:用于群体活动识别的双路径参与者交互学习
学习多个参与者之间的时空关系对于群体活动识别至关重要。不同的群体活动通常会展示视频中参与者之间的多样化互动。因此,从时空参与者演化的单一视角来建模复杂的群体活动往往很困难。为了解决这个问题,我们提出了一个独特的双路径参与者交互 (Dual-AI) 框架,它以两种互补的顺序灵活地排列空间和时间变换器,通过整合不同时空路径的优点来增强参与者关系。此外,我们在 Dual-AI 的两个交互路径之间引入了一种新颖的多尺度参与者对比损失 (MAC-Loss)。通过帧和视频级别的自监督参与者一致性,MAC-Loss 可以有效区分单个参与者表示,以减少不同参与者之间的动作混淆。因此,我们的 Dual-AI 可以通过融合不同参与者的这些判别特征来增强群体活动识别。为了评估所提出的方法,我们在广泛使用的基准上进行了大量实验,包括排球 [ 21 ]、集体活动 [ 11 ] 和 NBA 数据集 [ 49 ]。所提出的 Dual-AI 在所有这些数据集上都实现了最佳性能。值得注意的是,所提出的 Dual-AI 使用 50% 的训练数据,其性能优于许多近期使用 100% 训练数据的方法。这证实了 Dual-AI 在群体活动识别方面的泛化能力,即使在有限监督的具有挑战性的场景下也是如此。

人机交互范例 - DTIC
但是现在,尽管文字处理尚未完成分析,但可用性的前沿已经因为新应用程序和新界面技术的开发和引入而不断向前推进。电子邮件和计算机会议支持等通信应用程序所带来的可用性挑战远比文字处理向非程序员扩展所带来的挑战更加多样化。在当前技术中,多个用户通过极其不同的工作站类型协作访问多个应用程序。就在这些新领域的可用性问题得到阐述和探索的同时,前沿原型正在引入手势(例如手写)和语音输入以及交互式视频输出。这些新发展正在整个行业中以更快的速度、更广泛地发生,并随着时间的推移影响更多的用户。

LGA -PLN -001_CRUISE AV(BOLT) - 执法互动计划-05.2024
Cruise AV的标志是其安全的硬件传感器套件,在外部可见。传感器套件不会在外部共享信息,不会通过云数据处理来跟踪或以任何身份保留第三方。这种传感器阵列使Cruise AV能够收集有关其环境的信息并告知系统的驾驶决策。在AV的后备箱内是组成系统“大脑”的计算机,并迅速综合了硬件套件收集的信息,以通过感知(了解环境),预测(评估给定环境的可能的安全路径或轨迹)和控制驾驶(驾驶驾驶员)(评估可能的安全路径或轨迹)。有关巡航自主系统如何工作的更多信息,并在此处的2022 Cruise安全报告中提供了一个安全的驾驶员。

类比设计中人与人工智能的交互协同创造力
简介 十一年前,马希尔 (Maher) 问道:“谁在创造?” (Maher 2012),并提出了几个创造性应用的分析空间,包括构思和互动两个维度。马希尔的问题引出了乔丹诺斯 (Jordanous) 的 PPP 视角框架,其中创造行为可以由人类或人工智能 (Jordanous 2016) 执行,以及坎托萨洛 (Kantosalo) 和塔卡拉 (Takala) 的 5C 框架,其中创造行为由人类和人工智能共同组成的集体执行 (Kantosalo and Takala 2020)。1然而,对于人与人工智能互动中创造力的位置,人们的共识较少。混合主动性创造性界面方法提出了一组基本的细粒度活动,这些活动可以由人类或人工智能以某种结构化对话的形式执行(Deterding 等人,2017 年;Spoto 和 Oleynik,2017 年),随后扩展到生成应用(Muller、Weisz 和 Geyer,2020 年),针对特定算法方法进行了改进(Grabe、Duque 和 Zhu,2022 年),并针对其他算法方法进行了批评(Zheng,2023 年)。虽然这些方法生成了重叠的分析动作词汇,但它们并没有解决创造力在何处发生(以及由谁或什么通过这些动作发生)的问题。在这篇短文中,我们提供了对该问题的一个答案的几个例子。我们重新利用 Kantosalo 和 Takala (2020) 的 5C 中的集体概念,提出一种类型的创造力可能会在以下互动空间中不对称地出现 (Rezwana and Maher 2022)

人机交互中的用户表征
摘要 光标、头像、虚拟手或工具以及其他渲染的图形对象使用户能够与 PC、游戏机或虚拟现实系统等计算机进行交互。我们从用户的角度在“用户表征”的统一概念下分析这些不同对象的作用。这些表征是虚拟对象,它们人为地延伸了用户的身体,使他们能够通过执行不断映射到其用户表征的运动动作来操纵虚拟环境。在本文中,我们确定了一组与不同用户表征相关的概念,并对用户表征的控制和主观体验背后的多感官和认知因素进行了多学科回顾。这些概念包括视觉外观、多模态反馈、主动感、输入法、近体空间、视觉视角和身体所有权。我们进一步为这些概念提出了研究议程,这可以引导人机交互社区从更广泛的视角了解用户如何通过他们的用户表征进行感知和交互。
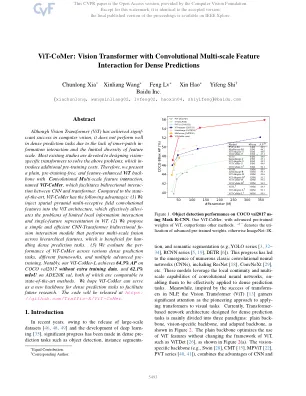
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。
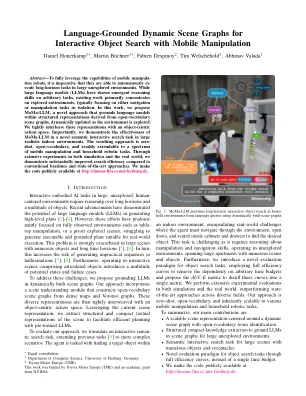
用移动操作的交互式对象搜索语言的动态场景图
摘要 - 为了充分利用移动操纵机器人的功能,必须在大型未探索的环境中自主执行的长途任务。虽然大型语言模型(LLMS)已显示出关于任意任务的紧急推理技能,但现有的工作主要集中在探索的环境上,通常集中于孤立的导航或操纵任务。在这项工作中,我们提出了MOMA-LLM,这是一种新颖的方法,该方法将语言模型基于从开放式摄影场景图中得出的结构化表示形式,随着环境的探索而动态更新。我们将这些表示与以对象为中心的动作空间紧密地交织在一起。重要的是,我们证明了MOMA-LLM在大型现实室内环境中新型语义交互式搜索任务中的有效性。最终的方法是零拍摄,开放式摄影库,并且可以易于扩展到一系列移动操作和家用机器人任务。通过模拟和现实世界中的广泛实验,与传统的基线和最新方法相比,我们证明了搜索效率的显着提高。我们在http://moma-llm.cs.uni-freiburg.de上公开提供代码。