
XiaoMi-AI文件搜索系统
World File Search SystemLanguage
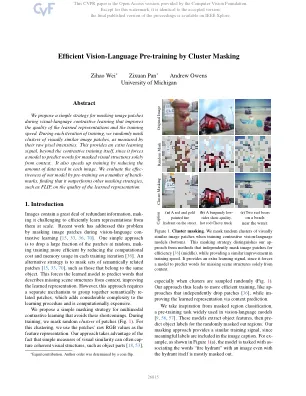
通过群集掩模的有效视力语言预训练
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],

基于人工智能的中文教学的个性化策略的研究
版权所有©2024作者和Frontier Scientific Research Publishing Inc.这项工作是根据创意共享归因国际许可证(CC by 4.0)获得许可的。http://creativecommons.org/licenses/4.0/
语言模型是否可以建立有关ICD代码的原因来指导临床笔记的产生?
摘要。在过去的十年中,美国的电子健康记录(EHR)数据数量激增,归因于《 2009年健康信息技术经济和临床健康法》(HITECH)2009年的有利政策环境和2016年21世纪治疗法案。医生在自由形式的文本中捕获了患者评估,诊断和治疗的临床笔记,他们花费大量时间进入他们。手动编写临床笔记可能需要大量时间,增加患者的等待时间,并可能延迟诊断。大型语言模型(LLM),例如GPT-3具有生成与人类写作的新闻文章的能力。我们调查了对临床笔记生成中LLM的促进工程促进工程的用法(COT)。在提示中,我们将疾病国际分类(ICD)代码和基本患者信息以及类似的临床病例示例纳入了研究,以研究LLMS如何有效地制定临床注释。,我们使用GPT-4作为LLM对Codiesp测试数据集的六个临床病例进行了COT提示技术,结果表明,它的表现优于标准的零照片提示。

可解释的AI(XAI)和大型语言模型(LLM)
➢这是一个欺骗深神经网络(DNN)的实验:在第二和第四张图像中,工程师仅保留了系统用于识别吉他和企鹅的系统的元素,并更改了其余的所有内容,以使系统仍然像吉他和企鹅一样“看到”他们。➢Goodfellow等人的作品。(2014)从普遍的扰动开始打开了进一步发展的大门(Moosavi-Dezfooli等人。2017)最近的一个像素攻击,该攻击显示了如何通过在输入图像中更改一个像素来欺骗神经网络。笔记本在这里一张像素攻击原始纸
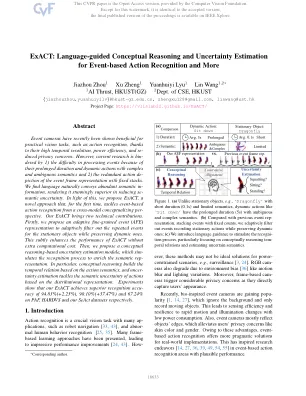
精确:基于事件的行动识别和更多
事件摄像机最近显示出对实用视觉任务的有益,例如行动识别,这要归功于其高度分辨率,功率效率和引起的隐私问题。然而,当前的研究是由1)处理事件的困难,因为它们的持续时间长时间和动态动作具有复杂而模棱两可的语义; 2)事件框架表示带有固定堆栈的冗余作用。我们发现语言自然传达了丰富的语义信息,从而使其在降低疾病的不确定性方面非常出色。鉴于此,我们提出了一种新颖的方法,这是第一次解决基于事件的动作识别的跨模式概念化的识别。我们的确切确切带来了两项技术贡献。首先,我们提出了一个自适应细粒事件(AFE)表示,以自适应地过滤固定对象的重复事件,同时保留动态的对象。这巧妙地增强了精确的性能,而无需额外的计算成本。然后,我们提出了一个基于概念推理的不确定性估计模块,该模块模拟了识别过程以丰富语义代表。尤其是,概念推理基于动作语义建立时间关系,而不必要的估计可以解决基于分布表示的动作的语义不确定性。实验表明,在PAF,HADDV和我们的SEACT数据集上,我们的确切确切识别获得了94.83%(+2.23%),90.10%(+2.23%),90.10%(+37.47%)和67.24%。

回顾利用自然语言处理和人工智能进行实时分析中的高级数据可视化
本综述探讨了自然语言处理 (NLP) 和人工智能 (AI) 的集成,以增强实时分析的数据可视化。在数据呈指数增长的时代,传统的静态可视化越来越不能满足实时决策的需求。NLP 和 AI 提供了复杂的工具来动态解释和可视化数据,将大量原始信息转化为各个领域的可操作见解。本文综合了 NLP 和 AI 在数据可视化方面的当前研究、方法和应用,重点介绍了关键进展,例如增强的数据可解释性、实时数据处理能力以及通过自然语言查询和交互元素改善的用户交互。它还解决了实施这些技术所面临的挑战和局限性,包括计算复杂性、数据质量问题和道德考虑。本综述确定了重要的趋势和未来方向,例如增强现实和虚拟现实 (AR/VR) 的集成以及生成式 AI 模型的使用,这些趋势和方向有望进一步推动该领域的发展。通过全面概述数据可视化中 NLP 和 AI 的现状,本文旨在为未来的研究和开发工作提供参考和指导,以利用这些技术实现更有效、更高效的数据驱动决策。


欧洲通用语言数据空间
欧盟自 2019 年以来一直在实施其数据战略。1 面向工业的数据单一市场的一个关键组成部分是建立“可互操作的数据空间”以“汇集关键行业的欧洲数据”,在这个市场中“数据可以在欧盟内部和跨行业流动,造福所有人”、“欧洲规则 […] 得到充分尊重”并且“数据访问和使用规则公平、实用和明确”。欧盟委员会(2022 年)描述了一个初步的、相当粗略的概念,包括如何建立和运营这些数据空间,包括相关立法(另见 Nagel 和 Lycklama,2021 年)。该文件还列出了一些针对制造业、交通、医疗、金融、能源、农业和技能等行业的“官方”欧盟数据空间。由数字欧洲计划 (DEP) 2 中的采购合同资助的欧洲通用语言数据空间 (LDS) 就是这些官方欧盟数据空间之一。 3

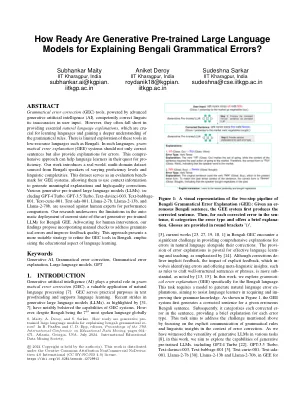
如何准备好生成的预训练的大语言模型来解释孟加拉语语法错误?
抽象的语法校正校正(GEC)工具,由先进的生成人工智能(AI)提供动力,在用户输入中有效地纠正了语言的不准确性。但是,它们通常在提供基本的自然语言解释方面缺乏,这些解释是学习语言并获得对语法规则的更深入的理解。在低资源语言(例如孟加拉语)中对这些工具的探索有限。在这样的语言中,革命错误说明(GEE)系统不仅应正确句子,而且还应提供错误的解释。这种综合方法可以帮助语言学习者寻求提高能力。我们的工作介绍了一个现实世界中的多域数据集,该数据集来自孟加拉语扬声器,具有不同的义务水平和语言复杂性。此数据集可作为GEE系统的评估基准标记,允许他们使用上下文信息来生成有意义的解释和高质量的更正。Various generative pre-trained large language models (LLMs), in- cluding GPT-4 Turbo, GPT-3.5 Turbo, Text-davinci-003, Text-babbage- 001, Text-curie-001, Text-ada-001, Llama-2-7b, Llama-2-13b, and Llama-2-70b, are assessed against human experts for performance comparison.我们的研究强调了自动部署孟加拉人GEE的当前最新生成预培训的LLM的局限性。主张进行人干预,我们的发现提议合并手动检查以解决语法错误并提高反馈质量。这种方法提出了一种更合适的策略,以重新确定孟加拉语的GEC工具,并阐明了语言学习的教育方面。