
XiaoMi-AI文件搜索系统
World File Search SystemModels

与BCL-XL阻滞的合成致命相互作用在转移性结直肠癌的患者衍生模型中加深对西妥昔单抗的反应
摘要◥目的:大约20%的RAS野生型转移性结直肠癌(MCRC)的患者经历了对抗EGFR抗体西素单抗的客观反应,但很少实现消除疾病。肿瘤收缩的程度与长期结局相关。我们的目的是找到合理组合,通过破坏对抗凋亡分子的适应性依赖性(BCL2,BCL-XL,MCL1)来增强西妥昔单抗的效率。实验设计:实验是在患者衍生的异种移植物(PDX)和类器官(PDXO)中进行的。凋亡的底漆。促凋亡和抗凋亡蛋白复合物。通过caspase激活PDXOS和监测PDX生长来评估组合疗法的影响。结果:由314个PDX队列中的人口试验,由许多患者确定,确定46个模型(14.6%),具有明显的
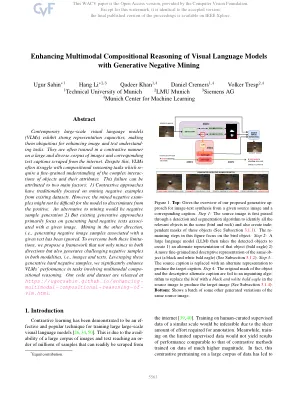
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。

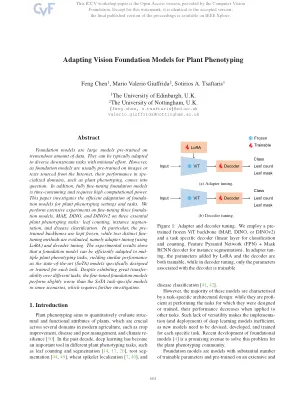
适应植物表型的视觉基础模型
基础模型是对大量数据进行预训练的大型模型。通常可以以最小的努力来适应各种下游任务。但是,由于基础模型通常是在从互联网中提出的图像或文本上进行预培训的,因此它们在植物表型等植物域中的性能受到质疑。此外,完全调整基础模型是耗时的,需要高计算能力。本文研究了植物表型设置和任务的基础模型的有效适应。我们对三个基础模型(MAE,Dino和Dinov2)进行了大量实验,对三个必需的植物表型任务:叶子计数,实例阶段和疾病分类。特别是,预先训练的骨干被冷冻,同时评估了两种不同的调整方法,即适配器调整(使用lora)和解码器调整。实验结果表明,基础模型可以充分地适应植物表型任务,从而产生与针对每个任务的最先进的模型(SOTA)模型相似的性能。尽管在不同任务上表现出很高的传递能力,但在某些情况下,精细调整的基础模型的表现比SOTA任务特定的模型稍差,这需要进一步研究。

太阳-地球模型和应用软件
简要说明:国际参考电离层 (IRI) 是由空间研究委员会 (COSPAR) 和国际无线电科学联合会 (URSI) 赞助的一个国际项目。这些组织在 20 世纪 60 年代末成立了一个工作组,根据所有可用的数据源,制定电离层的经验标准模型。该模型的几个稳步改进版本已经发布。IRI 描述了从约 50 公里到约 2000 公里的高度范围内的电子密度、电子温度、离子温度和离子成分。它提供了磁平静条件下非极光电离层的月平均值。主要数据来源是全球电离层网络、强大的非相干散射雷达(Jicamarca、Arecibo、Millstone Hill、Malvern、St. Santin)、ISIS 和 Alouette顶部探测器,以及几颗卫星和火箭上的现场仪器。IRI 每年在特别 IRI 研讨会期间更新(例如,在 COSPAR 大会期间)。计划进行几项扩展,包括离子漂移模型、极光和极地电离层的描述以及对磁暴效应的考虑。
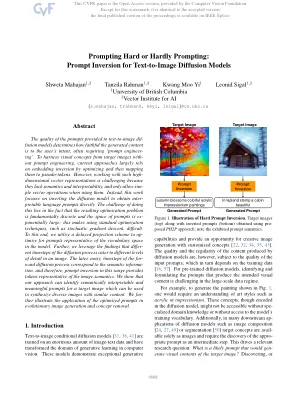
提示文本到图像扩散模型的迅速反转
提供给文本对图像差异模型的提示的质量决定了生成的内容对用户意图的忠诚程度,通常需要“及时工程”。要通过及时的工程来利用目标图像的视觉概念,当前方法在很大程度上通过优化然后将它们映射到伪tokens来依赖嵌入反演。然而,使用这种高维矢量表示是具有挑战性的,因为它们缺乏语义和可解释性,并且只允许使用它们时模拟矢量操作。相反,这项工作着重于反转扩散模型,以直接获得可靠的语言提示。这样做的挑战在于,由此产生的优化问题从根本上是离散的,提示的空间呈较大。这使得使用标准优化技术,例如随机梯度下降,困难。为此,我们利用延迟的投影方案来访问代表模型中词汇空间的提示。此外,我们利用了扩散过程的时间段与图像中不同级别的细节相差的发现。后来的,嘈杂的,前传扩散过程的时间段对应于语义信息,因此,此范围内的迅速反转提供了代表图像语义的令牌。我们表明,我们的方法可以确定目标图像的语义可解释和有意义的提示,该提示可用于合成具有相似内容的多样化图像。我们说明了优化提示在进化图像生成和概念删除中的应用。

语言模型作为视觉的黑盒优化器...
在Web-scale数据集中预先训练的视觉语言模型(VLMS)在用最小数据调整时,在下游任务上表现出了显着的功能。但是,许多VLM依赖于专有数据,而不是开源数据,这限制了使用白色框的使用进行精细调整。因此,我们旨在开发一种黑匣子方法来通过自然语言提示来优化VLM,从而避免需要访问模型参数,功能嵌入甚至输出逻辑。我们采用基于聊天的LLMS来搜索VLM的最佳文本提示。特别是,我们采用了一种自动的“爬山”程序,该程序通过评估当前提示的性能并要求LLMS根据文本反馈来对其进行融合,从而将其融合到有效的提示中,所有这些程序都在没有人类的对话过程中进行了反馈。在具有挑战性的1-Shot图像分类设置中,我们的简单方法平均超过了白色框连续提示方法(COP)1。在包括Imagenet在内的11个数据集中有5%。我们的方法还优于人工工程和LLM生成的提示。我们高出了对话反馈的优势,该反馈既不是正面和负面提示,表明LLM可以在文本反馈中利用隐式“梯度”方向,以进行更有效的搜索。此外,我们发现通过我们的策略生成的文本提示不仅更容易解释,而且还以黑盒方式在不同的VLM架构上良好地转移。最后,我们在最先进的Black-Box VLM(DALL-E 3)上演示了我们的框架,以进行文本对图像优化。
培训计算最佳的大语言模型
Layton,D。“ Chatgpt - 我们如何到达今天的位置 - GPT开发的时间表。” https://medium.com/@dlaytonj2/chatgpt-how-we-we-got-to-wher-we-we-are-today-a-timeline-timeline-fppt-development-f7a35dcc660e(2023)。Lubbad,M。“ GPT-4参数:无限制指南NLP的游戏规则改变者。”https://mlubbad.medium.com/the-ultimate-guide-to-gpt-4-parameters-verything-nything-to-to-to-to-to-to-about-about-about-about-about-about-nlps-changer-changer-109b87678555a(2023)。Shree,P。“开放AI GPT模型的旅程。”https://medium.com/walmartglobaltech/the-journey-open-open-ai-gpt-models-32d95b7b7fb2(2020)。
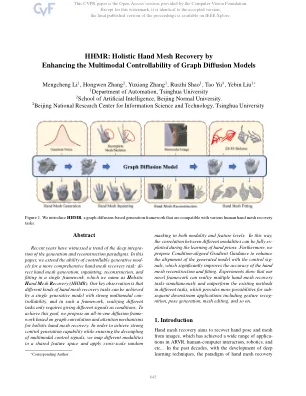
HHMR:通过增强图扩散模型的多模式可控性
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机

主要的新GFDL耦合气候和地球系统模型
Q1:关于GFDL建立和改善社会福利的天气,海洋和气候模型的核心优势,GFDL如何利用科学和计算能力的进步来改善其关键模型?有什么优势,差距和新的边界?