
XiaoMi-AI文件搜索系统
World File Search SystemMotion
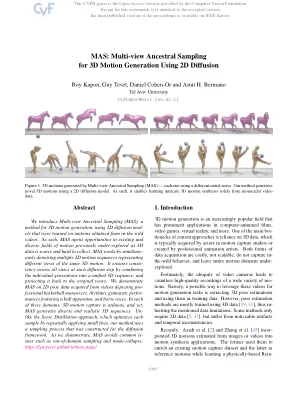
MAS:使用2D扩散
我们使用2D扩散模型引入了多视图祖传采样(MAS),这是一种3D运动生成的方法,这些方法是根据从野外视频中获得的动作进行训练的。因此,MAS为以前探索了3D数据而稀缺且难以收集的机会为令人兴奋和多样化的运动领域打开了机会。MAS通过同时降低多个2D运动序列来起作用,代表了同一3D运动的不同视图。它通过将单个世代组合到统一的3D序列中,并将其投影回原始视图,从而确保每个扩散步骤中所有视图的共识。我们在2D姿势数据上展示了MAS,从描述了演习篮球运动的视频中获取的数据,节奏的体操在带有球设备的节奏和赛马。在这些域中的每个域中,3D运动捕获都很艰难,但是,MAS生成了多样化和现实的3D序列。不喜欢分数蒸馏方法,该方法通过反复应用小固定来优化每个样品,我们的方法使用了为扩散框架构建的采样过程。正如我们所证明的那样,MAS避免了常见的措施,例如室外采样和模式折叠。https://guytevet.github.io/mas-page/
离子热运动的量子逻辑光谱
量子逻辑光谱 (QLS) 可用于缺乏合适电子能级结构来直接执行这些任务的原子和分子离子种类的内部状态制备和读出[1 – 4]。原则上,通过使用“逻辑离子”(LI) 及其与共捕获的“光谱离子”(SI) 的运动耦合,QLS 可以控制任何离子种类。如参考文献 [1] 中所述,传统 QLS 协议有两个主要局限性。首先,它要求将离子冷却到接近运动基态。其次,它的读出效率与 SI 的数量关系不大,这可能会阻碍将量子逻辑原子钟扩展到多个离子所带来的更高的稳定性[5]。已经开发出使用重复量子非破坏 (QND) 测量来减轻这些影响的方法[6 – 8]。然而,由于电子结构不合适,应用它们可能不可行,重复测量会降低光谱探针的占空比。在这里,我们演示了文献 [9] 中基于几何相位门提出的 QLS 方法

制造重塑的集成机器人运动和过程控制
摘要 - 金属制造过程的未来,例如激光切割,焊接和添加剂制造,应依赖于行业4.0支头的智能系统。这样的数字创新确实正在推动机械制造商进行深刻的转变。是根据针对特定过程设计和优化的定制机器,雄心勃勃是利用开放性和大量的工业机器人可用性,以提高多流程实现的灵活性和可重新配置。挑战在于,机械构建者将自己转变为高知名度专业的过程驱动的机器人集成器,能够用智能传感和认知方面的过程控制器杠杆优化机器人运动。这项工作描述了BLM集团和Politecnico di Milano的多年合作,在CNR的支持下,重点是部署完整的机器人工作站,其特征是机器人控制和运动计划与制造过程的完整整合。索引术语 - 指导的能量沉积,激光金属拆卸,添加剂制造的设计,CAD/CAM

用活动摄像头在夜间看到运动
我们专注于一项非常具有挑战性的任务:在夜间动态场景时进行成像。大多数以前的方法都依赖于常规RGB摄像机的低光增强。,他们不可避免地会在夜间长时间的长时间和动作场景的动作模糊之间面临困境。事件摄像机对动态变化的反应,其时间分辨率较高(微秒)和较高的动态范围(120dB),提供了替代解决方案。在这项工作中,我们使用活动摄像头提出了一种新颖的夜间动态成像方法。具体来说,我们发现夜间的事件表现出时间段落的特征和空间非平稳分布。conse-我们提出了一个夜间活动重建网络(NER-NET),主要包括可学习的事件时间戳校准模块(LETC),以使临时尾随事件和非均匀照明式落后事件保持一致,以稳定事件的spatiotalmorporal分布。此外,我们通过同轴成像系统构建了配对的真实低光事件数据集(RLED),这包括空间和时间对齐的图像GTS和低光事件的64,200个。广泛的实验表明,在视觉质量和泛化能力方面,所提出的方法优于最先进的方法。
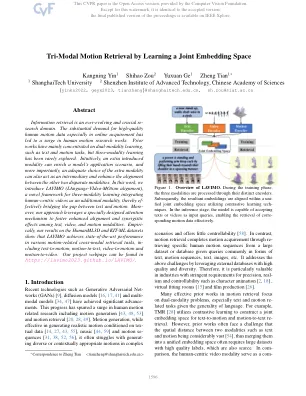
三模式运动通过学习联合嵌入空间
信息检索是一个不断发展且至关重要的搜索域。对高质量人类运动数据的大量需求,尤其是在在线获取中,导致人类运动研究工作的激增。先前的作品主要集中在双模式学习上,例如文本和运动任务,但是很少探索三模式学习。直觉上,额外的引入方式可以丰富模型的应用程序方案,更重要的是,对额外模式的适当选择也可以充当中介,并增强其他两个不同方式之间的对齐方式。在这项工作中,我们介绍了Lavimo(语言视频 - 动作对齐),这是一个三模式学习的新型框架,将以人为中心的视频整合为一种额外的方式,从而可以在文本和运动之间弥合差距。更重要的是,我们的方法利用了一种专门设计的注意机制来增强文本,视频和运动方式之间的一致性和协同作用。经验,我们对HumanML3D和Kit-ML数据集的结果表明,Lavimo在各种与运动相关的跨模式检索任务中实现了最先进的表现,包括文本到动作,动作到运动,视频,视频到视频,动作和动态。我们的项目网页可以在https://lavimo2023.github.io/lavimo/中找到。

通过运动吸引强大的通信网络
协作感知允许在多个代理(例如车辆和基础)之间共享信息,以通过交流和融合来获得对环境的全面看法。当前对多机构协作感知系统的研究通常会构成理想的沟通和感知环境,并忽略了现实世界噪声的效果,例如姿势噪声,运动模糊和感知噪声。为了解决这一差距,在本文中,我们提出了一种新颖的运动感知robus-Busban通信网络(MRCNET),可减轻噪声干扰,并实现准确且强大的协作感知。MRCNET由两个主要组成部分组成:多尺度稳健融合(MRF)通过驱动跨语义的多尺度增强的聚集到不同尺度的融合特征,而运动增强机制(MEM)捕获运动上下文,以补偿动作对物体引起的信息,从而解决了姿势噪声。对流行的协作3D对象检测数据集的实验结果表明,在噪声方案中,MRCNET优于使用较少的带宽感知性能的噪声方案。我们的代码将在https://github.com/indigochildren/collaborative-ception-mrcnet上进行重新释放。

学习空间和时间中的自相似性作为视频动作识别的广义运动
时空卷积通常无法学习视频中的运动动态,因此需要一种有效的运动表示来理解自然界中的视频。在本文中,我们提出了一种基于时空自相似性(STSS)的丰富而鲁棒的运动表示。给定一系列帧,STSS 将每个局部区域表示为与空间和时间中邻居的相似性。通过将外观特征转换为关系值,它使学习者能够更好地识别空间和时间中的结构模式。我们利用整个 STSS,让我们的模型学习从中提取有效的运动表示。我们所提出的神经块称为 SELFY,可以轻松插入神经架构中并进行端到端训练,无需额外监督。通过在空间和时间上具有足够的邻域体积,它可以有效捕捉视频中的长期交互和快速运动,从而实现鲁棒的动作识别。我们的实验分析表明,该方法优于以前的运动建模方法,并且与直接卷积的时空特征互补。在标准动作识别基准 Something-Something-V1 & V2、Diving-48 和 FineGym 上,该方法取得了最佳效果。

从文本说明中生成人类运动
由于其广泛的应用范围,从文本描述中产生人类动作已引起了越来越多的研究兴趣。但是,只有少数作品将人类场景的互动与文本条件一起考虑,这对于视觉和物理现实主义至关重要。本文提出了在3D门场景中产生人类动作的任务,鉴于人类习惯的文本描述。由于文本,场景和运动的多种形式性质以及对空间推理的需求,此任务提出了挑战。为了应对这些挑战,我们提出了一种新方法,将复杂的概率分解为两个更可管理的子问题:(1)目标对象的语言接地和(2)以对象为中心的信息产生。对于目标对象的语言基础,我们利用大型语言模型的力量。对于运动生成,我们设计了一个以对象为中心的场景代表生成模型,以专注于目标对象,从而降低场景的复杂性并促进人类运动与对象之间关系的建模。实验证明了与基准相比,我们的方法的更好运动质量并验证了我们的设计选择。代码将在链接上可用。
实习飞行软件、计算机视觉和人工智能 瑞士苏黎世 公司:Daedalean 是一家总部位于苏黎世的初创公司,由前谷歌和 SpaceX 工程师创立,他们希望在未来十年内彻底改变城市航空旅行。我们结合计算机视觉、深度学习和机器人技术,为飞机开发最高级别的自主性(5 级),特别是您可能在媒体上看到的电动垂直起降飞机。如果您加入我们的实习,您将有机会与经验丰富的工程师一起工作,他们来自 CERN、NVIDIA、伦敦帝国理工学院或……自治系统实验室本身。您将构建塑造我们未来的尖端技术。最重要的是,我们还提供在瑞士阿尔卑斯山试飞期间与我们的飞行员一起飞行的机会。项目:不同的团队都提供机会。我们希望更多地了解您,以及我们如何让您的实习成为双方宝贵的经历。告诉我们您一直在做什么,以及您想在我们的团队中从事什么工作。它与深度学习有关吗?状态估计?运动规划?计算机视觉?或者其他什么?向我们展示您的热情所在。如果我们可以在您想要从事的领域提供指导和有趣的机会,我们将一起敲定细节。资格:强大的动手 C++ 经过验证的解决问题的能力如何申请:将您的简历/履历发送至 careers@daedalean.ai 。电话
实习飞行软件、计算机视觉和人工智能瑞士苏黎世公司:Daedalean 是一家总部位于苏黎世的初创公司,由前谷歌和 SpaceX 工程师创立,他们希望在未来十年内彻底改变城市航空旅行。我们结合计算机视觉、深度学习和机器人技术,为飞机开发最高级别的自主性(5 级),特别是您可能在媒体上看到的电动垂直起降飞机。如果您加入我们的实习,您将有机会与经验丰富的工程师一起工作,他们来自 CERN、NVIDIA、伦敦帝国理工学院或……自治系统实验室本身。您将构建塑造我们未来的尖端技术。最重要的是,我们还提供在瑞士阿尔卑斯山试飞期间加入我们飞行员的机会。项目:不同团队提供机会。我们想更多地了解您,以及如何让您的实习成为双方宝贵的经历。告诉我们你一直在做什么,以及你想在我们的团队中从事什么工作。它与深度学习有关吗?状态估计?运动规划?计算机视觉?或者别的什么?向我们展示你的热情所在。如果我们可以在你想从事的领域提供指导和有趣的机会,我们将一起敲定细节。资格: 强大的动手 C++ 证明解决问题的能力 如何申请: 将您的简历/履历发送至 careers@daedalean.ai 。请告诉我们一些关于您自己的信息,为什么您认为自己适合我们以及为什么我们适合您。
敏捷自动驾驶汽车的实时运动计划
要允许复制或重新出版,请联系美国航空与宇航学院1801 Alexander Bell Drive,Suite 500,Reston,VA,20191–4344