
XiaoMi-AI文件搜索系统
World File Search SystemMulti

导致多种抗生素爆发的 R 因子
在两年的时间里,路易斯维尔大学医院出现了多重耐药性肺炎克雷伯菌引起的院内感染(M. Raff,未发表数据)。怀疑是 R 因子传播,因为在几种不同的肺炎克雷伯菌血清型中都发现了多重耐药特性(1、11、17)。在本研究中,我们表明,单一 R 因子是造成这种流行病的原因,并且在我们的医院环境中持续存在。脱氧核糖核酸 (DNA)-DNA 杂交用于在所有肺炎克雷伯菌菌株中识别这种 R 因子,并且可能被证明是持续研究这种和未来多重耐药微生物爆发的有用工具。(这项工作是 M.-A. Courtney 提交给路易斯维尔大学研究生院的论文的一部分,部分满足博士学位的要求。)

fMRI的多次采集序列:继续谨慎
fMRI的多功能或同时多层采集序列在过去十年中变得流行,部分原因是在大规模研究中采取的方法的影响,例如人类Connectome Project。但是,将这种高度加速的高分辨率序列应用于较小规模的项目可能存在明显的缺点,这在信号与噪声比,可靠性和实验能力方面存在很大的缺点。尤其是,使用较小的体素,较短的重复时间和高水平的多次加速度可能会对信号对噪声,图像伪像和腹侧脑区域的信号脱落产生强烈的负面影响。多功能序列可以是有价值的工具,尤其是对于专业应用程序,但应明智地应用于较小规模的研究,重点关注特定项目的端点,并在适当的测试和试点工作之后。
MP-SeizNet:一种使用 EEG 进行癫痫类型分类的多路径 CNN Bi-LSTM 网络。
癫痫发作类型识别对于癫痫患者的治疗和管理至关重要。然而,这是一个耗时耗力的困难过程。随着机器学习算法的进步,自动诊断系统有可能加速分类过程、提醒患者并支持医生做出快速准确的决策。在本文中,我们提出了一种新型多路径癫痫发作类型分类深度学习网络 (MP-SeizNet),它由卷积神经网络 (CNN) 和具有注意机制的双向长短期记忆神经网络 (Bi-LSTM) 组成。本研究的目的是仅使用脑电图 (EEG) 数据对特定类型的癫痫发作进行分类,包括复杂部分性、简单部分性、失神性、强直性和强直阵挛性癫痫发作。EEG 数据以两种不同的表示形式输入到我们提出的模型中。 CNN 接收从 EEG 信号中提取的小波特征,而 Bi-LSTM 接收原始 EEG 信号,以便我们的 MP-SeizNet 能够从癫痫发作数据的不同表示中进行联合学习,从而获得更准确的信息学习。我们利用最大的 EEG 癫痫数据库——天普大学医院 EEG 癫痫发作语料库 TUSZ v1.5.2 评估了所提出的 MP-SeizNet。我们使用三重交叉验证对不同患者数据评估了我们提出的模型,并使用五重交叉验证对癫痫发作数据评估了模型,结果分别获得了 87.6% 和 98.1% 的 F1 分数。

多相机3D帕金森氏病的精度评估
帕金森氏病(PD)是一种毁灭性的运动,在全球流行率上加速了,但是缺乏精确的症状测量使得有效疗法的发展具有挑战性。统一的帕金森统一级评级量表(UPDRS)是评估运动症状严重程度的黄金标准,但其手动评分标准含糊不清,既模糊又主观,导致了粗糙和嘈杂的临床评估。机器学习方法有可能通过使PD症状评估现代化,以使其更具定量,客观和可扩展性。但是,缺乏用于PD运动考试的基准视频数据集阻碍了模型开发。在这里,我们介绍了郁金香数据集以弥合此差距。Tulip强调预先挑剔和全面性,包括25种UPDRS运动考试活动的多视频记录(6张摄像机),以及3位临床专家的评级,在帕金森氏症患者和健康对照组中。多视图记录实现了身体运动的3D重建,该重建更好地捕获疾病特征,而不是更多的调用2D方法。使用数据集,我们建立了一个基本线模型,用于预测3D姿势的UPDRS分数,以说明如何自动化现有诊断。展望未来,郁金香可以帮助开发超过UPDRS分数的新的精确诊断,从而深入了解PD及其潜在治疗方法。

标题转移学习基于小儿EEGS多个渠道的癫痫发作检测
摘要 - 癫痫是一种常见的神经系统疾病,其特征是在全球范围内影响多达7,000万人的癫痫发作。在生命的头十年中,每150名儿童中大约有一个被诊断出患有癫痫病。脑电图是诊断癫痫发作和其他脑部疾病的重要工具。但是,脑电图的专家视觉分析很耗时。除了减少专家注释时间外,自动癫痫发作检测方法是帮助专家分析脑电图的强大工具。对小儿脑电图中癫痫发作的自动检测的研究已被提出。深度学习算法通常用于小儿癫痫发作检测方法;但是,它们在计算上很昂贵,并且需要很长时间才能开发。可以使用转移学习来解决此问题。在这项研究中,我们在小儿EEG的多个通道上开发了一种基于转移学习的癫痫发作检测方法。公开可用的CHB-MIT EEG数据集用于构建我们的方法。数据集分为训练(n = 14),验证(n = 4)和测试(n = 6)。从10 s EEG信号产生的具有5 s重叠的频谱图用作三个预训练的传输学习模型(RESNET50,VGG16和InceptionV3)的输入。我们小心翼翼地将孩子分成培训或测试集中,以确保测试集是独立的。基于脑电图测试集,该方法具有85.41%的精度,85.94%的召回率和85.49%的精度。此方法有可能协助研究人员和临床医生对小儿脑电图中癫痫发作的自动分析。

多靶点药物是治疗阿尔茨海默病的潜在药物。一种新的 5-取代基家族
摘要 多靶点药物是治疗阿尔茨海默病的一种有前途的方法。本文描述了一类新的 5-取代吲唑衍生物,它们具有多靶点特性,包括胆碱酯酶和 BACE1 抑制。因此,对一类新的 5-取代吲唑进行了合成和评估。药理学评价包括对 AChE/BuChE 和 BACE1 酶的体外抑制试验。此外,还对 BuChE 进行了相应的竞争研究。此外,还根据 ORAC 测定计算了抗氧化特性。此外,还研究了它们对 Raw 264.7 细胞的抗炎特性和对人神经母细胞瘤 SH-SY5Y 细胞的神经保护作用。药理学测试结果表明,这些 5-取代吲唑衍生物 1 – 4 和 6 中的一些可以同时作为 AChE/BuChE 和 BACE1 抑制剂。此外,一些吲唑衍生物表现出抗炎(3、6)和神经保护(1-4和6)作用,具有抗氧化作用,可对抗A b 诱导的人类神经母细胞瘤SH-SY5Y细胞死亡。

引用了原始发表的论文(记录的版本):Lai,H.,Kannas,C.,Hassen,A。等(2025)。 MEA
我们基于蒙特卡洛树搜索形式主义引入了一种多目标搜索算法,以进行反归结计划。多目标搜索允许将各种目标组合起来,而无需考虑其规模或加权因素。为基于这种新型算法进行基准测试,我们在八个反曲面实验中采用了四个目标。目标范围从基于起始材料和步骤计数的简单目标到基于综合复杂性和路线相似性的复杂范围。我们表明,通过仔细的复杂目标,多目标算法可以优于单目标搜索,并提供更多样化的解决方案。但是,对于许多靶标化合物,单目标设置是等效的。尽管如此,我们的算法为合成计划中的特定应用程序纳入了新的目标。

m3t:使用多平面和多板变压器
在这项研究中,我们提出了使用多平面和多层跨前(M3T)网络的三维医学图像分类器,以在3D MRI图像中对阿尔茨海默氏病(AD)进行分类。提出的网络协同委托3D CNN,2D CNN和变压器用于准确的AD分类。3D CNN用于执行本机3D表示学习,而2D CNN用于利用大型2D数据库和2D代表学习的预训练权重。使用具有感应性偏置的CNN网络有效地提取局部大脑中与AD相关的异常的信息信息。跨前网络还用于获得CNN后多平面(轴向,冠状和矢状)和多切片图像之间的注意力关系。也可以使用不感应偏置的变压器学习分布在大脑中较大区域的差异。在此期间,我们使用了来自阿尔茨海默氏病神经影像学计划(ADNI)的训练数据集,该计划总共包含4,786 3D T1加权MRI图像。对于有效数据,我们使用了来自三个不同机构的数据集:澳大利亚成像,生物标志物和生活方式旗舰研究(AIBL)(AIBL),开放访问Imaging研究(OASIS)的开放访问系列(OASIS)以及来自培训数据集中的一些ADNI数据。我们提出的M3T基于曲线(AUC)下的区域(AUC)和AD分类的分类精度,与常规的3D分类网络相结合。这项研究表示,所构成的网络M3T在多机构验证数据库中实现了最高的性能,并证明了该方法有效地将CNN和Transformer用于3D医学图像的可行性。

多酶的理论和实用方面...
4 5 6 1 D e partme n t o f C he mic a l and Bi o lo g ic a l E ng i nee ri ng , N o rt h w e st e r n U n iv e rsity, 21 4 5 7 Sh e ri da n Road , T e c hno l og ic a l I n stit u t e E 136 , Ev an st on , I L , 60208 , USA 8 9 2 Interdiscipli na ry Bi o l og ic a l Sci ence s Gr adua t e Pr og r a m, N o rt h w e st e r n U n iv e rsity, 2205 10 Tech Drive, 2 - 100 H ogan H a ll, Eva n st on , I L , 60208 , USA 11 12 3 C e nter for Sy n t he tic Bi o l og y, N o rt h w e st e r n U n iv e rsity, 2145 S he ri dan R oad , 13 Technologic a l I n stit u t e B 486 , Ev an st on , I L , 60208 , USA 14 15 4 These aut ho rs c on tri bu t ed equa ll y t o t he w o rk 16 17 Autho r Em a il Add resses : 18 19 C h arl o tt e H A b r aha ms on : c ab r aha ms on@u .no rt h w e st e r n。edu 20 21 brett j pal me r o:b r e tt pa lm e r o2025 @ u。no rt h w e st e r n。edu 22 23 n o l an w k enned y:no l an k enned y2 019@u。no rt h w e st e r n。edu 24
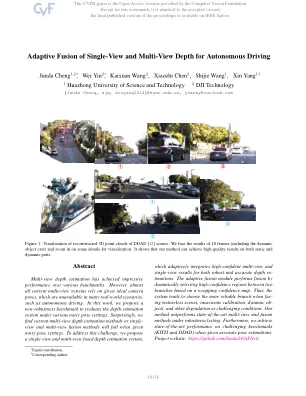
自动驾驶的单视图和多视图深度的自适应融合
来自图像的深度估计是具有广泛应用的计算机视觉中的一个长期问题。对于基于视觉的自动驾驶系统,感知深度是理解道路对象和建模3D环境图的相关性的不可或缺的模块。由于深度神经网络用于求解各种视觉概率,因此基于CNN的方法[2-5,13,39 - 42,44,44,46,48,52]主导了各种深度基准。根据输入格式,它们主要将其分为多视图深度估计[3,13,23,26,44,45,51,53]和单视深度估计[14 - 16,19,37,38]。多视图方法估计深度的假设,即给定的深度,相机校准和摄像头姿势,这些像素应相似。他们依靠表现几何形状来三角形高质量深度。但是,多视图方法的准确性和鲁棒性在很大程度上依赖于相机的几何配置以及视图之间匹配的对应关系。首先,需要足够翻译相机以进行三角度。在自主驾驶的情况下,汽车可能会停在交通信号灯处或不移动而不移动,这会导致故障三角剖分。此外,多视图方法遭受动态对象和无动电区域的影响,它们在自动驱动方案中无处不在。另一个问题是对移动车辆的施加优化。在存在的大满贯方法中不可避免地噪声,更不用说具有挑战性和可取的情况了。具体来说,我们提出了一个两个分支网络,即例如,一辆机器人或自动驾驶汽车可以在不重新校准的情况下部署多年,原因是嘈杂的姿势。相比之下,作为单视图方法[14 - 16,19,37,38]依赖于对场景的语义理解和透视投影提示,它们对无纹理区域,动态对象,而不是依赖相机姿势更为易用。但是,由于规模歧义,其性能仍然远非多视图方法。在这里,我们倾向于考虑是否可以很好地结合两种方法的好处,以实现自主驾驶场景中的稳健和准确的单眼视频深度估计。尽管已经在先前的工作中探索了基于融合的系统[1,9],但他们都假定了理想的相机姿势。结果是融合系统的性能甚至比单视深度估计的噪声姿势还差。为了解决这个问题,我们提出了一个新型的自适应融合网络,以利用多视图和单视图方法的优势,并减轻其缺点,以保持高度的精度,并在噪声姿势下提高系统的影响力。一个靶向单眼深度提示,而另一个则利用多视图几何形状。两个分支都预测了深度图和置信图。补充语义提示和边缘细节在多视图分支的成本汇总中丢失了