
XiaoMi-AI文件搜索系统
World File Search SystemObject
评估对象对象的基于视觉模型的弹性...
摘要。鉴于对最近的基于视觉模型的大规模多模式培训及其概括能力,因此了解其鲁棒性的程度对于他们的现实世界部署至关重要。在这项工作中,我们的目标是评估当前基于视觉模型的弹性,以应对不同的对象到后环上下文变化。大多数鲁棒性评估方法都引入了合成数据集,以引起对物体特征(观点,比例,颜色)的变化或实际图像上使用的图像转换技术(对抗性变化,常见的损坏),以模拟分离中的变化。最近的作品探索了利用大型语言模式和di!使用模型来产生背景变化。但是,这些方法要么缺乏对要进行的更改或扭曲对象语义的控制,从而使它们不适合任务。另一方面,我们的方法可以诱导各种对象兼容地面变化,同时保留对象的原始语义和对象的真实性。为了实现这一目标,我们利用文本对图像,图像到文本和图像对段的生成能力自动生成广泛的对象到背景的变化。我们通过修改文本提示或优化文本模型的潜伏期和Textual嵌入来引起自然和对抗背景的变化。这使我们能够量化背景上下文在理解深神经网络的鲁棒性和一般性中的作用。我们生产了各种版本的标准视觉数据集(Imagenet,Coco),将多样的和相同的背景纳入图像中,或在背景中引入颜色,纹理和对抗性变化。我们进行了彻底的实验,并对基于视觉模型的鲁棒性与对象之间的背景环境之间的鲁棒性进行了深入的分析。我们的代码和评估基准将在https://github.com/muhammad-huzaifaa/ObjectCompose上找到。

引用了原始发表的论文(记录的版本):Tekden,A.,Erdem,A.,Erdem,E。等(2024)。对象和关系中心代表
推动是一项必不可少的非划算操作技能,用于任务,从预抓操作到场景重新排列,关于场景中的对象关系的推理,因此在机器人技术中广泛研究了推动动作。有效使用推动动作通常需要了解受操纵对象的动态并适应预测与现实之间的差异。出于这个原因,在文献中对推动作用进行了效果预测和参数估计。但是,当前方法受到限制,因为它们要么建模具有固定数量对象的系统,要么使用基于图像的表示,其输出不是很容易解释并迅速累积错误。在本文中,我们提出了一个基于图神经网络的框架,以根据触点或关节对对象关系进行建模,以效应预测和参数估计推动操作。我们的框架在真实和模拟环境中都得到了验证,这些环境包含不同形状的多部分对象,这些对象通过不同类型的关节和具有不同质量的对象连接,并且在物理预测上的表现优于基于图像的表示。我们的方法使机器人能够预测并适应其观察场景时推动动作的效果。它也可用于使用从未看过的工具进行工具操作。此外,我们在基于机器人的硬盘拆卸的背景下证明了杠杆起作的6D效应预测。

中华人民共和国国民经济和社会发展第十四个五年规划纲要(2021-2025年)和二〇三五年远景目标
《中华人民共和国国民经济和社会发展第十四个五年规划和二零三五年远景目标纲要》是根据《中共中央关于制定国民经济和社会发展第十四个五年规划和二零三五年远景目标的建议》制定的,它明确了国家的战略意图,明确了政府工作重点,引导和规范了市场主体行为,是中国开启全面建设社会主义现代化国家新征程的宏伟蓝图,是全体中国人民的共同行动纲领。

反对佩勒姆变电站以东的土地上的太阳能农场...
从:库珀发送:2023年3月2日向:第62A节申请<第62a e节 cc:cc:cc:主题:异议:玛格勒·帕勒姆(Pelham)帕勒姆(Pelham)用品的土地上的太阳能农场(Maggots end Manuden) - 申请编号:S62A/202A/0011默认地位,Solar Farm on sil offerm offerm offerm offerm offermant offer nand offers offer nand offer nand offer offer, Manuden-申请编号:S62A/2022/0011我写信,反对申请,以构建一个太阳能农场,该太阳能由地面安装的太阳能阵列以及(除其他外)电池存储,逆变机,一个变电站,围栏,围栏和CCTV摄像机在Pelham pelham beets Maggots Maguden Road Manuden Road Manuden Manouden Road Manuden CM23 CM23 1BJ附近。我的名字叫威廉·库珀
使用脑机接口技术在 Blender 软件中建模 3D 对象
1. 简介 3D 建模是使用专门的计算机程序创建和修改三维对象的过程,该程序为用户提供了一组必要的工具。 3D 建模通常从基本形状(基元)开始,例如立方体、球体、圆环等。然后通过软件提供的不同功能修改这些形状。用户通常通过按下键盘上的组合键或从用户界面中选择它们来激活这些功能。如今,有许多功能强大的 3D 建模软件,可以创建 3D 资源、动画、特效和渲染图像。最受欢迎的付费应用程序是 Autodesk Maya、Autodesk 3ds Max 和 Cinema 4D。也有许多免费应用程序可用,但最受欢迎的应用程序是 Blender。Blender 是一个免费的开源 3D 计算机图形软件工具集。它用 C、C++ 和 Python 编程语言编写。Blender 基金会是一个负责 Blender 开发的非营利组织。 Blender 也是由社区开发的,社区创建了用 Python 编写的附加插件(称为附加组件)。附加组件为 Blender 添加了新功能或改进功能。由于 Blender 发展基金的成立,Blender 最近获得了 Epic Games、Nvidia 或 Intel 的大量资金支持。它使 Blender 基金会能够招募新的团队成员,从而更快地开发 Blender。

Unimode:统一的单眼3D对象检测
实现统一的单眼3D对象检测,包括室内和室外场景,在机器人导航等应用中非常重要。然而,涉及各种数据方案来训练模型引起了挑战,因为它们的特性显着不同,例如,二 - 几何特性和异质域分离。为了应对这些挑战,我们根据鸟类的视图(BEV)检测范式建立了一个检测器,在该检测范式中,当采用多个数据方案以训练检测器时,明确的特征投影有利于对几何学学习模棱两可。然后,我们将经典的BEV检测体系结构分为两个阶段,并提出了不均匀的BEV网格设计,以处理由上述Challenges引起的收敛不稳定。此外,我们开发了稀疏的BEV功能策略,以降低计算成本和处理异质域的统一操作方法。将这些技术结合起来,得出了一个统一的检测器Unimode,它超过了富有挑战性的Omni3D数据集(一个大规模的数据集(一个室内和室外场景))的先前最先进的AP 3D,揭示了Bev bev tor tor tor tor tor tor tor unified 3D对象的第一个成功概括。
g-hop:相互作用重建的生成性手动对象和掌握合成
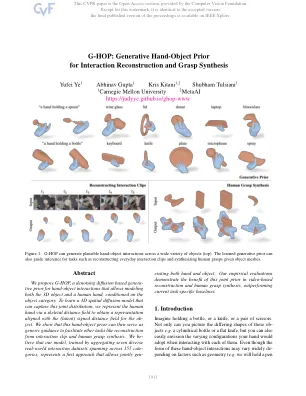
和一个锅的不同)或意图(例如通过刀与使用它进行切割),我们人类可以毫不费力地描绘出与日常生活中日常物体的这种互动。在这项工作中,我们的目标是构建一个可以同样生成合理的手动配置的计算系统。具体来说,我们学习了一个基于扩散的常规模型,该模型捕获了3D相互作用期间手和对象的关节分布。给定一个类别的描述,例如“握着板的手”,我们的生成模型可以合成人手的相对配置和表达(见图1个顶部)。我们解决的一个关键问题是,该模型是什么好的HOI表示。通常通过空间(签名)距离场来描述对象形状,但人的手通常是通过由发音变量控制的参数网格建模的。我们提出了一个均匀的HOI表示,而不是在生成模型中对这些不同的代表进行建模,并表明这允许学习一个共同生成手和对象的3D扩散模型。除了能够合成各种合理的手和物体形状的综合外,我们的扩散模型还可以在跨任务的辅助推理之前作为通用,而这种表示是所需的输出。例如,重建或预测相互作用的问题对于旨在向人类学习的机器人或试图帮助他们的虚拟助手来说是核心重要性。重建的视频重新投影错误)或约束(例如我们考虑了这些行沿着这些行的两个经过深入研究的任务:i)从日常交互剪辑中重建3D手对象形状,ii)鉴于任意对象网格,合成了合理的人类grasps。为了利用学到的生成模型作为推论的先验,我们注意到我们的扩散模型允许在任何手动对象配置给定的(近似)log-likelihood梯度计算(近似)log-likelihoodhoodhood。我们将其纳入优化框架中,该框架结合了先前的基于可能性的指南与特定于任务的目标(例如已知对象网格的合成)推理。虽然理解手动相互作用是一个非常流行的研究领域,但现实世界中的数据集限制了3D中这种相互作用的限制仍然很少。因此,我们汇总了7种不同的现实世界交互数据集,从而导致157个对象类别的相互作用长期收集,并在这些范围内训练共享模型。据我们所知,我们的工作代表了第一个可以共同生成手和对象的生成模型,并且我们表明它允许综合跨类别的各种手动相互作用。此外,我们还经验评估了基于视频的重建和人类掌握合成的任务的先前指导的推断,并发现我们所学的先验可以帮助完成这两个任务,甚至可以改善特定于特定于任务的状态方法。

多视图3D对象检测的多视图actentive上下文化
我们介绍多视图的细心上下文化(MVACON),这是一种简单而有效的方法,用于改善基于查询的多视图3D(MV3D)对象检测中的2D- TO-3D功能。尽管在基于查询的MV3D对象检测的领域取得了显着的进展,但先前的艺术通常会因高分辨率的高分辨率2D特征而缺乏基于密集的注意力提升的高分辨率2D特征,或者由于高计算成本,或者由于3D Queries的高度密集地接地不足,无法以3D Queries的高度质量为基于稀疏注意的多级2D功能。我们提出的MVACON使用代表密集但计算稀疏的细心特征连续化方案击中了两只鸟,该方案对特定的2d到3d feleture提升方法不可知。在实验中,使用BEVFormer及其最近的3D变形注意(DFA3D)变体以及PETR对纳斯曲霉基准进行了彻底的测试,并显示出一致的检测性能提高,尤其是在位置,方向和VELOCITY PRECTICTAR中提高了一致的检测性能。还可以在Waymo-Mini基准测试器上进行测试,并具有类似的改进。我们在定性和定量上表明,基于全局群集的上下文有效地编码了MV3D检测的密集场景级上下文。我们提出的MVA-CON的有希望的结果加强了计算机视觉中的格言 - “(contectu-alsized)特征事项”。
通过对齐已知类表示
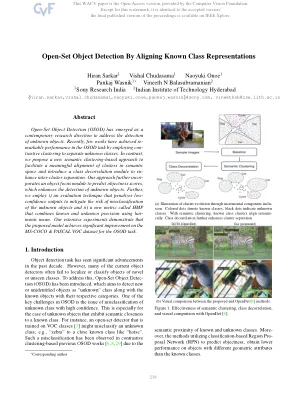
开放式对象检测(OSOD)已成为当代研究方向,以解决对未知对象的检测。最近,很少有作品通过使用Con-Contrastive聚类来分开未知类,在OSOD任务中实现了可观的性能。相比之下,我们提出了一种新的基于语义聚类的方法,以促进语义空间中有意义的群集的对齐,并引入一个类去相关模块以实现群间间的分离。我们的方法进一步不适合对象焦点模块预测对象分数,从而增强了未知对象的检测。此外,我们采用了i)一种评估技术,该技术对低置信度输出进行了惩罚,以减轻对未知对象的错误分类的风险,ii)一种称为HMP的新指标,该指标使用hMP使用Har-nonic Mean结合了已知和未知的精度。我们的广泛实验表明,所提出的模型可以在OSOD任务上对MS-Coco&Pascal VOC数据集有显着改进。

SFOD:脉冲融合物体探测器 - CVF 开放存取
事件相机具有高时间分辨率、高动态范围、低功耗和高像素带宽等特点,为特殊环境中的物体检测提供了独特的功能。尽管有这些优势,事件数据固有的稀疏性和异步性对现有的物体检测算法提出了挑战。脉冲神经网络 (SNN) 受到人脑编码和处理信息方式的启发,为这些困难提供了潜在的解决方案。然而,在当前的实现中,它们在使用事件相机进行物体检测方面的性能受到限制。在本文中,我们提出了脉冲融合物体检测器 (SFOD),一种基于 SNN 的简单有效的物体检测方法。具体而言,我们设计了一个脉冲融合模块,首次实现了应用于事件相机的 SNN 中不同尺度特征图的融合。此外,通过整合我们在 NCAR 数据集上对主干网络进行预训练期间进行的分析和实验,我们深入研究了脉冲解码策略和损失函数对模型性能的影响。从而,我们建立了基于 SNN 的当前最佳分类结果,在 NCAR 数据集上实现了 93.7% 的准确率。在 GEN1 检测数据集上的实验结果表明,SFOD 实现了 32.1% 的当前最佳 mAP,优于现有的基于 SNN 的方法。我们的研究不仅强调了 SNN 在事件摄像机物体检测中的潜力,而且推动了 SNN 的发展。代码可在 https://github.com/yimeng-fan/SFOD 获得。