
XiaoMi-AI文件搜索系统
World File Search SystemVision
使用Pytorch的计算机视觉的初学者指南
要使用Pytorch中的数据增强,您将需要定义一组可以应用于培训数据的转换功能。您还需要确保将转换功能始终应用于输入图像和相应的注释。然后,您可以使用Torchvision.datasets.ObjectDetectionDataSet类使用批次的方式,将这些转换应用于培训数据。
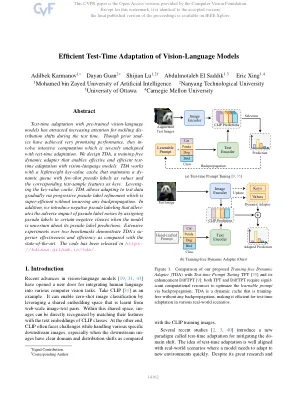
视觉模型的有效测试时间适应
通过预训练的视觉模型进行测试时间适应,引起了越来越多的关注,以应对测试时间的分离转移。尽管事先实现了非常有前途的性能,但它们会进行密集的计算,这与测试时间适应非常不规则。我们设计了TDA,这是一种无训练的动态适配器,可通过视觉模型进行有效,有效的测试时间适应。tda可与轻巧的键值缓存一起使用,该缓存维持具有很少射击伪标签的dy-namic队列作为值,而相应的测试样本特征则是键。杠杆键值缓存,TDA允许通过渐进式伪标签的细化逐渐调整数据,而逐步测试数据,而不会产生任何反向传播。此外,我们引入了负伪标记,即当模型不确定其伪标签预测时,通过将伪标签分配给某些负类时,可以减轻伪标签噪声的不利影响。在两个基准上进行的广泛实验表明,与最先进的艺术品相比,TDA的实体有效性和效率。该代码已在https://kdiaaa.github.io/tda/中发布。
视觉变压器具有分层注意力
摘要:本文解决了香草视觉变压器中与多头自我注意(MHSA)相关的高计算/空间复杂性。为此,我们提出了层次MHSA(H-MHSA),这是一种新颖的方法,以层次的方式计算自我注意力。具体来说,我们首先将输入图像分为通常完成的补丁,每个补丁都被视为令牌。然后,提议的H-MHSA学习本地贴片中的令牌关系,作为局部关系建模。然后,将小斑块合并为较大的贴片,H-MHSA对少量合并令牌的全局依赖性建模。终于,将本地和全球专注的特征汇总为具有强大表示能力的功能。由于我们仅在每个步骤中计算有限数量的令牌的注意力,因此计算负载大大减少。因此,H-MHSA可以在不牺牲细粒度信息的情况下有效地模拟令牌之间的环境关系。与H-MHSA模块合并,我们建立了一个基于层次的变压器网络的家族,即HAT-NET。为了证明帽子网络在场景中的优越性,我们就基本视觉任务进行了广泛的实验,包括图像分类,语义分割,对象titection和实例分段。因此,HAT-NET为视觉变压器提供了新的视角。代码和预估计的模型可在https://github.com/yun-liu/hat-net上找到。

与计算机视觉的深度学习
深度学习和神经网络:多层感知器:多层感知器体系结构,什么是隐藏的层?每一层中有多少层和多少个节点?激活函数:线性传输函数,重型阶跃功能(二进制分类器),sigmoid/logistic函数,软马克斯函数,双曲线切线函数(TANH),整流的线性单元,泄漏的relu。前馈过程:前馈计算,特征学习。错误函数:错误函数是什么?,为什么我们需要一个错误函数?错误总是正面的,均为正方形错误。跨凝性,关于错误和权重优化算法的最终说明:什么是优化?,批处理梯度下降,随机梯度下降,微型批次梯度下降,梯度下降点击。反向传播:什么是反向传播?,反向传播外卖。

气候弹性的旁遮普视觉和行动计划2024
1。水资源:通过保护和保护水资源来增强水安全。改善综合水资源管理,并通过法规和技术措施确保水质。促进气候硫化的水存储和分配基础设施,例如为井,雨水收集和社区池塘。2。生物多样性:制定和实施综合的生物多样性保护计划,以保护和保护高保护价值领域。通过基于生态系统的适应来修复降级的栖息地,并建立新的保护区以确保受威胁生态系统的生存。改善湿地的健康状况(即Ramsar遗址)充当闸门,牧场,牧场和沙漠和保护水生的多样性和栖息地条件。3。改善针对气候诱发灾难的反应:通过优先考虑灾难挽救基础设施来加强气候诱发的灾难管理能力,
语言模型的视觉检查
学习建模字符串之间的关系的学习是什么教授大型语言模型(LLMS)关于Vi-Sual世界的?我们系统地评估了LLMS生成和识别出增加复杂性的各种视觉概念的能力,然后演示如何使用文本模型来培训预先的视觉表示学习系统。由于语言模型缺乏将视觉信息作为像素消耗或输出视觉信息的能力,因此我们使用代码来表示研究中的图像。尽管LLM生成的图像看起来不像自然图像,但图像产生的结果以及模型校正这些固定图像的能力表明,字符串的精确建模可以教授有关Vi-Sual World的许多方面的语言模型。此外,使用文本模型生成的图像进行了自我监督的视觉表示学习的实验,突出了能够训练能够使用LLMS对自然IM的语义评估进行训练视觉模型的潜力。

计算机视觉概论-CS@Cornell
教师名称:和Bharath Hariharan Wei-Chiu MA教师电子邮件:bh497@cornell.edu和wm347@cornell.edu教职员工办公室时间:TBA(请访问课程网站(以获取最新信息的最新信息)课程员工和课程员工办公室时间:此课程将有约20个教学辅助者。次和办公时间的场所将在课程网站上的第一周发布。先决条件/主页:线性代数知识(推荐),编程和概率/统计时间和位置:星期一/星期三/星期五1:25-2:15 PM在Baker Laboratory在Baker Laboratory 200。课程描述本课程将引入计算机视觉的核心问题,并根据图像形成的几何形状和物理学讨论经典方法,并使用深度学习介绍现代技术。主题包括立体和3D重建,图像分割,对象识别,图像和补丁的特征表示以及卷积网络。课程目标/学生学习成果在参加本课程后,学生将能够:

低级视觉任务的语言指南的鲁棒性:深度估算的发现
通过将自然语言纳入附加指导来实现单眼深度估计的最新进展。尽管产生了令人印象深刻的结果,但语言先验的影响,尤其是在发生和鲁棒性方面,仍未得到探索。在此过程中,我们通过量化此之前的影响来解决这一差距,并引入方法以在各种环境中基准其有效性。我们生成“低级”句子,传达以对象为中心的三维空间关系,将它们纳入其他语言先验,并评估其对深度估计的下游影响。我们的关键发现是,当前语言引导的深度估计仅通过场景级别的描述和违反直觉的效果最佳地发挥作用。尽管利用了其他数据,但这些方法对于对抗性攻击并随着分配变化的增加而对性攻击和绩效下降并不强大。fi-nally,为了为未来的研究提供基础,我们识别出失败点,并提供见解以更好地理解这些缺点。使用语言进行深度估算的越来越多的方法,我们的发现突出了需要仔细考虑在现实世界中有效部署的机会和陷阱。1
计算机视觉 / ML工程师实习生< / div>
理想的候选人将具有强大的背景:计算机科学,机械工程,电气工程,生物医学工程或相关领域。如果有兴趣,候选人将暴露于从头开始发展初创公司的各个方面(R&D,光学系统集成和原型化)。工作将主要在我们的马里兰州哥伦比亚办事处进行。工资与经验相称(至少$ 17/hr)。我们的紧密联系的团队很高兴欢迎有才华的申请人并一起发展我们的冒险!
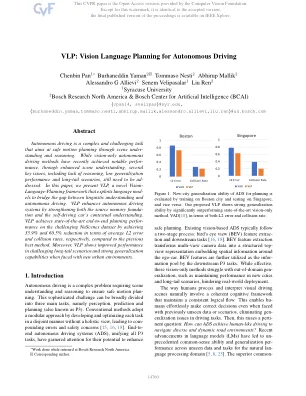
VLP:自主驾驶的视觉语言计划
自主驾驶是一项复杂而具有挑战性的任务,旨在通过场景和推理来实现安全的运动计划。最近,通过增强的场景理解,几个关键问题,包括缺乏推理,低概括性能和长尾场景,但仍需要戴着几个关键问题,但仍需要进行一些关键问题。在本文中,我们提出了VLP,这是一个新颖的视力 - 语言规划框架,利用语言模式来弥合语言理解与自动驾驶之间的差距。VLP通过加强源内存基础和自动驾驶汽车的上下文理解来增强自主驾驶系统。vlp通过与先前的最佳方法相比,分别在平均L2错误和碰撞率方面,分别在平均L2错误和碰撞率方面实现了35.9%和60.5%的端到端规划表演。此外,在面对新的城市环境时,VLP在挑战性的长尾方案和强大的概括能力方面表现出改善的性能。