
XiaoMi-AI文件搜索系统
World File Search SystemBenchmarking
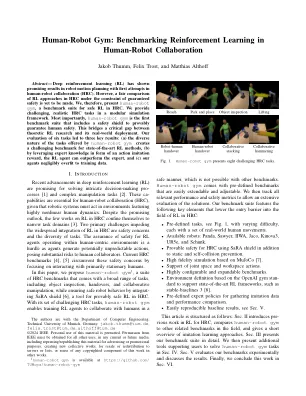
人机健身房:在人机协作中进行基准测试加强学习
摘要 - 深入强化学习(RL)在人机协作(HRC)中首次尝试在机器人运动计划中显示出令人鼓舞的结果。但是,在保证安全的限制下对HRC的RL方法进行了公平的比较。因此,我们现在是人类机器人体育馆,这是HRC安全RL的基准套件。我们在模块化模拟框架中提供具有挑战性的现实HRC任务。最重要的是,人类机器人健身房是第一间基准套件,其中包括安全盾牌,可证明可以保证人体安全。这弥合了理论RL研究与其现实世界部署之间的关键差距。我们对六项任务的评估导致了三个关键结果:(a)人类机器人体育馆提供的任务的多样性为最先进的RL方法创造了一个具有挑战性的基准,(b)利用采取行动模仿奖励的专家知识,RL代理人可以超越专家,以及(C)我们的Angents超越训练数据。

B2B营销美国机构基准报告
该表反映了一系列实体(具有不同的所有权结构),这些实体在多个领土上或通过同一领土内的多个子公司或两者的A组合在大规模的一致品牌下运行。此处列出的大型公司的各种子公司或成员公司可以在美国和/或国际表中分别列出。此处包括三种不同类型的组织:(i)代理团体:较大的实体完全拥有各种子公司,这些子公司通常在单独的品牌身份下进行交易。(ii)网络:会员完全独立,但要订阅成为网络的一部分,或者是由于会员资格而成为网络的一部分。(iii)全球机构:一个单一实体在其自己的品牌下以及潜在的子公司品牌的多个领土交易中运营。
高管薪酬基准评估及建议
Mercer 提出了以下一组总薪酬方案 (TRP) 范围,这些范围基于每个 TRP 范围最大值的澳大利亚一般市场 15 百分位数据。这被认为是一种合理的方法,不会导致维多利亚州高管薪酬发生重大变化。与 2019 年早些时候的审查类似,该框架的设计没有 TRP 范围的重叠。这些范围是根据全面的薪酬基准和分析得出的,并以工作价值(Mercer CED 工作评估系统)为基础,以便于引用当前市场数据和更新范围。

基于基本视觉编程中计算思维测试的生成模型
生成模型已经证明了跨编程,自然科学和一般知识等领域的各种基准标记的人类水平熟练程度。尽管在竞争性基准上有这些有希望的结果,但他们仍然在基本级学生通常执行的看似简单的解决问题的任务方面挣扎。最新模型如何在旨在评估学校计算思维和解决问题技能的标准化测试上执行?在本文中,我们策划了一个新颖的基准测试,该基准涉及基础视觉编程领域中的计算思维测试。我们的最初结果表明,诸如GPT-4O和Llama3之类的最先进模型几乎不符合普通学校学生的表现。为了进一步提高这些模型的性能,我们使用新型的合成数据生成方法对其进行了微调。关键想法是使用符号方法来开发一个综合数据集,该方法捕获不同的技能水平,从识别视觉元素到多选择测验到综合式任务。我们展示了合成数据中符号信息的各个方面如何有助于改善微调模型的性能。我们将发布完整的实施和数据集,以促进有关增强生成模型中计算思维的进一步研究。

纳米孔测序和新西兰快速基因组可行性的基准测试和质量控制:单个第四纪医院的验证阶段
1 Liggins Institute,新西兰奥克兰大学2分子医学与病理学,新西兰奥克兰大学,新西兰3遗传健康服务3遗传健康服务局,奥克兰TE TOKA TUMAI,TE TOKA TUMAI,TE TOKA TUMAI,4 Starship儿童健康澳大利亚墨尔本6墨尔本大学医学,牙科和健康科学学院,澳大利亚墨尔本大学7诊断遗传学,病理学和实验室医学系,TE TOKA TUMAI,奥克兰 *这些作者为这项工作做出了同样的贡献。 ⱡ对应作者:justin.osullivan@auckland.ac.nz1 Liggins Institute,新西兰奥克兰大学2分子医学与病理学,新西兰奥克兰大学,新西兰3遗传健康服务3遗传健康服务局,奥克兰TE TOKA TUMAI,TE TOKA TUMAI,TE TOKA TUMAI,4 Starship儿童健康澳大利亚墨尔本6墨尔本大学医学,牙科和健康科学学院,澳大利亚墨尔本大学7诊断遗传学,病理学和实验室医学系,TE TOKA TUMAI,奥克兰 *这些作者为这项工作做出了同样的贡献。ⱡ对应作者:justin.osullivan@auckland.ac.nz
对自然语言规划的 llms 进行基准测试
我们引入了 N ATURAL P LAN ,这是一个自然语言中的现实规划基准,包含 3 个关键任务:旅行规划、会议规划和日历安排。我们将评估重点放在 LLM 的规划能力上,并提供关于任务的完整信息,方法是将 Google 航班、Google 地图和 Google 日历等工具的输出作为模型的上下文。这样就无需使用工具使用环境来评估规划上的 LLM。我们观察到 N ATURAL P LAN 是针对最先进模型的具有挑战性的基准。例如,在旅行规划中,GPT-4 和 Gemini 1.5 Pro 分别只能实现 31.1% 和 34.8% 的解决率。我们发现,随着问题复杂性的增加,模型性能急剧下降:当有 10 个城市时,所有模型的性能都低于 5%,这凸显了 SoTA LLM 在自然语言规划方面存在巨大差距。我们还对 N ATURAL P LAN 进行了广泛的消融研究,以进一步阐明自我校正、少量泛化和具有长上下文的上下文规划等方法对改进 LLM 规划的 (不) 有效性。
新兴技术基准测试报告
过去几年,人工智能蓬勃发展,各行各业的企业都在将新技术融入员工队伍,以优化现有流程并提高效率。1 根据 Statista 的数据,到 2025 年,全球人工智能 (AI) 软件市场的收入预计将达到 1260 亿美元。2 在众多人工智能技术中,聊天机器人的采用率迅速上升,极大地改变了消费者与人工智能互动的方式。其中包括 ChatGPT、Perplexity AI、Google Gemini 等一系列工具,它们利用人工智能语言处理来实时响应消费者提出的问题和询问。3 《福布斯》杂志报道称,“2023 年 1 月,ChatGPT 的活跃用户达到 1 亿,成为历史上增长最快的应用程序。”4

位置:基准测试在增强学习研究中受到限制
新颖的增强学习算法或对现有的算法进行的改善,通常通过评估其在基准环境上的性能来概括,并将其与不断变化的标准算法集进行比较。但是,尽管有许多需要改进的要求,但经验实践仍会产生误导或不支持的主张。进行不合标准的做法的一个原因是进行严格的基准测试实验需要基本计算时间。这项工作投资了严格的实验设计中计算成本增加的来源。我们表明,严格的性能基准可能会产生通常很重要的计算成本。因此,我们主张使用附加实验范式克服基准测试的局限性。

使用最大基数匹配问题对量子退火进行基准测试
我们对量子退火 (QA) 与模拟退火 (SA) 进行了基准测试,重点关注问题嵌入到 D-Wave 量子退火器的不同拓扑上的影响。我们研究的一系列问题是最大基数匹配问题的特别设计实例,这些问题很容易通过经典方法解决,但对于 SA 来说很难,而且实验发现,对于 QA 也不容易。除了使用多个 D-Wave 处理器外,我们还通过数值求解时间相关的薛定谔方程来模拟 QA 过程。我们发现嵌入问题可能比非嵌入问题困难得多,并且某些参数(例如链强度)对于找到最佳解决方案可能非常有影响。因此,找到良好的嵌入和最佳参数值可以大大改善结果。有趣的是,我们发现尽管 SA 在解决非嵌入问题方面取得了成功,但与我们在 D-Wave 量子退火器上取得的成果相比,嵌入版本获得的 SA 结果相当差。

模拟还是数字内存计算?通过定量建模进行基准测试
摘要 - 内存计算(IMC)已成为边缘的能效,吞吐量和面积的机器学习的有希望的范式。但是,已发表的IMC实现中硬件体系结构,阵列维度和制造技术的差异使得很难掌握它们的相对优势。此外,以前的研究主要集中于探索和台式,标记了单个IMC宏的峰值性能,而不是在实际工作负载上进行完整的系统性能。本文旨在解决对模拟内存计算(AIMC)和数字内存计算(DIMC)处理器体系结构的定量比较的缺乏。我们提出了一个分析性IMC性能模型,该模型已针对已发表的启动进行了验证,并将其集成到系统级勘探框架中,以便对具有不同IMC配置的不同工作负载进行全面的性能评估。我们的实验表明,虽然DIMC通常比AIMC更高,但具有较大宏观尺寸的AIMC比在卷积层和尖端的层中的DIMC具有更好的能量效率,这可以利用高空间传播。另一方面,具有小宏大小的DIMC在深度层上优于AIMC,这在宏内具有有限的空间展开机会。索引术语 - 机器学习,定量建模,模拟内存计算,数字内存计算