
XiaoMi-AI文件搜索系统
World File Search SystemEstimation

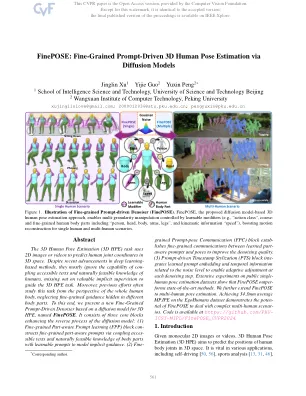
细浓度:通过扩散模型进行细粒度及时驱动的3D人姿势估计
3D人姿势估计(3D HPE)任务使用2D图像或视频来预测3D空间中的人类关节坐标。尽管最新的基于深度学习的方法取得了进步,但它们主要忽略了可访问的文本和自然可行的人类知识的能力,而错过了有价值的隐性监督,以指导3D HPE任务。此外,以前的努力经常从整个人体的角度研究这项任务,从而忽略了隐藏在不同身体部位的细粒度指导。为此,我们基于3D HPE的扩散模型(名为FinePose)提出了一个新的细粒及时驱动的DeNoiser。它由三个核心块组成,增强了扩散模型的反向过程:(1)通过耦合辅助辅助文本和可学习的提示以模拟隐式指南的耦合知识,并通过耦合的辅助辅助文本和自然可行的零件知识,可以通过耦合的辅助辅助文本和自然可行的零件知识来构建精细的部分零件感知的提示。(2)Fine-

使用深...
印度教科技研究所,coimbatore 1 sentinfo@gmail.com,2 venkat.it@gmail.com,4 ramasamy.s@hit.s@hit.edu.in,4 md.devendran@gmail.com摘要:该项目旨在为食品和beverage提供精确估算的自动化系统,以估算食物和beverage的自动化系统,并深入研究。随着对健康意识的人的需求不断增长,需要使用可靠,高效且易于使用的工具,可以帮助用户做出明智的饮食选择。该项目利用图像处理技术和深度学习模型(例如卷积神经网络(CNN))来分析食物图像并预测相应的卡路里含量。该系统首先捕获食品或饮料的图像,然后将其处理并通过预先训练的深度学习模型。该模型在包含各种食品的图像及其营养信息的大型数据集上进行培训。预处理输入图像后,该模型通过利用其学习的特征来对食物进行分类并估算卡路里计数。然后将估计的卡路里值实时显示给用户。该项目利用关键技术,包括图像识别,深度学习和营养分析。它旨在将其集成到移动应用程序或Web平台中,从而使用户可以有效地跟踪其每日热量摄入量。通过在不同的数据集上进行培训,可以不断提高系统的准确性,从而确保对不同食品的可靠卡路里估算。该工具有可能通过促进更健康的饮食习惯来彻底改变个人健康管理。关键词:卡路里估计,深度学习,图像识别,食物分类,卷积神经网络,健康管理,营养分析,实时预测。

ALPINE:利用对比学习改进远程心率估计
心率 (HR) 是人体健康的重要生理指标,可用于检测心血管疾病。传统的 HR 估计方法,例如心电图 (ECG) 和光电容积描记器,需要皮肤接触。由于皮肤接触会增加病毒感染的风险,在正在发生的 COVID-19 大流行中避免使用这些方法。或者,可以使用非接触式 HR 估计技术,即远程光电容积描记器 (rPPG),其中 HR 是根据人的面部视频估计的。不幸的是,现有的 rPPG 方法在面部变形的情况下表现不佳。最近,用于 rPPG 的深度学习网络激增。然而,这些网络需要大规模标记数据才能更好地泛化。为了缓解这些缺点,我们提出了一种方法 ALPINE,即一种新的 L r P PG 技术,用于使用对比学习来改进远程心率估计。 ALPINE 在训练过程中利用对比学习框架来解决标记数据有限的问题,并在数据样本中引入多样性以实现更好的网络泛化。此外,我们引入了一种新颖的混合损失,包括对比损失、信噪比 (SNR) 损失和数据保真度损失。我们的新颖对比损失最大化了来自不同面部区域的 rPPG 信息之间的相似性,从而最大限度地减少了局部噪声的影响。SNR 损失提高了时间信号的质量,数据保真度损失确保提取正确的 rPPG 信号。我们在公开数据集上进行的大量实验表明,所提出的方法 ALPINE 优于以前众所周知的 rPPG 方法。

基于NARX复发神经网络和移动窗口方法的锂离子电池的充电状态估计
摘要准确的充电状态(SOC)估计取决于精确的电池模型。非线性和不稳定干扰因素的影响使准确的SOC估计变得困难。为了获得准确的电池模型,提出了基于NARX(具有外源输入的非线性自回归网络)的方法,提出了复发性神经网络和移动窗口方法。本文从以下三个方面提高了SOC估计的准确性,建模速度和鲁棒性。首先,为了克服对模型训练过程中数据量的过度依赖,使用NARX复发性神经网络来建立电池模型。narx(具有外部输入的非线性自回旋)具有延迟和反馈功能的复发性神经网络可以保留上一刻的输入和输出,并将其添加到下一个时刻的计算中。因此,使用少量数据实现了更好的估计结果;其次,移动窗口方法用于梯度爆炸和NARX模型训练过程中可能发生的梯度消失。第三,通过将其与不同的工作条件和不同温度下的其他方法进行比较,可以验证该模型的有效性。结果表明,所提出的模型具有更高的SOC估计准确性和速度。提出的模型的RMSE性能减少了约65%,并且执行时间缩短了约50%。

低级视觉任务的语言指南的鲁棒性:深度估算的发现
通过将自然语言纳入附加指导来实现单眼深度估计的最新进展。尽管产生了令人印象深刻的结果,但语言先验的影响,尤其是在发生和鲁棒性方面,仍未得到探索。在此过程中,我们通过量化此之前的影响来解决这一差距,并引入方法以在各种环境中基准其有效性。我们生成“低级”句子,传达以对象为中心的三维空间关系,将它们纳入其他语言先验,并评估其对深度估计的下游影响。我们的关键发现是,当前语言引导的深度估计仅通过场景级别的描述和违反直觉的效果最佳地发挥作用。尽管利用了其他数据,但这些方法对于对抗性攻击并随着分配变化的增加而对性攻击和绩效下降并不强大。fi-nally,为了为未来的研究提供基础,我们识别出失败点,并提供见解以更好地理解这些缺点。使用语言进行深度估算的越来越多的方法,我们的发现突出了需要仔细考虑在现实世界中有效部署的机会和陷阱。1
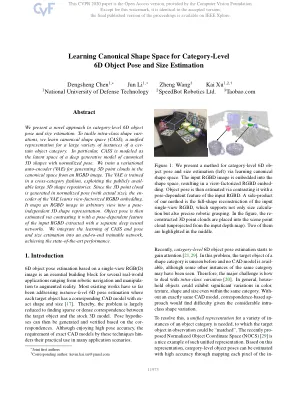
学习典型形状空间以进行类别级 6D 物体姿势和尺寸估计
我们提出了一种类别级 6D 物体姿势和大小估计的新方法。为了解决类内形状变化,我们学习了规范形状空间 (CASS),它是特定物体类别的大量实例的统一表示。具体而言,CASS 被建模为具有规范化姿势的规范 3D 形状的深度生成模型的潜在空间。我们训练变分自动编码器 (VAE) 以从 RGBD 图像在规范空间中生成 3D 点云。VAE 以跨类别的方式进行训练,利用公开可用的大型 3D 形状存储库。由于 3D 点云是以规范化姿势(具有实际大小)生成的,因此 VAE 的编码器学习视图分解的 RGBD 嵌入。它将任意视图中的 RGBD 图像映射到与姿势无关的 3D 形状表示。然后,通过将物体姿势与使用单独的深度神经网络提取的输入 RGBD 的姿势相关特征进行对比来估计物体姿势。我们将 CASS 的学习和姿势和尺寸估计集成到端到端可训练网络中,实现了最先进的性能。
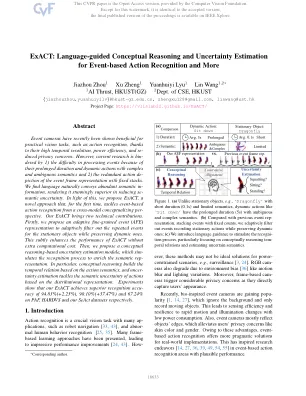
精确:基于事件的行动识别和更多
事件摄像机最近显示出对实用视觉任务的有益,例如行动识别,这要归功于其高度分辨率,功率效率和引起的隐私问题。然而,当前的研究是由1)处理事件的困难,因为它们的持续时间长时间和动态动作具有复杂而模棱两可的语义; 2)事件框架表示带有固定堆栈的冗余作用。我们发现语言自然传达了丰富的语义信息,从而使其在降低疾病的不确定性方面非常出色。鉴于此,我们提出了一种新颖的方法,这是第一次解决基于事件的动作识别的跨模式概念化的识别。我们的确切确切带来了两项技术贡献。首先,我们提出了一个自适应细粒事件(AFE)表示,以自适应地过滤固定对象的重复事件,同时保留动态的对象。这巧妙地增强了精确的性能,而无需额外的计算成本。然后,我们提出了一个基于概念推理的不确定性估计模块,该模块模拟了识别过程以丰富语义代表。尤其是,概念推理基于动作语义建立时间关系,而不必要的估计可以解决基于分布表示的动作的语义不确定性。实验表明,在PAF,HADDV和我们的SEACT数据集上,我们的确切确切识别获得了94.83%(+2.23%),90.10%(+2.23%),90.10%(+37.47%)和67.24%。
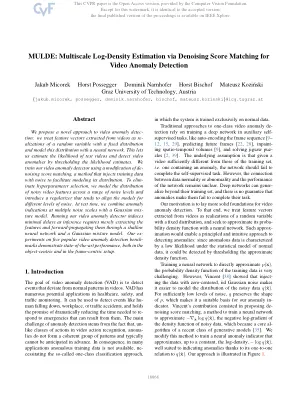
mulde:多尺度对数密度密度通过视频异常检测的DeNoSINGING估算
我们提出了一种新颖的视频异常检测方法:我们将从视频中提取的特征向量视为具有固定分布的随机变量的重新释放,并用神经网络对此分布进行建模。这使我们能够通过阈值估计估计测试视频的可能性并检测视频异常。我们使用DE-NONISE分数匹配的修改来训练视频异常检测器,该方法将训练数据注射噪声以促进建模其分布。为了消除液体高参数的选择,我们对噪声噪声级别的噪声特征的分布进行了建模,并引入了常规化器,该定期用器倾向于将模型与不同级别的噪声保持一致。在测试时,我们将多个噪声尺度的异常指示与高斯混合模型相结合。运行我们的视频异常检测器会引起最小的延迟,因为推理需要仅提取特征并通过浅神经网络和高斯混合模型将其前向传播。我们在五个流行的视频异常检测台上的典范表明了以对象为中心和以框架为中心的设置中的最先进的性能。
实习飞行软件、计算机视觉和人工智能 瑞士苏黎世 公司:Daedalean 是一家总部位于苏黎世的初创公司,由前谷歌和 SpaceX 工程师创立,他们希望在未来十年内彻底改变城市航空旅行。我们结合计算机视觉、深度学习和机器人技术,为飞机开发最高级别的自主性(5 级),特别是您可能在媒体上看到的电动垂直起降飞机。如果您加入我们的实习,您将有机会与经验丰富的工程师一起工作,他们来自 CERN、NVIDIA、伦敦帝国理工学院或……自治系统实验室本身。您将构建塑造我们未来的尖端技术。最重要的是,我们还提供在瑞士阿尔卑斯山试飞期间与我们的飞行员一起飞行的机会。项目:不同的团队都提供机会。我们希望更多地了解您,以及我们如何让您的实习成为双方宝贵的经历。告诉我们您一直在做什么,以及您想在我们的团队中从事什么工作。它与深度学习有关吗?状态估计?运动规划?计算机视觉?或者其他什么?向我们展示您的热情所在。如果我们可以在您想要从事的领域提供指导和有趣的机会,我们将一起敲定细节。资格:强大的动手 C++ 经过验证的解决问题的能力如何申请:将您的简历/履历发送至 careers@daedalean.ai 。电话
实习飞行软件、计算机视觉和人工智能瑞士苏黎世公司:Daedalean 是一家总部位于苏黎世的初创公司,由前谷歌和 SpaceX 工程师创立,他们希望在未来十年内彻底改变城市航空旅行。我们结合计算机视觉、深度学习和机器人技术,为飞机开发最高级别的自主性(5 级),特别是您可能在媒体上看到的电动垂直起降飞机。如果您加入我们的实习,您将有机会与经验丰富的工程师一起工作,他们来自 CERN、NVIDIA、伦敦帝国理工学院或……自治系统实验室本身。您将构建塑造我们未来的尖端技术。最重要的是,我们还提供在瑞士阿尔卑斯山试飞期间加入我们飞行员的机会。项目:不同团队提供机会。我们想更多地了解您,以及如何让您的实习成为双方宝贵的经历。告诉我们你一直在做什么,以及你想在我们的团队中从事什么工作。它与深度学习有关吗?状态估计?运动规划?计算机视觉?或者别的什么?向我们展示你的热情所在。如果我们可以在你想从事的领域提供指导和有趣的机会,我们将一起敲定细节。资格: 强大的动手 C++ 证明解决问题的能力 如何申请: 将您的简历/履历发送至 careers@daedalean.ai 。请告诉我们一些关于您自己的信息,为什么您认为自己适合我们以及为什么我们适合您。