
XiaoMi-AI文件搜索系统
World File Search SystemInteract
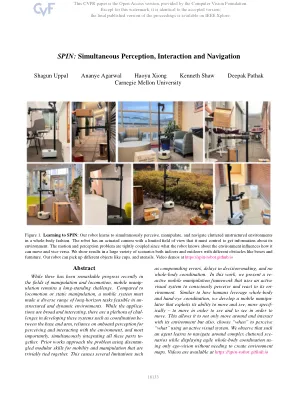
旋转:同时感知交互和导航
最近在操纵和运动领域取得了显着进展,但移动操作仍然是一个长期以来的挑战。与运动或静态操纵相比,移动系统必须在非结构化和动态环境中可行的多种长距离任务。尽管应用程序广泛且有趣,但在开发这些系统(例如基础和手臂之间的协调)时,有很多挑战,依靠在船上感知到感知和与环境互动,最重要的是,同时整合了所有这些部分。先前的作品使用模块化技能来解决问题,以使其动机和操纵被微不足道地捆绑在一起。这引起了多个限制

类比设计中人与人工智能的交互协同创造力
简介 十一年前,马希尔 (Maher) 问道:“谁在创造?” (Maher 2012),并提出了几个创造性应用的分析空间,包括构思和互动两个维度。马希尔的问题引出了乔丹诺斯 (Jordanous) 的 PPP 视角框架,其中创造行为可以由人类或人工智能 (Jordanous 2016) 执行,以及坎托萨洛 (Kantosalo) 和塔卡拉 (Takala) 的 5C 框架,其中创造行为由人类和人工智能共同组成的集体执行 (Kantosalo and Takala 2020)。1然而,对于人与人工智能互动中创造力的位置,人们的共识较少。混合主动性创造性界面方法提出了一组基本的细粒度活动,这些活动可以由人类或人工智能以某种结构化对话的形式执行(Deterding 等人,2017 年;Spoto 和 Oleynik,2017 年),随后扩展到生成应用(Muller、Weisz 和 Geyer,2020 年),针对特定算法方法进行了改进(Grabe、Duque 和 Zhu,2022 年),并针对其他算法方法进行了批评(Zheng,2023 年)。虽然这些方法生成了重叠的分析动作词汇,但它们并没有解决创造力在何处发生(以及由谁或什么通过这些动作发生)的问题。在这篇短文中,我们提供了对该问题的一个答案的几个例子。我们重新利用 Kantosalo 和 Takala (2020) 的 5C 中的集体概念,提出一种类型的创造力可能会在以下互动空间中不对称地出现 (Rezwana and Maher 2022)

AI和Human-AI互动医学和医疗保健
“ AI的准确而复杂的图片(与其流行的描述竞争)在开始时,由于难以钉住人工智能的精确定义而受到阻碍。……奇怪的是,缺乏精确的,普遍接受的人工智能定义可能帮助该领域以不断加剧的速度发展,开花和前进。AI的从业人员,研究人员和开发人员的指导下是一种粗略的方向感,并且必须“继续下去”。尽管如此,定义仍然很重要,而尼尔斯·尼尔森(Nils J. Nilsson)提供了一个有用的定义:“人工智能是致力于使机器变得聪明的活动,而智能是使实体能够在其环境中适当和远见的质量。” [1]” [2]

有形用户界面在人类计算机交互中的关键作用
摘要。人类计算机的交互已从命令行演变为图形,直至有形的用户界面(TUI)。tuis代表了将物理对象纳入数字环境中的新范式,以便为用户提供更丰富,更自然和直观的互动手段。本文回顾了TUIS在认知人体工程学,教育和行业中的应用,并特别强调了TUI在减少认知负荷以及改善保留率和增强解决问题的行为方面可能产生的潜在影响。它涵盖了TUI认知益处的各种案例研究,分布式和体现的认知,可伸缩性和可访问性问题的框架,减少技术障碍以及用户不情愿的方法以及TUI与IoT合并的方式。作者还讨论了TUI如何在智能环境中的网络和控制方面看到巨大的改进。从上述内容中,尽管Tuis承诺与常规GUI有关的巨大好处,但在不同应用程序中的全面利用要求解决成本,适应性和包容性的广泛使用。

通过交互式3D代创建想要的东西
最近进步[20,29,30]中的2D图像结构,以方法为例,例如在广泛的文本图像配对数据集中受过训练的扩散模型(例如,Laion-series [31]),在与文本提示符的一致性图像中取得了显着的前进。尽管取得了成功,但实现对图像产生的精确控制以满足复杂的用户期望仍然是严重的挑战。ControlNET [38]通过在特定条件数据集上进行微调修改Foun-odation-2D扩散模型来解决此问题,从而提供由用户特异性输入引导的微妙控制机制。另一方面,尽管有希望的进展[27,35],但与2D图像生成中遇到的那些相比,3D对象的生成更为复杂。al-尽管从透视感中观察到了进步,包括直接3D数据集[10,25]上的3D扩散模型,以及将2D扩散率提升到3D复位(例如NERF [21])通过SDS损失的技术优化[27],没有完全对生成Ob-Ob-ob-ob-ob-jects的控制。对初始文本提示或2D参考图像的依赖严重限制了发电的可控性,并且通常会导致质量较低。文本提示缺乏准确传达复杂3D设计的特异性;尽管2D参考图像可以告知3D重建,但它们并没有捕获3D结构的完整深度,可能导致各种意外的人类。此外,基于2D图像的个性化缺乏直接3D操纵可以提供的灵活性。这些障碍表明需要采取不同的策略。实现可控制的3D发电的直接想法是将控制网络调整为3D生成。但是,该策略遇到了重大障碍:(i)3D的控制信号本质上更为复杂,这使得与2D范式相比,有条件的3D数据集对构成的3D数据集进行了挑战; (ii)3D域中没有强大的基础模型,例如2D [20]的稳定扩散,阻碍了此时开发微调技术的可能性。结果,我们倾向于

铅主导的超精细相互作用影响卤化物钙钛矿中的载流子自旋动力学
其在光伏应用领域的研究引起了人们的兴趣,因为它们的量子效率已经达到了 25.5% [1],而且还扩展到辐射传感 [2,3] 和各种光电设备。[4–7] 达到高质量 MAPbI 3 、FAPbI 3 和 CsPbI 3 单晶的极限,与 MA、FA 和铯 (Cs) 阳离子混合物的组合结构成为最先进的钙钛矿材料,提高了量子效率并将结构稳定性从几天延长到几个月。[2,8–10] 由于基本物理性质接近其母结构,因此所提出的 FA 0.9 Cs 0.1 PbI 2.8 Br 0.2 可作为铅卤化物钙钛矿类的有效模型系统。与传统的 III-V 和 II-VI 半导体相比,钙钛矿在某种意义上具有反转的能带结构:价带 (VB) 态由 s 轨道形成,而导带 (CB) 态由 p 轨道贡献。强自旋轨道耦合,特别是 Rashba 效应 [11–14] 也会交换电子和空穴的自旋特性。[15,16] 因此,与晶格核的超精细相互作用由空穴而不是电子主导。钙钛矿能带结构为光学跃迁提供了清晰的极化选择规则,因此结合
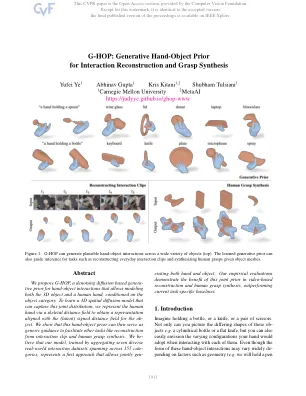
g-hop:相互作用重建的生成性手动对象和掌握合成
和一个锅的不同)或意图(例如通过刀与使用它进行切割),我们人类可以毫不费力地描绘出与日常生活中日常物体的这种互动。在这项工作中,我们的目标是构建一个可以同样生成合理的手动配置的计算系统。具体来说,我们学习了一个基于扩散的常规模型,该模型捕获了3D相互作用期间手和对象的关节分布。给定一个类别的描述,例如“握着板的手”,我们的生成模型可以合成人手的相对配置和表达(见图1个顶部)。我们解决的一个关键问题是,该模型是什么好的HOI表示。通常通过空间(签名)距离场来描述对象形状,但人的手通常是通过由发音变量控制的参数网格建模的。我们提出了一个均匀的HOI表示,而不是在生成模型中对这些不同的代表进行建模,并表明这允许学习一个共同生成手和对象的3D扩散模型。除了能够合成各种合理的手和物体形状的综合外,我们的扩散模型还可以在跨任务的辅助推理之前作为通用,而这种表示是所需的输出。例如,重建或预测相互作用的问题对于旨在向人类学习的机器人或试图帮助他们的虚拟助手来说是核心重要性。重建的视频重新投影错误)或约束(例如我们考虑了这些行沿着这些行的两个经过深入研究的任务:i)从日常交互剪辑中重建3D手对象形状,ii)鉴于任意对象网格,合成了合理的人类grasps。为了利用学到的生成模型作为推论的先验,我们注意到我们的扩散模型允许在任何手动对象配置给定的(近似)log-likelihood梯度计算(近似)log-likelihoodhoodhood。我们将其纳入优化框架中,该框架结合了先前的基于可能性的指南与特定于任务的目标(例如已知对象网格的合成)推理。虽然理解手动相互作用是一个非常流行的研究领域,但现实世界中的数据集限制了3D中这种相互作用的限制仍然很少。因此,我们汇总了7种不同的现实世界交互数据集,从而导致157个对象类别的相互作用长期收集,并在这些范围内训练共享模型。据我们所知,我们的工作代表了第一个可以共同生成手和对象的生成模型,并且我们表明它允许综合跨类别的各种手动相互作用。此外,我们还经验评估了基于视频的重建和人类掌握合成的任务的先前指导的推断,并发现我们所学的先验可以帮助完成这两个任务,甚至可以改善特定于特定于任务的状态方法。
关于互动艺术的一些考虑
总结本文探讨了专注于互动性的艺术和技术领域的实践,尤其是互动艺术。 div>我们研究了与互动艺术相关的关键概念,例如互动者的作用,互动美学,娱乐性特征和关系架构师以及其他要素。 div>为此,我们考虑了莫里斯·贝纳诺(Maurice Benayoun),Studio azzurro,Marcel-líAntunezRoca和Rafael Lozano-Hemmer等艺术家的互动作品。 div>此外,我们质疑具有暂时的计算机技术,尤其是涉及人造轻度的计算机技术的定义。 div>我们试图通过促进互动概念及其对当前技术进步的反应来促进当前辩论的贡献,其响应于当前的技术进步,这些技术涵盖了一系列旨在模仿人类认知功能的系统。 div>最终,我们提供了有关互动艺术的观点,目的是有助于对艺术和技术中的互动性进行更广泛的了解,作为一种系统性,视觉,技术和美学体验。 div>

植物 - 感染真菌相互作用
1植物医疗系,安登国立大学,安东斯36729,大韩民国; smvahsan@gmail.com 2 Applied Biosciences,Kyungpook国立大学,Daegu 41566,大韩民国; inmamumrassel@gmail.com(m.i.-u.-h.); ashim@knu.ac.kr(a.k.d.)3植物与土壤科学系,美国德克萨斯州科技大学基因组学研究所,德克萨斯理工大学,德克萨斯州拉伯克,美国德克萨斯州79409; mrahman@bsmrau.edu.bd 4 4602,杜姆基杜姆基Patuakhali科学技术大学昆虫学系8602; mahiimam@pstu.ac.bd 5 5 Kumho Life Science Laboratory,Chonnam国立大学,Gwangju 61186,大韩民国; ncpaulcnu@gmail.com 6大加工大学大麻生物技术学院,朝鲜共和国安东斯36729 *通信:hwchoi@anu@anu.ac.kr3植物与土壤科学系,美国德克萨斯州科技大学基因组学研究所,德克萨斯理工大学,德克萨斯州拉伯克,美国德克萨斯州79409; mrahman@bsmrau.edu.bd 4 4602,杜姆基杜姆基Patuakhali科学技术大学昆虫学系8602; mahiimam@pstu.ac.bd 5 5 Kumho Life Science Laboratory,Chonnam国立大学,Gwangju 61186,大韩民国; ncpaulcnu@gmail.com 6大加工大学大麻生物技术学院,朝鲜共和国安东斯36729 *通信:hwchoi@anu@anu.ac.kr

双AI:用于群体活动识别的双路径参与者交互学习
学习多个参与者之间的时空关系对于群体活动识别至关重要。不同的群体活动通常会展示视频中参与者之间的多样化互动。因此,从时空参与者演化的单一视角来建模复杂的群体活动往往很困难。为了解决这个问题,我们提出了一个独特的双路径参与者交互 (Dual-AI) 框架,它以两种互补的顺序灵活地排列空间和时间变换器,通过整合不同时空路径的优点来增强参与者关系。此外,我们在 Dual-AI 的两个交互路径之间引入了一种新颖的多尺度参与者对比损失 (MAC-Loss)。通过帧和视频级别的自监督参与者一致性,MAC-Loss 可以有效区分单个参与者表示,以减少不同参与者之间的动作混淆。因此,我们的 Dual-AI 可以通过融合不同参与者的这些判别特征来增强群体活动识别。为了评估所提出的方法,我们在广泛使用的基准上进行了大量实验,包括排球 [ 21 ]、集体活动 [ 11 ] 和 NBA 数据集 [ 49 ]。所提出的 Dual-AI 在所有这些数据集上都实现了最佳性能。值得注意的是,所提出的 Dual-AI 使用 50% 的训练数据,其性能优于许多近期使用 100% 训练数据的方法。这证实了 Dual-AI 在群体活动识别方面的泛化能力,即使在有限监督的具有挑战性的场景下也是如此。