
XiaoMi-AI文件搜索系统
World File Search SystemLanguage
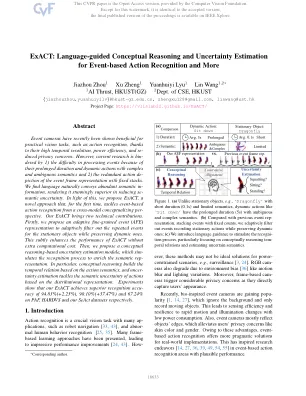
精确:基于事件的行动识别和更多
事件摄像机最近显示出对实用视觉任务的有益,例如行动识别,这要归功于其高度分辨率,功率效率和引起的隐私问题。然而,当前的研究是由1)处理事件的困难,因为它们的持续时间长时间和动态动作具有复杂而模棱两可的语义; 2)事件框架表示带有固定堆栈的冗余作用。我们发现语言自然传达了丰富的语义信息,从而使其在降低疾病的不确定性方面非常出色。鉴于此,我们提出了一种新颖的方法,这是第一次解决基于事件的动作识别的跨模式概念化的识别。我们的确切确切带来了两项技术贡献。首先,我们提出了一个自适应细粒事件(AFE)表示,以自适应地过滤固定对象的重复事件,同时保留动态的对象。这巧妙地增强了精确的性能,而无需额外的计算成本。然后,我们提出了一个基于概念推理的不确定性估计模块,该模块模拟了识别过程以丰富语义代表。尤其是,概念推理基于动作语义建立时间关系,而不必要的估计可以解决基于分布表示的动作的语义不确定性。实验表明,在PAF,HADDV和我们的SEACT数据集上,我们的确切确切识别获得了94.83%(+2.23%),90.10%(+2.23%),90.10%(+37.47%)和67.24%。

MADTP:多模式对准引导的动态令牌修剪,以加速视力 - 语言变压器
视觉 - 语言变压器(VLT)最近显示出巨大的成功,但同时伴随着大量的计算成本,其中主要原因可以归因于大量的视觉和语言令牌。存在用于压缩VLTS的令牌修剪研究主要遵循基于单模式的方案,但忽略了对齐不同模态来指导令牌修剪过程的关键作用,从而导致重要的代币在另一个模态分支中错误地修剪一个模态。同时,现有的VLT修剪作品也缺乏基于不同输入样本动态压缩每一层的灵活性。为此,我们提出了一个名为M Ultodal的新颖框架,用于加速变化VLT的木质制成d ynamic t ynamic t oken p Runing(MADTP)。具体来说,我们首先引入了精心设计的多模式对齐指导(MAG)模块,该模块可以使相同语义概念的特征与不同的模式相结合,以确保修剪的代币对所有模式都不太重要。我们进一步设计了一种新型的dy-namic令牌修剪(DTP)模块,该模块可以根据不同的输入实例自适应地调节每个层中的令牌压缩比。对各种基准测试的广泛实验表明,MADTP可以显着确定多种模型的计算复杂性,同时保留竞争性能。值得注意的是,当将MADTP应用于NLVR2数据集中的BLIP模型时,可以将GFLOPS降低80%,而性能降低少于4%。该代码可在https://github.com/double125/madtp上找到。
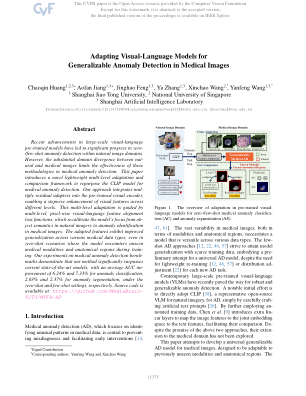
调整视觉语言模型以实现医学图像中的通用异常检测
大规模视觉语言预训练模型的最新进展已在自然图像领域中的零样本/少样本异常检测方面取得了重大进展。然而,自然图像和医学图像之间巨大的领域差异限制了这些方法在医学异常检测中的有效性。本文介绍了一种新颖的轻量级多级自适应和比较框架,以重新利用 CLIP 模型进行医学异常检测。我们的方法将多个残差适配器集成到预训练的视觉编码器中,从而实现不同级别视觉特征的逐步增强。这种多级自适应由多级、逐像素的视觉语言特征对齐损失函数引导,将模型的重点从自然图像中的对象语义重新校准到医学图像中的异常识别。调整后的特征在各种医学数据类型中表现出更好的泛化能力,即使在模型在训练期间遇到看不见的医学模态和解剖区域的零样本场景中也是如此。我们在医学异常检测基准上进行的实验表明,我们的方法明显优于当前最先进的模型,在零样本和少样本设置下,异常分类的平均 AUC 改进分别为 6.24% 和 7.33%,异常分割的平均 AUC 改进分别为 2.03% 和 2.37%。源代码可从以下网址获取:https://github.com/MediaBrain-SJTU/MVFA-AD
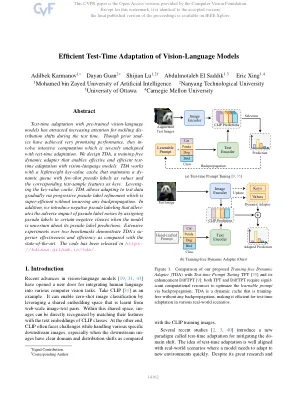
视觉模型的有效测试时间适应
通过预训练的视觉模型进行测试时间适应,引起了越来越多的关注,以应对测试时间的分离转移。尽管事先实现了非常有前途的性能,但它们会进行密集的计算,这与测试时间适应非常不规则。我们设计了TDA,这是一种无训练的动态适配器,可通过视觉模型进行有效,有效的测试时间适应。tda可与轻巧的键值缓存一起使用,该缓存维持具有很少射击伪标签的dy-namic队列作为值,而相应的测试样本特征则是键。杠杆键值缓存,TDA允许通过渐进式伪标签的细化逐渐调整数据,而逐步测试数据,而不会产生任何反向传播。此外,我们引入了负伪标记,即当模型不确定其伪标签预测时,通过将伪标签分配给某些负类时,可以减轻伪标签噪声的不利影响。在两个基准上进行的广泛实验表明,与最先进的艺术品相比,TDA的实体有效性和效率。该代码已在https://kdiaaa.github.io/tda/中发布。

欧洲通用语言数据空间
欧盟自 2019 年以来一直在实施其数据战略。1 面向工业的数据单一市场的一个关键组成部分是建立“可互操作的数据空间”以“汇集关键行业的欧洲数据”,在这个市场中“数据可以在欧盟内部和跨行业流动,造福所有人”、“欧洲规则 […] 得到充分尊重”并且“数据访问和使用规则公平、实用和明确”。欧盟委员会(2022 年)描述了一个初步的、相当粗略的概念,包括如何建立和运营这些数据空间,包括相关立法(另见 Nagel 和 Lycklama,2021 年)。该文件还列出了一些针对制造业、交通、医疗、金融、能源、农业和技能等行业的“官方”欧盟数据空间。由数字欧洲计划 (DEP) 2 中的采购合同资助的欧洲通用语言数据空间 (LDS) 就是这些官方欧盟数据空间之一。 3
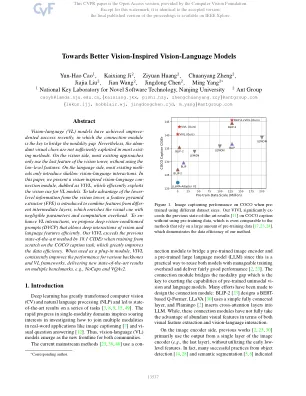
朝着更好的视力启发的视觉语言模型
视觉语言(VL)模型最近取得了未经证实的成功,其中连接模块是弥合模式差距的关键。尽管如此,在大多数存在方法中,富裕的视觉线索尚未充分利用。在视觉侧,大多数现有方法仅使用视觉塔的最后一个功能,而无需使用低级功能。在语言方面,大多数现有的方法仅引入浅视力互动。在本文中,我们提出了一个视觉启发的视觉语言连接模块,称为VIVL,该模块有效利用了VL模型的视觉提示。为了利用视觉塔中的较低级别信息,引入了特征金字塔提取器(FPE),以结合不同中间层的特征,该特征将视觉提示与可忽略不计的参数和计算在头顶上。为了实现VL相互作用,我们提出了深视觉条件的提示(DVCP),可以有效地进行视觉和语言特征的深层互动。我们的VIVL超过了以前的最新方法,当时是18.1苹果酒在从头开始训练可可字幕任务,这极大地提高了数据效率。当用作插件模块时,VIVL始终提高各种骨干和VL框架的性能,在多个基准测试中提供新的最新结果,例如Nocaps和VQAV2。

歌剧:通过过度信托的惩罚和转录分配
幻觉是对多模态大语言模型(MLLM)的普遍挑战的幻觉,极大地阻碍了他们需要精确判断的真实用法。现有方法可以通过特定设计的数据进行培训,或通过其他来源的特定知识来缓解此问题,从而产生了不可避免的额外费用。在本文中,我们提出了一种新型的MLLM解码方法,该方法基于o-vertust pe nalty和r eTroptoction-llocation策略,它是一种几乎免费的午餐,可以减轻幻觉问题,并没有其他数据,知识,知识或培训。我们的方法始于一个有趣的观察结果,即,大多数幻觉与自我注意力矩阵所表现出的知识聚集作用紧密相关,即MLLM倾向于通过关注一些摘要的代价来产生新的代币,但并非所有以前的代币。这种部分过度信任的倾向会导致忽略图像令牌,并用幻觉描述图像内容。基于观察结果,Opera在梁搜索解码过程中引入了对模型逻辑的惩罚术语,以使Miti-Gate the Trust问题以及回滚策略回顾了在预先生成的令牌中存在摘要令牌的存在,并在必要必要时重新分配给标记。通过广泛的实验,Opera在不同的MLLM和指标上表现出明显的幻觉降低性能,证明其有效性和性质。我们的代码为:https://github.com/shikiw/opera。
