
XiaoMi-AI文件搜索系统
World File Search SystemOffline
价值学习真的是离线RL中的主要瓶颈吗?
摘要虽然模仿学习需要访问高质量的数据,但原则上应以类似或更好的方式在数据质量下进行类似或更好的表现。但是,当前的结果表明,离线RL的性能通常比模仿学习差,而且通常不清楚是什么避免了离线RL的表现。在这项工作中,我们旨在了解当前离线RL算法中的瓶颈。虽然离线RL的表现较差通常是在不完美的价值函数上表现出来,但我们还是问:在学习价值函数,策略或其他内容时,离线RL的主要瓶颈确实是真正的瓶颈吗?为了回答这个问题,我们对(1)价值学习,(2)策略提取和(3)脱机RL问题的策略概括从每个组件的“数据尺度”属性中分析,分析了这些组件如何影响性能。我们进行了两个令人惊讶的观察。首先,选择性提取算法的选择会影响离线rl Sigig的性能和可伸缩性,通常比其基本价值学习目标更重要。例如,广泛使用的价值加权回归目标(例如AWR)无法完全利用学习的价值函数,并且切换到行为调节的策略梯度目标(例如DDPG+BC)通常会导致性能和缩放行为的实质性改善。其次,离线RL的次优性能通常是由于对培训数据的支持,而不是分布状态的策略准确性。虽然大多数当前的离线RL算法并未明确解决此问题,但我们表明,使用次优的但高覆盖范围的数据或即时的策略提取技术可以有效解决实践中的策略概括问题。
大型状态空间中的离线增强学习
在经验(深)RL研究中确实是这种情况,在这种情况下,算法通过与模拟环境相互作用与样品数据轨迹相互作用,从而发现了近乎最佳的策略。这里的目标非常明确:使用给定数量的计算找到一个良好的策略,其中包括算法的成本和模拟器的采样数据的成本。While this paradigm has led to impressive successes in difficult simulation tasks [ 75 , 87 ], it becomes increas- ingly clear that the above paradigm is insufficient for many potential applications we hope to apply RL to, in- cluding adaptive clinical trials [ 112 , 113 , 79 , 74 ], rec- ommendation systems and customer relationship manage- ment [ 114 , 1 ], online education [ 12 , 64 ], and 更多的。上述情况的一个共同点是,人类/用户/学生是“环境”的一部分,很难为人类的心理/生物学方面提出准确的模拟器。其中 -

学习通过离线加强学习从观察中控制自主舰队
摘要 - 按需(AMOD)系统的自主移动性是一种不断发展的运输方式,其中中央协调的自动驾驶汽车的舰队动态地服务了旅行请求。这些系统的控制通常被称为一个大型网络优化问题,而增强学习(RL)最近已成为解决该领域中开放挑战的一种有前途的方法。最近的集中式RL方法专注于从在线数据中学习,而忽略了实际运输系统中的每样本相互作用。为了解决这些限制,我们建议通过离线强化学习的镜头正式对AMOD系统进行正式控制,并使用仅离线数据学习有效的控制策略,这很容易为当前的移动性运营商提供。我们进一步研究了设计决策,并根据现实世界中移动性系统的数据提供了经验证据,表明了离线学习如何恢复(i)(i)(i)与在线方法表现出相同的AMOD控制策略,(ii)允许样品有效的在线微调和(iii)消除复杂的模拟环境的需求。至关重要的是,本文表明,离线RL是在经济临界系统(例如迁移率系统)中应用基于RL的SO的有希望的范式。
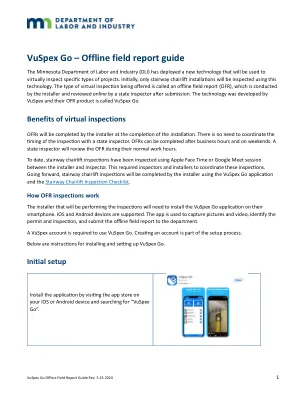
VuSpex Go 离线现场报告指南 修订版 5.23.2024
明尼苏达州劳工和工业部 (DLI) 部署了一项新技术,该技术将用于虚拟检查特定类型的项目。最初,只有楼梯升降椅安装将使用该技术进行检查。所提供的虚拟检查类型称为离线现场报告 (OFR),由安装人员进行,提交后由州检查员在线审查。该技术由 VuSpex 开发,他们的 OFR 产品称为 VuSpex Go。

通过离线增强学习中的一阶状态动态增强价值函数估计
在离线增强学习(RL)中,通过离散时间钟形方程更新值函数通常会由于可用数据范围有限而遇到挑战。这种限制源于Bellman方程,该方程无法准确预测未访问的状态的价值。为了解决这个问题,我们引入了一种创新的解决方案,该解决方案桥接了连续和离散的RL方法,利用了它们的优势。我们的方法使用离散的RL算法从数据集中得出值函数,同时确保该函数的第一个衍生衍生物与汉密尔顿 - 雅各布·贝尔曼在连续RL中定义的状态和动作的局部特征与状态和动作的局部特征一致。我们为确定性策略梯度方法和随机性政策梯度方法提供了实用算法。在D4RL数据集上进行的实验显示,合并一阶信息可显着改善离线RL问题的政策性能。

Q值正规变压器用于离线加固学习
离线增强学习(RL)的最新进步强调了条件序列建模(CSM)的功能,该范例是一种基于历史轨迹和目标返回的范式,该范式学习了动作分布。然而,由于单个轨迹内的采样回报之间的不一致和在多个轨迹之间的最佳回报之间的不一致,这些方法通常与将最佳轨迹缝合在一起的最佳轨迹拼接在一起。幸运的是,动态编程方法(DP)方法通过利用价值函数来近似每个状态的最佳未来回报,提供解决方案,而这些技术容易出现不稳定的学习行为,尤其是在长期和稀疏回报的情况下。在这些见解的基础上,我们提出了Q值重新授权的变压器(QT),该变压器(QT)结合了变压器的轨迹建模能力与DP方法的最佳未来回报的可预测性。QT学习一个动作值函数,并将最大化行动值的术语整合到CSM的培训损失中,该损失旨在寻求与行为政策紧密相符的最佳动作。对D4RL基准数据集的经验评估证明了QT优于传统的DP和CSM方法,这突出了QT在离线RL中增强最新艺术的潜力。
离线政策学习的深层生成模型
深层生成模型(DGM)在各个领域都表现出了巨大的成功,尤其是在使用离线数据训练的模型生成文本,图像和视频方面。同样,数据驱动的决策和机器人控制也需要从离线数据中学习发电的功能,以作为策略或政策。在这种情况下,在离线政策学习中应用深层生成模型具有巨大的潜力,并且在这个方向上进行了许多研究。但是,该领域仍然缺乏全面的审查,因此不同分支机构的发展相对独立。在本文中,我们提供了有关深层生成模型用于离线政策学习的应用的首次系统审查。,我们涵盖了五个主流深层生成模型,包括变量自动编码器,生成的对抗网络,正常的流量,变压器和扩散模型,以及它们在离线增强学习(离线RL)和模仿学习(IL)中的应用。离线RL和IL是离线政策学习的两个主要分支,是依次决策的广泛方法。值得注意的是,对于每种基于DGM的离线政策学习,我们根据DGM的使用来提炼其基本方案,CateGo-size相关工作,并在该领域中整理算法的开发过程。在主要内容之后,我们提供了有关深层生成模型和离线政策学习的深入讨论,作为摘要,我们介绍了我们对未来研究方向的观点。1这项工作为离线政策学习深度生成模型的研究进度提供了动手参考,并旨在激发改进基于DGM的离线RL或IL算法的改进。为方便起见,我们在https://github.com/lucascjysdl/dgms-forline-policy-learning上维护纸张列表。
通过反优化的离线增强学习
摘要。受到跨各个应用领域的反相反优化(IO)的最新成功的启发,我们提出了一种新型的离线增强学习(ORL)算法,用于连续状态和动作空间,利用IO文献中的凸损失函数,称为“凸丢失函数”。为了减轻在ORL问题中通常观察到的分布变化,我们进一步采用了强大的,非毒性模型预测控制(MPC)专家,使用来自模型不匹配的内在信息来指导动力学的名义模型。与现有文献不同,我们强大的MPC专家享有确切且可拖延的凸重新印象。在这项研究的第二部分中,我们表明,受提议的凸损失功能培训的IO假设类别具有丰富的表现力,并且在使用Mujoco基准的低DATA基准中的最先进的方法(SOTA)方法进行了竞争性绩效,同时使用了三个较少的资源,需要很少有参数,几乎需要。为了促进结果的可重复性,我们提供了实施提出算法和实验的开源软件包。
使用不准确的模拟器改善离线增强学习
摘要 - 离线增强学习(RL)提供了一种有希望的方法,以避免与真实环境的昂贵在线互动。但是,离线RL的性能高度取决于数据集的质量,这可能会导致学习过程中的外推错误。在许多机器人范围内,通常可以使用不准确的模拟器。但是,由于众所周知的探索 - 剥削困境以及不准确的模拟和真实环境之间的动态差距,直接从不准确的模拟器收集的数据不能直接用于离线RL中。为了解决这些问题,我们提出了一种新颖的方法,以更好的方式将离线数据集和不准确的仿真数据组合在一起。具体来说,我们预先训练了生成对抗网络(GAN)模型,以适合离线数据集的状态分布。给出了这一点,我们从发电机提供的分布开始,从不准确的模拟器中收集数据,并使用鉴别器重新重量模拟数据。我们在D4RL基准测试中的实验结果和现实世界中的操纵任务确认,我们的方法可以从不准确的模拟器和有限的离线数据集中受益更多,以比先进的方法获得更好的性能。
通过恢复策略
摘要 - 离线目标条件的强化学习(GCRL)的目的是通过脱机数据集的稀疏重新解决目标解决目标任务。虽然先前的工作已经阐明了代理商学习近乎最佳策略的各种方法,但在处理复杂环境(例如安全限制)中处理各种约束时,这些方法会遇到限制。其中一些方法优先考虑目标,而无需考虑安全性,而其他方法则以牺牲培训效率为代价而过度关注安全性。在本文中,我们研究了限制离线GCRL的问题,并提出了一种称为基于恢复的监督学习(RBSL)的新方法,以完成具有各种目标的安全至关重要的任务。为了评估方法性能,我们基于具有随机定位的障碍物的机器人提取环境建立基准测试,并使用专家或随机策略来生成离线数据集。我们将RBSL与三种离线GCRL算法和一种离线安全RL算法进行比较。结果,我们的方法在很大程度上可以执行现有的最新方法。此外,我们通过将RBSL部署在真正的熊猫机械手上来验证RBSL的实用性和有效性。代码可在https://github.com/sunlighted/rbsl.git上找到。