
XiaoMi-AI文件搜索系统
World File Search SystemVision

后端工程|计算机视觉-Jesse Brizzi
在Scala/C ++中构建和部署的高性能计算机视觉和建议服务,使用CAFFE/MXNET处理500m+每月请求。●社交媒体SaaS平台的后端Scala开发。AWS微服务堆栈。●研究并发布了生产计算机视觉分类和检测模型。●创建和托管的专有数据集用于培训深度学习模型
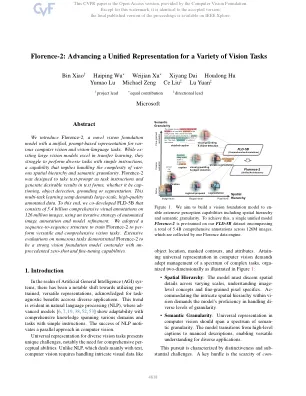
佛罗伦萨-2:推进各种视觉任务的统一代表
我们介绍了Florence-2,这是一个新型视觉基础模型,具有统一的,及时的代表,用于量级计算机视觉和视觉语言任务。在转移学习方面表现出色时,他们努力通过简单的说明执行各种任务,这意味着处理各种空间层次结构和语义粒度的复杂性。Florence-2旨在将文本推出作为任务说明,并以文本形式产生理想的结果,无论是限制,对象检测,接地还是分割。这种多任务学习设置需要大规模的高质量注释数据。为此,我们使用自动化图像注释和改进的迭代策略,共同开发了1.26亿张图像的FLD-5B。我们采用了一个序列结构,以训练佛罗伦萨-2,以执行多功能和全面的视觉任务。对众多任务的广泛评估表明,佛罗伦萨-2是具有未曾预性零击和微调功能的强大愿景基础模型竞争者。


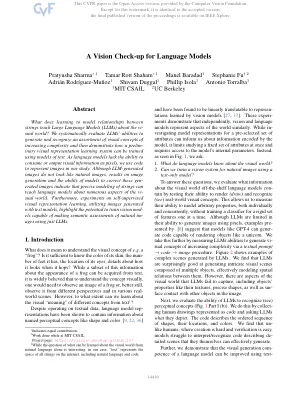
语言模型的视觉检查
学习建模字符串之间的关系的学习是什么教授大型语言模型(LLMS)关于Vi-Sual世界的?我们系统地评估了LLMS生成和识别出增加复杂性的各种视觉概念的能力,然后演示如何使用文本模型来培训预先的视觉表示学习系统。由于语言模型缺乏将视觉信息作为像素消耗或输出视觉信息的能力,因此我们使用代码来表示研究中的图像。尽管LLM生成的图像看起来不像自然图像,但图像产生的结果以及模型校正这些固定图像的能力表明,字符串的精确建模可以教授有关Vi-Sual World的许多方面的语言模型。此外,使用文本模型生成的图像进行了自我监督的视觉表示学习的实验,突出了能够训练能够使用LLMS对自然IM的语义评估进行训练视觉模型的潜力。

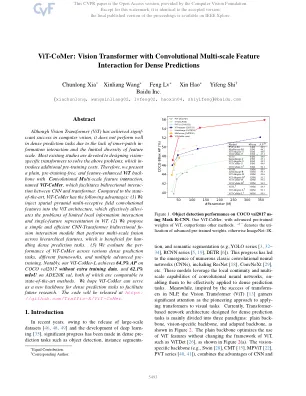
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。

与计算机视觉传感的语义通信用于边缘视频传输
摘要 - 尽管在边缘应用中广泛采用了视力传感器,例如监视,视频数据的传输会消耗大量频谱资源。Semantic Communication(SC)通过在语义层面提取和压缩信息,提供传输数据的准确性和相关性,同时大大减少传输信息的量,从而提供了解决方案。但是,由于缺乏感应能力,传统的SC方法由于在边缘视频中反复传输静态帧而面临效率低下,这会导致频谱效率低下。为了应对这一挑战,我们建议使用计算机视觉传感(SCCV)框架进行EDGE视频传输的SC。框架首先引入了压缩比(CR)自适应SC(CRSC)模型,能够根据帧是静态还是动态的,能够调整CR,并有效地保存光谱资源。此外,我们实施了一个对象检测和语义分割模型启用的传感(OSMS)方案,该方案可以智能地感知场景中的变化并通过封闭式分析评估每个帧的重要性。因此,OSMS方案根据实时感应结果为CRSC模型提供CR提示。此外,CRSC和OSM都设计为轻量级型号,可确保与实用边缘应用中常用的资源受限传感器的兼容性。实验模拟验证了所提出的SCCVS框架的有效性,证明了其提高传输效率的能力而无需牺牲关键的语义信息。
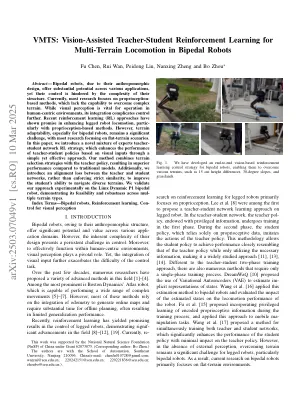
vmts:双皮德机器人中多刺运动的视觉辅助教师增强学习
摘要 - 双方机器人由于其拟人化设计,在各种应用中提供了巨大的潜力,但其结构的复杂性阻碍了它们的控制。当前,大多数研究都集中在基于本体感受的方法上,这些方法缺乏克服复杂地形的能力。虽然视觉感知对于在以人为中心的环境中运作至关重要,但其整合使控制进一步复杂化。最近的强化学习(RL)方法已经显示出在增强腿部机器人运动方面的希望,特别是基于本体感受的方法。然而,地形适应性,尤其是对于两足机器人,仍然是一个重大挑战,大多数研究都集中在平坦的情况下。在本文中,我们介绍了专家教师网络RL策略的新型混合物,该策略通过一种简单而有效的方法来增强基于视觉投入的教师策略的绩效。我们的方法将地形选择策略与教师政策结合在一起,与传统模型相比,表现出色。此外,我们还引入了教师和学生网络之间的一致性损失,而不是强制实施相似之处,以提高学生驾驶各种地形的能力。我们在Limx Dynamic P1 Bipedal机器人上实验验证了我们的方法,证明了其跨毛线地形类型的可行性和鲁棒性。索引术语 - Bipedal机器人,增强学习,视觉感知的控制

在非洲对在线暴力极端主义的计算机视觉和建立弹性:虚假新闻检测的计算机愿景
在2007年仅1%(经济与和平研究所,2022年)。在非洲,与世界其他地区一样,技术创新一直塑造了冲突的动力。在计算和人工智能的发展方面的进步(AI)对推进暴力极端主义(VE)产生了广泛的影响(海德堡国际冲突研究所(HIIK),2022年; RAN,2021年)。一个典范,合成的计算机音频和所谓的深色假货继续捕捉到计算机图形和计算机视觉社区的想象力,同时,对技术的访问的民主化,可以创建一个可以创建任何人说话的任何人的访问权限,因为任何人都会继续关注任何事情,因为它会担心它的力量,因为它会破坏民主竞选活动,并宣布了大型竞选活动,并宣布了大型范围,并宣布了大型范围,企业范围是企业,企业范围是企业,企业范围是企业,企业范围是企业,企业范围是企业,企业范围是企业,企业范围是企业,企业范围是企业,企业范围是狂热的狂热狂热狂欢。意识形态(Agarwal,Farid,El-Gaaly和Lim,2020年; Crawford,Keen和Suarez De-Tangil,2020年)。人们不仅可以在线聊天室,游戏平台和其他在线开放式和黑暗的空间在线访问恐怖分子和极端分子的恐怖分子和极端分子的目标,而且现在可以更容易地将他们访问综合视频和那些放大暴力意识形态的人的综合视频(RAN,2021; Albahar,2017年)。通过人工智能,社交世界已成为算法,这些算法不是读取情感或面部,而是结构化的数据,可以包含在数据文件中的列表。这越来越多地是数码相机的工作。这与隶属于ISIS的非洲其他极端主义团体没有什么不同。远没有生成图像,数码相机产生的产品不仅是标准化的数据文件,其中包含数据读取器可以显示图像的数据,而且除了指定如何读取文件以及可能包含其内容的缩略图预览外,还可以启用打开标签,以及geotags,timestamps,timestamps和creptiations corpor,and timeStamps和cratecro crous和sergriations copo和sercriations coper和其他cortiation copo和sercriatiation copo和sercriations coper和其他运营(我的含量) Al。,2021)。Gambetta和Hertog先前的伊斯兰国家(ISIS)案例研究表明,工程师和技术专家在暴力的伊斯兰极端主义者中占据了由人工智能驱动的计算机视觉以推动暴力极端主义推动的计算机视觉的暴力伊斯兰极端主义者(Muro,2017年)。因此,如果可以将新技术用于错误的课程,那么它可能对人类造成的危害比人类造成的弊大于利,尤其是计算机算法,这些计算机算法可能不符合编程所需的道德规范,或者是由AI驱动的,而与人类可以区分对与错不同。由于新技术不会消失,因此需要建立人类的能力来应对其有害影响。因此,拟议的一章提供了计算机愿景的分析以及如何在非洲对在线VE建立弹性。