
XiaoMi-AI文件搜索系统
World File Search Systemforce

HCAI Health Workerforce许可续签调查
•针灸委员会•脊椎治疗委员会委员会a脊骨疗法针灸o脊骨疗法的内科医师o整脊神经病o脊骨疗法儿科o脊骨疗法o脊骨疗法康复治疗•职业治疗委员会o驾驶和社区活动能力o环境改变o喂食,饮食,吞咽o o生物学o低视力o心理健康o心理健康o小儿康复o身体康复o学校系统o o其他o拒绝降低验光委员会•验光委员会•角膜委员会和接触管理委员

建议:通过限制“敏感执法”例外(RTP)
目前,联邦执法机构发布的公共用例清单尚未履行其透明度和问责制。例如,司法部的2022披露由一页信息组成,列出了联邦调查局单一使用AI,以用于“威胁进气处理系统”以分析犯罪技巧。2,该单页没有关于联邦调查局使用面部识别技术的信息,尽管该局已经将这种AI驱动的技术用于刑事调查已有近十年了。3同样,其他多个司法部执法机构对面部识别的使用零披露 - 从DEA到ATF,再到美国元帅 - 即使最近的政府问责办公室(GAO)审计报告了这些机构中每个机构对这项技术的大量使用。4,尽管DOJ在2023年更新了其披露,但其他一些用例中仍然不包括这些子代理中任何一个的使用面部识别。5也没有与使用车牌读取器使用有关的任何披露。

全球动员气候变化的G20工作组
2。我们理解并承认气候变化的紧迫性和严重性。认识到我们的全部努力将比其各个部分的总和更强大,因此我们将合作并加入为针对气候变化的全球动员而努力。我们重申了巴黎协定的温度目标,即使全球平均温度升高到摄氏2摄氏度低于工业前水平以下,并采取努力将温度升高限制在工业前水平以上的1.5摄氏度,并认识到这将显着降低气候变化的风险和影响。我们强调,与2摄氏度相比,在温度升高1.5摄氏度时,气候变化的影响将要低得多,并重申我们的决心,以限制限制温度升高到1.5摄氏度。3。注意我们的领导角色,我们重申我们的坚定承诺,以追求INFCCC的目标,通过加强巴黎协定的全面有效实施,反映出公平和共同但分化的责任和各自能力的原则,以应对不同的民族环境,以应对气候变化。我们重申了我们在本世纪中期或左右实现全球净零温室气体排放/碳中立性的承诺,并互相鼓励以全国范围的方式提出净零温室气体排放/气候中性承诺,并考虑到巴黎协定以及我们的不同民族环境,道路和方法。4。我们将对下面提到的GST-1结果做出积极响应。我们欢迎并完全赞成迪拜气候变化会议的雄心勃勃,平衡的结果(COP28),特别是根据《巴黎协定》(GST-1),阿联酋的共识及其首个全球股票。5。我们回忆起GST 1决策的第28段,该款进一步认识到需要与1.5°C的途径相一致的温室气体排放的深度,快速和持续的减少,并呼吁当事人以巴黎的同意及其不同的民族环境和临近:

Agentforce的Visual AI自动化
1。当用户等待代理人等待时,他们被要求提交基本信息和视觉上的问题。2。vrai分析图像并报告制造,模型,状态和其他视觉诊断,并将所有信息发送给Salesforce3。当代理接听电话时,向他们显示了VRAI的见解,因此它们可以更快,更轻松地解决该问题。
通过反强化学习的学徒学习
我们考虑在马尔可夫决策过程中学习,在马尔可夫决策过程中,我们没有明确地赋予重新功能,但是我们可以在这里遵守专家,以展示我们想学习的任务。此设置在应用程序(例如驾驶任务)中很有用,很难写下明确的奖励功能,以准确地指定应如何交易不同的desiderata。我们认为专家试图最大程度地发挥奖励功能,该奖励功能可作为已知功能的线性组合,并给出了一种学习专家所展示的任务的算法。我们的al-gorithm基于使用“逆增强学习”来试图恢复未知的奖励功能。我们表明,我们的算法终止了少数迭代,即使我们可能永远无法恢复专家的奖励功能,算法的策略也将达到与专家接近的绩效,在此,在此,相对于Expt exptt的未知奖励函数,在这里可以衡量。
基于a-lyapunov的诉讼 - 诉讼 - > ...
Abstract In many real-world reinforcement learning (RL) problems, besides optimizing the main objective function, an agent must concurrently avoid violating a number of constraints.In particular, besides optimizing performance, it is crucial to guar- antee the safety of an agent during training as well as deployment (e.g., a robot should avoid taking actions - exploratory or not - which irrevocably harm its hard- ware).To incorporate safety in RL, we derive algorithms under the framework of constrained Markov decision processes (CMDPs), an extension of the standard Markov decision processes (MDPs) augmented with constraints on expected cu- mulative costs.Our approach hinges on a novel Lyapunov method.We define and present a method for constructing Lyapunov functions, which provide an ef- fective way to guarantee the global safety of a behavior policy during training via a set of local linear constraints.Leveraging these theoretical underpinnings, we show how to use the Lyapunov approach to systematically transform dynamic programming (DP) and RL algorithms into their safe counterparts.To illustrate their effectiveness, we evaluate these algorithms in several CMDP planning and decision-making tasks on a safety benchmark domain.Our results show that our proposed method significantly outperforms existing baselines in balancing con- straint satisfaction and performance.
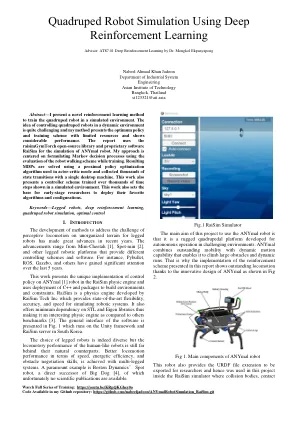
使用深钢筋的四倍的机器人模拟...
摘要 - 我提出了一种新颖的增强学习方法,用于在模拟环境中训练四足机器人。在动态环境中控制四足机器人的想法非常具有挑战性,我的方法提出了最佳的政策和培训方案,资源有限,并且表现出色。该报告使用RaisimgyMtorch开源库和专有软件Raisim进行模拟Anymal机器人。我的方法以训练时的机器人步行方案的评估为中心,以制定马尔可夫决策过程。使用在Actor-Critic模式下使用的近端策略优化算法来解决结果的MDP,并使用一台台式机收集了数千个状态转换。这项工作还提出了一个控制器方案,该计划在模拟环境中显示了数千个时间步骤。这项工作还为早期研究人员提供了他们喜欢的算法和配置的基础。
使用交叉注意信号对大型语言模型进行微调模型的一种自我监督的强化学习方法
我们为不依赖于人类反馈的大型语言模型(LLMS)提出了一种新颖的增强学习(RL)框架。相反,我们的方法使用模型本身中的交叉注意信号来获得自我监督的奖励,从而指导对模型策略的迭代微调。通过分析模型在生成过程中如何“参加”输入提示,我们构建了及时的覆盖,重点和连贯性的度量。然后,我们使用这些措施来对候选响应进行排名或评分,提供了奖励信号,鼓励模型产生良好的一致,主题文本。在与标准策略梯度方法的经验比较和合成偏好模型的RL微调中,我们的方法在非RL基线的迅速相关性和一致性方面显示出显着的提高。虽然它尚未与完全监督的RLHF系统的性能相匹配,但它突出了使用最小的人类标记来扩展对齐的重要方向。我们提供了详细的分析,讨论潜在的局限性,并概述了将基于跨注意的信号与较少人类反馈相结合的未来工作。

LGA -PLN -001_CRUISE AV(BOLT) - 执法互动计划-05.2024
Cruise AV的标志是其安全的硬件传感器套件,在外部可见。传感器套件不会在外部共享信息,不会通过云数据处理来跟踪或以任何身份保留第三方。这种传感器阵列使Cruise AV能够收集有关其环境的信息并告知系统的驾驶决策。在AV的后备箱内是组成系统“大脑”的计算机,并迅速综合了硬件套件收集的信息,以通过感知(了解环境),预测(评估给定环境的可能的安全路径或轨迹)和控制驾驶(驾驶驾驶员)(评估可能的安全路径或轨迹)。有关巡航自主系统如何工作的更多信息,并在此处的2022 Cruise安全报告中提供了一个安全的驾驶员。

人工神经网络/增强学习
ex Cathedra讲座和微型注射器。ex catherdra:主要思想带有黑板上呈现的幻灯片和计算。每周都会为一次课堂运动中断前大教堂的讲座。讲座的第二部分需要此练习的结果。其他练习是作为家庭作业进行的,或者可以在第二个锻炼时间进行混乱。讲座也被几个简短的测验打断。miniProject:小型设备是在两个组成的团队中完成的,并从两个或三个小型设备的列表中选择。