
XiaoMi-AI文件搜索系统
World File Search SystemCamera

bevcar:bev地图和对象分割的摄像机雷达融合
摘要 - 从鸟类的视图(BEV)角度来看,语义场景细分在促进移动机器人的计划和决策方面起着至关重要的作用。尽管最近仅视力的方法表现出了显着的性能进步,但它们通常在不利的照明条件下(例如降雨或夜间)挣扎。虽然主动传感器为这一挑战提供了解决方案,但激光雷达的高成本仍然是一个限制因素。将摄像机数据与汽车雷达融合起来是更便宜的替代方法,但在先前的研究中受到了较少的关注。在这项工作中,我们旨在通过引入Bevcar(一种新型的BEV对象和地图细分方法)来推动这一有希望的途径。我们方法的核心新颖性在于首先学习原始雷达数据的基于点的编码,然后将其利用以有效地将图像特征抬起到BEV空间中。我们对Nuscenes数据集进行了广泛的实验,并证明Bevcar优于当前的技术状态。此外,我们表明,合并雷达信息显着提高了挑战性环境条件中的鲁棒性,并提高了远处对象的细分性能。为了培养未来的研究,我们提供了实验中使用的Nuscenes数据集的天气拆分,以及http://bevcar.cs.uni-freiburg.de的代码和训练有素的模型。
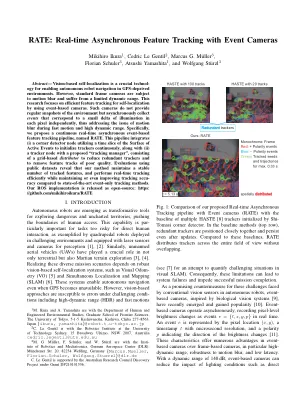
速率:带有事件摄像机的实时异步跟踪
摘要 - 基于视觉的自定位是一种至关重要的技术,用于在GPS剥夺环境中实现自主机器人导航。但是,标准帧摄像机会受到运动模糊的影响,并且动态范围有限。这项研究着重于使用基于事件的摄像机进行自定义的有效特征跟踪。这样的摄像机不提供环境的常规快照,而是异步收集与每个像素中每个像素中一小部分照明的事件,从而解决了在快速运动和高动态范围内运动模糊问题的问题。特别是,我们提出了一个基于连续的实时异步性异步跟踪管道,名为速率。此管道集成了(i)使用活动事件表面的时间切片连续初始化跟踪器,以及(ii)带有建议的“跟踪管理器”的跟踪器节点,由基于网格的分销商组成,以减少冗余跟踪器并删除差质量差的质量。使用公共数据集进行评估表明,我们的方法保持了稳定的跟踪功能,并且与仅限的事件跟踪方法相比,在维护甚至改进跟踪准确性的同时,进行实时跟踪有效。我们的ROS实施以开放源为:https://github.com/mikihiroikura/rate
bafusion:基于LIDAR和摄像机的3D对象检测的双向注意融合
摘要:3D对象检测是自动驾驶和机器人技术的一项具有挑战性且有前途的任务,从LIDAR和相机等多传感器融合中受益匪浅。传感器融合的常规方法依赖于投影矩阵来对齐LiDAR和相机的特征。但是,这些方法通常遭受灵活性和鲁棒性不足,从而在复杂的环境条件下导致对齐精度降低。解决这些挑战,在本文中,我们提出了一个新型的双向注意融合模块,该模块名为Bafusion,该模块有效地使用跨注意力从激光雷达和照相机中融合了信息。与常规方法不同,我们的浮雕模块可以自适应地学习跨模式的注意力,从而使方法更加灵活和健壮。从2D Vision中的高级注意优化技术中汲取灵感,我们开发了集合的线性注意融合层(CFLAF层),并将其集成到我们的小管道中。该层优化了注意机制的计算复杂性,并促进了图像和点云数据之间的高级相互作用,展示了一种新的方法来解决跨模式注意计算的挑战。我们使用各种基线网络(例如Pointpillars,Second和A Part-A 2)在KITTI数据集上评估了我们的方法,并在这些基准线上表现出了3D对象检测性能的一致改进,尤其是对于骑自行车的人和骑行者等较小的对象。我们的方法在Kitti基准测试中取得了竞争成果。

工业热摄像机产品目录
Being a solution provider to public sectors, industries, and commercial markets, we provide a rich portfolio of intelligent photoelectric sensing products, which are widely used in the smart industry, smart robots, gas detection imaging, fire fighting and safety, green energy, carbon neutrality, environmental protection, healthcare, etc.雷德克技术(Raythink Technology)承担着提高智能光电传感技术进步的使命,它集成了光电和智能技术,以不断为客户创造增量价值,并为建立安全,节能和环保的社会做出贡献。

1像素相机可以走多远?使用光感受器和计算设计的视觉形态解决视力任务
1。简单的视觉传感器在求解视觉任务方面有多有效?2。他们的设计在有效性中扮演什么角色?我们探索具有低至一对一像素的分辨率的简单传感器,代表单个光感受器。首先,我们证明,只有几个光感受器就足以求解不同的vi-sion任务,例如视觉导航和连续控制,即相当好,即,其性能明显优于盲人代理,并与高分辨率摄像头相当。第二,我们表明这些简单的视觉传感器的设计在提供有用信息并成功解决这些任务的能力中起着至关重要的作用。为了找到一个表现出色的设计,我们提出了一种计算设计优化算法,并评估了其在不同任务和域之间的有效性,显示出令人鼓舞的结果。最后,我们进行了一项人类调查,以评估人类手动手动设计的直觉设计的有效性,这表明在大多数情况下,计算设计的设计是最好的设计之一。

将预训练的视觉模型适应相机原始图像
摘要。SRGB图像现在是计算机视觉研究中预训练视觉模型的主要选择,这是由于它们的易用性和效果存储。同时,原始图像的优点在于它们在可变的现实世界中的较丰富的物理信息。对于基于相机原始数据的计算机视觉任务,大多数现有研究采用了将图像信号处理器(ISP)与后端网络集成的方法,但经常忽略ISP阶段和后续网络之间的相互作用功能。从NLP和CV区域中正在进行的适配器研究中汲取灵感,我们介绍了Raw-Adapter,这是一种旨在将SRGB预先训练的模型调整为相机原始数据的新颖方法。RAW-ADAPTER包括输入级适配器,这些适配器采用可学习的ISP阶段来进行AD-RAW输入,以及模型级别的适配器,以在ISP阶段和随后的高级网络之间建立连接。此外,Raw-Adapter是一个可以在各种Compoter Vision Frameworks中使用的通用框架。在不同的照明条件下进行了丰富的实验,已经显示了我们算法的最先进(SOTA)绩效,证明了其在一系列现实世界和合成数据集中的有效性和效率。代码可在此URL上找到。

学习一个动态隐私的相机鲁棒性反转攻击
摘要。设计了设计隐私相机(PPC)的问题。以前的设计依赖于静态点扩展功能(PSF),以防止检测私人视觉信息,例如可识别的面部特征。但是,可以通过测量对点光源的摄像机响应来轻松恢复PSF,从而使这些相机容易受到PSF反转攻击的影响。提出了一种新的动态隐私(Dypp)摄像头设计,以防止此类攻击。dypp摄像机依赖于动态的光学元素,即这种空间光模拟器来实现随时间变化的PSF,该PSF随着图片的变化而变化。PSF是通过学习的嵌入式嵌入,对手进行的,以同时满足用户指定目标的隐私目标,例如面部识别准确性和任务效用。对多种隐私视力任务的经验评估表明,与以前的PPC相比,Dypp设计对PSF反转功能的强大意义要大得多。此外,该方法的硬件可行性由概念验证摄像头模型验证。


事件摄像机使用异步时空 - ...
与常规摄像机相比,事件摄像机代表了神经形态成像技术的值得注意的进步,由于其独特的优势,研究人员引起了很大的关注。但是,事件摄像机容易受到显着水平的测量噪声,这可能会对依赖于事件流的算法的性能降低,例如感知和导航。在这项研究中,我们介绍了一种新颖的方法来降级事件流,目的是填写未能准确反映出真正的对数强度变化的事件。我们的方法着重于事件的异步性质和时空特性,最终导致了新型异步时空事件的发展神经网络(ASTEDNET)。该网络直接在事件流上运行,规避将事件流转换为图像帧等密集格式的需求,从而保留其固有的异步性质。借助图形编码和时间卷积网络的原理,我们结合了时空特征注意机制,以捕获事件之间的时间和空间相关性。这可以使原始流中每个活动事件像素的分类为代表真正的强度变化或噪声。在多个数据集上针对最先进方法进行的比较评估表明,我们所提出的算法在消除噪声方面具有显着的效率和鲁棒性,同时将有意义的事件信息保留在场景中。