
XiaoMi-AI文件搜索系统
World File Search SystemLanguage

歌剧:通过过度信托的惩罚和转录分配
幻觉是对多模态大语言模型(MLLM)的普遍挑战的幻觉,极大地阻碍了他们需要精确判断的真实用法。现有方法可以通过特定设计的数据进行培训,或通过其他来源的特定知识来缓解此问题,从而产生了不可避免的额外费用。在本文中,我们提出了一种新型的MLLM解码方法,该方法基于o-vertust pe nalty和r eTroptoction-llocation策略,它是一种几乎免费的午餐,可以减轻幻觉问题,并没有其他数据,知识,知识或培训。我们的方法始于一个有趣的观察结果,即,大多数幻觉与自我注意力矩阵所表现出的知识聚集作用紧密相关,即MLLM倾向于通过关注一些摘要的代价来产生新的代币,但并非所有以前的代币。这种部分过度信任的倾向会导致忽略图像令牌,并用幻觉描述图像内容。基于观察结果,Opera在梁搜索解码过程中引入了对模型逻辑的惩罚术语,以使Miti-Gate the Trust问题以及回滚策略回顾了在预先生成的令牌中存在摘要令牌的存在,并在必要必要时重新分配给标记。通过广泛的实验,Opera在不同的MLLM和指标上表现出明显的幻觉降低性能,证明其有效性和性质。我们的代码为:https://github.com/shikiw/opera。

人工智能设备和印地语
Error 500 (Server Error)!!1500.That’s an error.There was an error. Please try again later.That’s all we know.

infinigen:具有动态KV缓存管理的大语言模型的有效生成推断
基于变压器的大语言模型(LLMS)在各种自然语言处理任务中都具有令人印象深刻的表现。为LLM推断为生成长含量而构成挑战,这是由于瞬态状态的巨大内存足迹(称为键值(KV)缓存),该状态以序列长度和批处理大小缩放。在本文中,我们提出了Infinigen,这是一种针对Longext Genertion量身定制的新型KV缓存管理框架,该框架协同与现代卸载基于卸载的推理系统合作。Infinigen利用了关键见解,即可以通过对当前层的最小彩排以及查询权重的一部分和后续层的关键缓存进行最小化的彩排来推测,对于计算变压器中后续注意力层至关重要的重要洞察力。这使我们只能预取基本的KV缓存条目(不提供所有内容),从而在基于卸载的LLM服务系统中减轻主机内存中的提取开销。我们对几种代表性LLMS的评估表明,与先前的KV高速缓存管理方法相比,Infinigen将基于现代卸载系统的总体性能提高了3.00倍,同时提供了更好的模型准确性。


欧洲通用语言数据空间
欧盟自 2019 年以来一直在实施其数据战略。1 面向工业的数据单一市场的一个关键组成部分是建立“可互操作的数据空间”以“汇集关键行业的欧洲数据”,在这个市场中“数据可以在欧盟内部和跨行业流动,造福所有人”、“欧洲规则 […] 得到充分尊重”并且“数据访问和使用规则公平、实用和明确”。欧盟委员会(2022 年)描述了一个初步的、相当粗略的概念,包括如何建立和运营这些数据空间,包括相关立法(另见 Nagel 和 Lycklama,2021 年)。该文件还列出了一些针对制造业、交通、医疗、金融、能源、农业和技能等行业的“官方”欧盟数据空间。由数字欧洲计划 (DEP) 2 中的采购合同资助的欧洲通用语言数据空间 (LDS) 就是这些官方欧盟数据空间之一。 3
lami:多模式人类机器人互动的大型语言模型
无缝的人类机器人相互作用(HRI)需要机器人对人类的多模式输入的熟练处理,包括语音,凝视和面部表情,以准确评估人类的影响并相应地提供帮助。同时,机器人必须通过多模态输出渠道清楚地将自己的意图清楚地传达给人类,包括语音,手势和凝视。传统上,在机器人系统中实现此功能通常需要复杂的设计。在意图估计的领域中,以前的研究通常合并意图识别模块,以基于多模式输入[3,17]对人类意图进行分类。一些系统还具有用于检测人类情感状态的专用模块,对于建立社会细微差别的互动至关重要[10,16,18]。但是,这些方法的缺点在于它们耗时且昂贵的培训过程。在输出方面,许多先前的系统集成了情绪状态[8,11]模块,以控制人形输出提示,例如音调,凝视或面部表情,增强了向人类反馈的透明度和生动性。关于运动产生,提出了多种方法,包括预先建立的运动集的混合和图表[19,25],以及使用运动捕获数据[5,9,15]。值得注意的是,这涉及与特定状态相关的每种输出模式的动作手动设计。通过利用文本理解,推理和计划的能力,在短时间内提出了许多机器人应用[7,12,14,20,21,28]。例如,Zhang等人。大型语言模型(LLM)的最新进展,诸如聊天机器人,数据过程和代码生成之类的域中的表现令人印象深刻的功能正在揭示其在机器人技术领域的潜在应用。其中一个通常的例子是“ Saycan”机器人[1],它能够解释人的自然语言命令,分析环境并生成具体的可执行操作序列,以通过使用LLMS来满足人类的要求。但是,机器人和人之间的互动提示仅限于语音命令,即使没有语音输出。最近,一些研究人员还试图将这种技术应用于HRI领域。利用LLM来估计人类有多少信任机器人[30]; Yoshida等人,使用LLMS生成低级控制命令来推动人形机器人运动以进行社会表达[29],而不是用于实践援助。Baermann等人,部署了LLM不仅遵循人类的言语命令,而且还通过人类的自然语言反馈来纠正其错误[2]。然而,通信主要依赖语音相互作用,而较少关注多模式感应和表达能力。ye等。[27]驱动了一个LLM驱动的机器人系统,该系统能够与人类在VR环境中的组装任务中合作。,但是该系统仅限于处理人类语言输入并控制虚拟空间中的单臂。通常,与快速
通过群集掩模的有效视力语言预训练
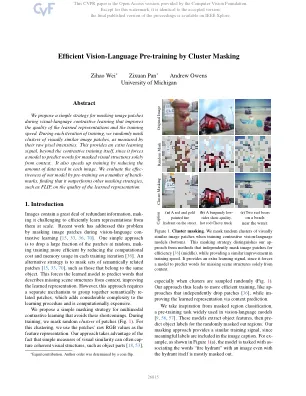
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],
基于语料库的语言教学方法
摘要 本文综合了教师的观点、学习者产出和学习者印象的分析、材料开发的想法以及总结性研究者的观察结果,这些观察源于在美国两个大学和成人留学环境中实施为期一学期(约 8 周的教学)的基于语料库和数据驱动的英语作为第二语言 (ESL) 教学。案例研究 1 调查了学习者和教师对语料库教学在培养专门为中国访问学者群体设计的学术写作技能方面的有效性的态度。案例研究 2 采用混合方法、探索性调查,研究使用支架式学生工作表指导不同熟练程度的学习者在一所位于美国的非营利性私人机构为期一学期的留学项目中使用语料库和语料库工具的情况。该工作表旨在定期将基于语料库的课程和数据纳入课堂教学或家庭作业活动。结果表明,教师们对将语料库工具纳入自己的语言课堂教学中可能带来的巨大而有希望的好处充满热情。通过具体明确的学习目标和使用指导,语料库工具可以成为课程期间和课程结束后适合学生的宝贵资源。
您说话时开车:在自动驾驶汽车中启用与大语言模型的人类互动
自动驾驶汽车的未来在于以人为中心的设计和先进的AI Capabilies。未来的自动驾驶汽车不仅会跨乘客,而且还将互动并适应他们的欲望,从而使旅程变得舒适,有效且令人愉悦。在本文中,我们提出了一个新颖的框架,该框架利用大型语言模型(LLMS)来增强自动驾驶汽车的决策过程。通过整合LLMS的自然语言能力和上下文理解,专业工具使用,协同推理,并与自动驾驶汽车的各种模块进行作用,该框架旨在将LLMS的先进语言和推理能力无缝整合到自动驾驶中。拟议的框架具有革新自动驾驶汽车运行方式,提供个性化援助,持续学习和透明决策的潜力,最终为更安全,更有效的自动驾驶技术做出了贡献。
VLP:自主驾驶的视觉语言计划
自主驾驶是一项复杂而具有挑战性的任务,旨在通过场景和推理来实现安全的运动计划。最近,通过增强的场景理解,几个关键问题,包括缺乏推理,低概括性能和长尾场景,但仍需要戴着几个关键问题,但仍需要进行一些关键问题。在本文中,我们提出了VLP,这是一个新颖的视力 - 语言规划框架,利用语言模式来弥合语言理解与自动驾驶之间的差距。VLP通过加强源内存基础和自动驾驶汽车的上下文理解来增强自主驾驶系统。vlp通过与先前的最佳方法相比,分别在平均L2错误和碰撞率方面,分别在平均L2错误和碰撞率方面实现了35.9%和60.5%的端到端规划表演。此外,在面对新的城市环境时,VLP在挑战性的长尾方案和强大的概括能力方面表现出改善的性能。