
XiaoMi-AI文件搜索系统
World File Search SystemLoco
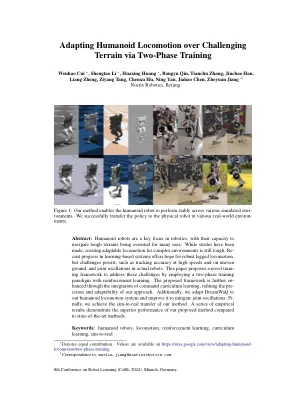
通过两相训练使类人动力运动超过具有挑战性的地形
摘要:人形机器人是机器人技术的关键重点,其导航艰难地形对于许多用途至关重要。虽然取得了进步,但为复杂环境创建适应性的运动仍然很困难。基于学习的系统的进展为强大的腿部运动提供了希望,但挑战持续存在,例如在高速和不平衡的地面跟踪准确性,以及实际机器人的关节振荡。本文提出了一个新颖的培训框架,以通过强化学习采用两阶段的训练范式来应对这些挑战。通过整合命令课程学习,完善我们方法的预知和适应性,进一步构成了所提出的框架。此外,我们将Dreamwaq适应了我们的人形运动系统,并将其改进以减轻关节振荡。,我们实现了我们方法的SIM到真实传输。一系列经验结果表明,与最先进的方法相比,我们提出的方法的出色表现。

对局部疗法的完全反应加上肝细胞癌的免疫疗法
结果共有63例患者(58名男性[92.1%];中位年龄,69岁[范围,18 - 90年]); 38例患者(60.3%)患有大血管浸润,中位肿瘤直径为10 cm(范围3.8-31.1 cm)。中位随访时间为34.7个月(95%CI,6.5-64.6个月)。29例患者(46.0%)获得了CR。获得CR的患者的3年OS率明显高于未达到CR的患者(75.5%[95%CI,58.2%-98.3%] vs 28.1%[95%CI,7.4%-29.4%]; P <.001)。在29例CR患者中,3年的临时率为58.7%(95%CI,38.7%-79.1%),而3年的局部控制率为90.5%(95%CI,78.2%-100%)。十名患者(34.5%)出现复发;其中,有6例(60.0%)患有孤独的肝内疾病复发接受了治疗性手术治疗。缺乏肿瘤血管浸润(优势比,0.30; 95%CI,0.10-0.89),最大的病变直径为8 cm或更低的病变直径(优势比,0.26; 95%CI,0.07-0.98)与CR相关。

LGB“Porter”电池转换装置与 Loco Remote 配合使用
5. 如果您还没有平衡充电器,请购买适用于 LiPo 或锂电池的平衡充电器。它们可以使用 5V 以上的任何电压,因为它们可以单独为每个电池充电,但通常需要 12V 输入。它们内置有保护电路,可在电池充满时关闭。6. 少量红色和黑色电缆以及各种尺寸的热缩管。“Porter”的电流小于 1 安培,因此它们不需要像遥控汽车线路那样庞大。7. 2A 可复位聚合物保险丝。在线搜索 - 这是一种非常便宜且方便的自复位安全装置,如果有损坏,它将保护一切。8. 一个锁定按钮开/关开关。我选择这个来安装在机车圆顶内,如果您想将它放在其他地方,例如驾驶室,也可以使用杠杆开关。
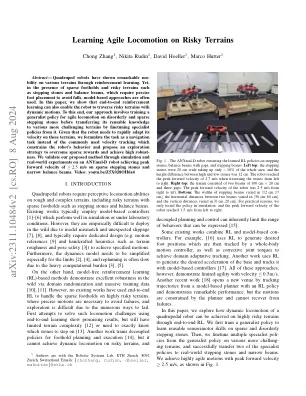
在风险地形上学习敏捷运动
摘要 - 四倍的机器人通过强化学习在各种地形上表现出了显着的能力。然而,在存在稀疏的立足点和危险的地形(例如步进石材和平衡梁)的情况下,需要精确的脚部放置以避免跌倒,经常使用基于模型的方法。在本文中,我们表明端到端的强化学习还可以使机器人能够通过动态动作遍历风险的地形。为此,我们的方法涉及培训一项通才政策,以实现无序和稀疏的垫脚石的敏捷运动,然后通过将其可重复使用的知识从中转移到更具挑战性的地形上。鉴于机器人需要在这些地形上快速调整其速度,我们将任务作为导航任务而不是常用的速度跟踪,从而限制了机器人的行为并提出探索策略来克服稀疏的奖励并实现较高的健壮性。我们通过在Anymal-D机器人上进行模拟和现实实验来验证我们提出的方法,从而达到峰值前进速度≥2。5 m/s在稀疏的垫脚石和狭窄的平衡梁上。视频:youtu.be/z5x0j8oh6z4

aign-aigment MPC敏捷和强大的脚步运动计划和控制
摘要 - 本文提出了一种在线两足动物的脚步计划策略,该策略结合了模型预测性控制(MPC)和增强学习(RL),以实现敏捷且健壮的两足动物。基于MPC的脚部放置控制器已经证明了它们在实现动态运动方面的有效性,但它们的性能通常受到使用简化模型和假设的限制。为了应对这一挑战,我们开发了一个新颖的脚放置控制器,该控制器利用了一项学识渊博的政策来弥合使用简化模型和更复杂的全阶机器人系统之间的差距。具体来说,我们的方法采用了基于ALIP的MPC脚部放置控制器的独特组合,用于次级脚步计划,并提供了精炼脚步调整的学习政策,从而使所得的脚步策略有效地捕获了机器人的全身动态。这种集成协同MPC的预测能力,其灵活性和适应性能力。我们通过使用全身人形机器人Draco3。结果表明,动态运动性能的显着改善,包括更好地跟踪各种步行速度,使可靠的转弯和穿越具有挑战性的地形,同时与基线ALIP ALIP ALIP MPC接近相比,保持步行步态的稳健性和稳定性。

胆管癌全身治疗和局部区域治疗的最新趋势
1 休斯顿卫理公会医院休斯顿卫理公会尼尔癌症中心胃肠道肿瘤科,德克萨斯州休斯顿 77030,美国 2 耶鲁纽黑文健康中心、布里奇波特医院内科部,康涅狄格州布里奇波特 06610,美国 3 阿尔玛雷法大学医学院,利雅得 11597,沙特阿拉伯 4 亚利桑那州立大学扎克曼公共卫生学院,亚利桑那州坦佩 85287,美国; bushrayalmiqlash11@gamil.com 5 德克萨斯大学 MD 安德森癌症中心癌症医学部胃肠肿瘤内科系,美国德克萨斯州休斯顿 77030 6 萨那科技大学医学与健康科学学院,也门 PO Box 15201-13064 7 Prolato 临床研究中心,美国德克萨斯州休斯顿 77054 8 沙漠地区医疗中心医学部,美国加利福尼亚州棕榈泉 92262 9 德克萨斯大学 MD 安德森癌症中心内科部,美国德克萨斯州休斯顿 77030 10 约旦大学医学院胃肠病学与肝病学系,约旦安曼 11942 * 通信地址:AEsmail@houstonmethodist.org
增强运动多代理系统中的聚合
摘要通常使用各种方法来处理多代理系统中集体行为的综合,而进化算法最为普遍。在这些系统中,代理商与同龄人进行了当地的互动,并集体采用在小组层面上表现出的策略,类似于在动物社会中看到的社会行为。,我们将是Pybullet仿真工具的一部分的蚂蚁问题扩展到了涉及一组五个同质机器人的集体场景,以在运动过程中汇总。为了发展这种行为,我们与多目标健身函数一起使用了OpenAI-ES算法。我们的发现表明,尽管机器人发展了成功的运动行为,但它们并未表现出汇总。这种差异归因于设计选择,这些选择无意间强调了对聚合能力的运动。我们讨论了健身函数引起的动态相互作用,以验证我们的结果并概述未来的方向。最终,我们的目标是第一次尝试建立一个在现代模拟环境中使用高级算法分析集体行为的框架。
用于加强学习运动任务的开环基线
为了寻找运动任务中深度强化学习的简单基线,我们提出了一种无模型的开环策略。通过利用先验知识和简单振荡器的优雅来产生周期性的关节动作,它在五个不同的运动环境中实现了可观的性能,其中许多可调参数是DRL算法通常所需的数千分之一。我们使用开环振荡器进行了两个其他实验,以确定这些算法的当前缺点。我们的结果表明,与基线相比,DRL暴露于传感器噪声或故障时,DRL更容易降解。此外,我们使用弹性四足动物展示了从模拟到现实的成功转移,其中RL在没有随机或奖励工程的情况下失败。总体而言,拟议的基线和协会实验突出了DRL在机器人应用中的现有局限性,提供了有关如何解决它们的见解,并鼓励对复杂性和一般性的成本进行反思。
分析用于仿真的最新四足球控制器
1。论文的目的是比较在模拟中实施的几个最新的四倍的运动控制器,制定指南,表明哪种控制器在哪种情况下更好,最后,实施一个示例决策策略,该示例可以根据当前上下文进行切换。2。最初,学生应审查四倍运动控制器的可用文献和实施。3。接下来,学生应创建必要的应用程序,以便在同一模拟器中运行所有控制器以进行公平比较。学生应设计适当的模拟场景,该场景将用于比较控制器。4。学生应提出和评估合适的指标,以便为给定任务选择最佳控制器。应从比较结果中提取一个简单的面向用户指南。5。最后,学生应实施一种上下文感知的策略,该策略将能够在多个运动控制器之间切换,以在某些设计的方案中实现设计指标的卓越性能。

RL2AC:基于增强学习的快速在线自适应控制机器人强大的运动
摘要 - 动态快速适应是使动物及时,正确调整其运动的基本帽质体之一,从而对不可预测的变化做出了反应。在不预测的环境中工作时,这种功能对于四倍的机器人也是必不可少的。虽然增强学习(RL)在运动控制方面取得了重大进展,但对模型不确定性的快速适应仍然是一个挑战。在本文中,我们试图确定运动RL政策背后的控制机制,我们从中提出了一种新的基于RL的快速在线自适应控制(RL2AC)算法,以互补地将RL策略和自适应控制结合在一起。RL2AC以1000Hz的频率运行,而无需使用RL同时训练。它具有针对外部干扰或SIM真实间隙的强大能力,从而实现了强大的运动,这是通过从新颖的自适应控制器中得出的适当扭矩补偿来实现的。各种模拟和实验证明了提出的RL2AC针对重载重的有效性,干扰作用在一条腿上,侧向扭矩,SIM卡到真实的间隙和各种地形。