
XiaoMi-AI文件搜索系统
World File Search SystemAda

摄像机-LLM系统的域适应技术
针对摄像机-LLM系统的域适应技术DOCAS AKINYELE,GODWIN OLAOYE日期:2024摘要:将来自相机的视觉数据与语言模型集成的视觉数据的摄像机模型(摄像头)对于各种应用至关重要,包括各种应用,包括实时图像字幕字幕,对象识别,对象识别,互动AI II系统。但是,这些系统通常由于域的变化而面临挑战 - 相机硬件的差异,环境条件和语言上下文变化。域适应技术通过使模型能够在培训和部署环境方面有效地跨不同领域执行,以解决此问题。本文探讨了与摄像机-LLM系统相关的关键领域适应技术。它涵盖了数据增强,功能一致性,对抗性训练,转移学习和生成模型。此外,它研究了这些技术如何减轻相机数据中变异性的影响并改善视觉输入和语言生成之间的交叉形态对齐。本文还讨论了诸如实时字幕,对象检测和AR/VR等应用程序,以及评估适应性绩效的评估指标。未来的方向指向多域适应性,自适应学习技术和人类在循环系统中。这些进步有望为真实应用程序提供更健壮和广义的摄像头系统。简介摄像机模型(摄像机-LLM)系统代表了视觉感知和自然语言理解的集成方面的重大进步。通过将通过相机捕获的图像数据与复杂的语言模型相结合,这些系统可实现一系列应用程序,从实时图像字幕和对象检测到交互式AI和增强现实体验。随着人工智能的能力继续增长,可以在各种环境中无缝运行的强大摄像头系统的需求变得越来越重要。

计划气候变化改编计划
国家气候政策立场建立了“到2050年实现竞争性,低碳,气候富裕和环境可持续经济的基本国家目标”。它将国家适应框架(NAF)确定为阐明战略政策环境的关键支柱,目的是通过将适应性措施纳入适当的投资计划,以确保采取和实施适当的投资计划,并在适当的地方进行适当的投资,以管理和管理部门和当地易受气候变化的影响。NAF通过确定一项措施来确保气候验证考虑因素已完全融入爱尔兰2040年国家规划框架,该计划在该项目下,国家发展计划和所有新的OPW资助的洪水救济计划。
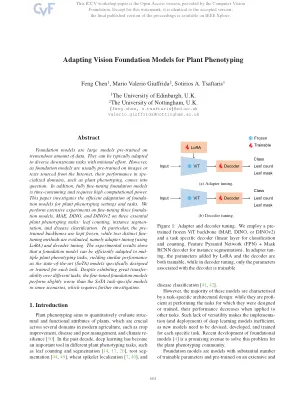
适应植物表型的视觉基础模型
基础模型是对大量数据进行预训练的大型模型。通常可以以最小的努力来适应各种下游任务。但是,由于基础模型通常是在从互联网中提出的图像或文本上进行预培训的,因此它们在植物表型等植物域中的性能受到质疑。此外,完全调整基础模型是耗时的,需要高计算能力。本文研究了植物表型设置和任务的基础模型的有效适应。我们对三个基础模型(MAE,Dino和Dinov2)进行了大量实验,对三个必需的植物表型任务:叶子计数,实例阶段和疾病分类。特别是,预先训练的骨干被冷冻,同时评估了两种不同的调整方法,即适配器调整(使用lora)和解码器调整。实验结果表明,基础模型可以充分地适应植物表型任务,从而产生与针对每个任务的最先进的模型(SOTA)模型相似的性能。尽管在不同任务上表现出很高的传递能力,但在某些情况下,精细调整的基础模型的表现比SOTA任务特定的模型稍差,这需要进一步研究。
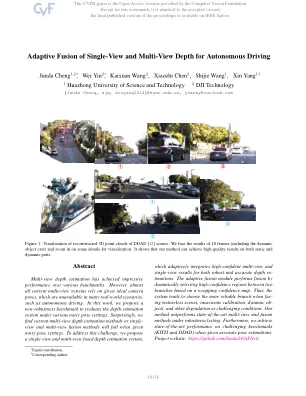
自动驾驶的单视图和多视图深度的自适应融合
来自图像的深度估计是具有广泛应用的计算机视觉中的一个长期问题。对于基于视觉的自动驾驶系统,感知深度是理解道路对象和建模3D环境图的相关性的不可或缺的模块。由于深度神经网络用于求解各种视觉概率,因此基于CNN的方法[2-5,13,39 - 42,44,44,46,48,52]主导了各种深度基准。根据输入格式,它们主要将其分为多视图深度估计[3,13,23,26,44,45,51,53]和单视深度估计[14 - 16,19,37,38]。多视图方法估计深度的假设,即给定的深度,相机校准和摄像头姿势,这些像素应相似。他们依靠表现几何形状来三角形高质量深度。但是,多视图方法的准确性和鲁棒性在很大程度上依赖于相机的几何配置以及视图之间匹配的对应关系。首先,需要足够翻译相机以进行三角度。在自主驾驶的情况下,汽车可能会停在交通信号灯处或不移动而不移动,这会导致故障三角剖分。此外,多视图方法遭受动态对象和无动电区域的影响,它们在自动驱动方案中无处不在。另一个问题是对移动车辆的施加优化。在存在的大满贯方法中不可避免地噪声,更不用说具有挑战性和可取的情况了。具体来说,我们提出了一个两个分支网络,即例如,一辆机器人或自动驾驶汽车可以在不重新校准的情况下部署多年,原因是嘈杂的姿势。相比之下,作为单视图方法[14 - 16,19,37,38]依赖于对场景的语义理解和透视投影提示,它们对无纹理区域,动态对象,而不是依赖相机姿势更为易用。但是,由于规模歧义,其性能仍然远非多视图方法。在这里,我们倾向于考虑是否可以很好地结合两种方法的好处,以实现自主驾驶场景中的稳健和准确的单眼视频深度估计。尽管已经在先前的工作中探索了基于融合的系统[1,9],但他们都假定了理想的相机姿势。结果是融合系统的性能甚至比单视深度估计的噪声姿势还差。为了解决这个问题,我们提出了一个新型的自适应融合网络,以利用多视图和单视图方法的优势,并减轻其缺点,以保持高度的精度,并在噪声姿势下提高系统的影响力。一个靶向单眼深度提示,而另一个则利用多视图几何形状。两个分支都预测了深度图和置信图。补充语义提示和边缘细节在多视图分支的成本汇总中丢失了

PanCAP 改编 U .美国政府新冠疫情
2 月 10 日,应 HHS 的要求,FEMA 向 ASPR 派驻了一个团队,以支持危机行动计划、态势感知和行动协调。国土安全部国家行动中心 (NOC)、国土安全部联合事件咨询小组 (JIAG) 和美国海岸警卫队 (USCG) 的联络官 (LNO) 与该团队共处一地。紧急支援职能 (ESF) #1 运输、ESF #6 大规模护理、紧急援助、临时住房和人力援助、ESF #13 公共安全、ESF #14 跨部门业务和基础设施以及 ESF #15 外部事务的联络员也已启动,以支持正在进行的响应行动。当前的协调结构如图 2 所示。

YM155 适应的癌细胞系揭示药物
摘要:Survivin 是一种药物靶点,其抑制剂 YM155 是一种主要用于治疗高危神经母细胞瘤的候选药物。神经母细胞瘤细胞系 UKF-NB-3 的一个 YM155 适应亚系的研究结果表明,ABCB1(介导 YM155 外排)水平升高、SLC35F2(介导 YM155 摄取)水平降低、Survivin 水平降低和 TP53 突变表明 YM155 耐药。在此,对另外 10 个 YM155 适应 UKF-NB-3 亚系的研究仅证实了 ABCB1 和 SLC35F2 的作用。然而,细胞 ABCB1 和 SLC35F2 水平并不表明 YM155 幼稚细胞对 YM155 敏感,如来自癌症治疗反应门户 (CTRP) 和癌症药物敏感性基因组学 (GDSC) 数据库的药物反应数据所示。此外,耐药亚系具有显著的异质性。只有七个亚系产生了靶向耐药性,这表现为对 RNAi 介导的 survivin 耗竭的耐药性。这些亚系对其他抗癌药物的反应也各不相同。总之,内在异质性有限的癌细胞群在治疗后会形成各种耐药表型。因此,个性化治疗需要监测癌细胞在治疗后的演变。此外,生物标志物可以在获得性耐药环境中指示耐药性的形成,即使在内在耐药环境中无法预测。

IHS和638部落药房Markay Adams AHCCC
主题:2020年8月31日星期一的3年至18岁的流感疫苗管理会员杜西(Ducey)州长杜西(Ducey)举行了一场新闻发布会,说明所有亚利桑那州人的重要性都为即将到来的流感季节获得流感疫苗。新闻发布会的重点是该州在今年秋天和冬季提高流感疫苗接种率的努力:https://azgovernor.gov/governor/news/2020/2020/08/governor-ducey-and-health-health-lealth-leads-health-leaders-u rge-u rge-u rge-arizonans-get-flu-shot。该机构一直在努力扩大对流感疫苗管理的机会,该扩展允许3至18岁的费用服务(FFS)成员现在在IHS,638个部落或其他optum Network Network Pharmacy中获得流感疫苗。希望在药房获得流感疫苗的AHCCCS收费服务的所有成员都必须使用属于Optum FFS药房网络一部分的药房。根据A.R.S.的流感疫苗§32-1974可以由批准在批准的药剂师监督下对3岁及以上的儿童进行卫生和实习生的药剂师管理。我们认识到,IHS/638部落药剂师可能不会在亚利桑那州药房注册,但是,必须对其进行培训以提供免疫接种和紧急药物。为了澄清,在药房中只能给3岁至18岁的儿童和青少年流感疫苗。对于扩展的年龄组,我们预计高剂量疫苗的利用不足。3至18岁的成员需要将其他疫苗重定向到其初级保健提供者。必须通过儿童疫苗(VFC)获得该年龄段的初级保健提供者。有关VFC计划和计费要求的更多信息,请参阅IHS/638计费手册(第146页)。

通过粗到精特征自适应实现跨域目标检测
近年来,基于深度学习的目标检测取得了长足的进步。然而,由于域转移问题,将现成的检测器应用于看不见的域会导致性能大幅下降。为了解决这个问题,本文提出了一种新的由粗到细的特征自适应方法用于跨域目标检测。在粗粒度阶段,与文献中使用的粗糙的图像级或实例级特征对齐不同,采用注意机制提取前景区域,并通过在公共特征空间中多层对抗学习根据其边缘分布进行对齐。在细粒度阶段,我们通过最小化来自不同域但属于同一类别的全局原型的距离来进行前景的条件分布对齐。由于这种由粗到细的特征自适应,前景区域中的领域知识可以得到有效的迁移。在各种跨域检测场景中进行了大量的实验。结果是最先进的,证明了所提出方法的广泛适用性和有效性。

视频的自我监督和自适应的面部聚类
1。一种自我监督的模型登录方法,仅取决于正面匹配对以改善面部嵌入。2。面部聚类的基于深度学习的相似性度量,该指标会自动适应给定模型的学习嵌入空间。3。不需要任何用户输入参数的全自动视频面聚类算法。4。发布电影脸聚类基准数据集,称为MoviefaceCluster,该数据集提供了电影域中存在的极端挑战的面部聚类场景。